Hugging Face-ის მასშტაბური პროექტი: ხელოვნური ინტელექტის ახალი ეტაპი წინადადებების გაგებაში
Hugging Face-მა, Google-ის JAX/Flax-ის გუნდთან თანამშრომლობით, შეიმუშავა წინადადებების ჩაშენების უახლესი მოდელები პროექტის „Train the Best Sentence Embedding Model Ever with 1B Training Pairs“ ფარგლებში. პროექტი იყენებდა Google-ის 7 TPU v3-8 ერთეულს და ინოვაციურ კონტრასტულ სწავლებას, რათა მსგავსი მნიშვნელობის მქონე წინადადებები ახლო ვექტორებად ასახოს, განსხვავებული მნიშვნელობის მქონე წინადადებები კი – შორეულ ვექტორებად. ეს მიღწევა მნიშვნელოვნად აუმჯობესებს ბუნებრივი ენის დამუშავების (NLP) სისტემ
პროექტის „Train the Best Sentence Embedding Model Ever with 1B Training Pairs“ ფარგლებში, ჩვენ შევიმუშავეთ წინადადებების ჩაშენების (sentence embedding) უახლესი მოდელები. ეს პროექტი ჩატარდა Hugging Face-ის მიერ ორგანიზებული საზოგადოებრივი კვირეულის განმავლობაში, რომლის ფარგლებშიც JAX/Flax გამოიყენებოდა ბუნებრივი ენის დამუშავებისა (NLP) და კომპიუტერული ხედვის (CV) ამოცანებისთვის. პროექტის განსახორციელებლად ჩვენ ვისარგებლეთ ეფექტიანი აპარატული ინფრასტრუქტურით – 7 TPU v3-8 ერთეულით, ასევე მივიღეთ ღირებული რჩევები Google-ის Flax, JAX და Cloud გუნდის წევრებისგან, რომლებიც ღრმა სწავლების ეფექტიან ფრეიმვორკებზე მუშაობენ!
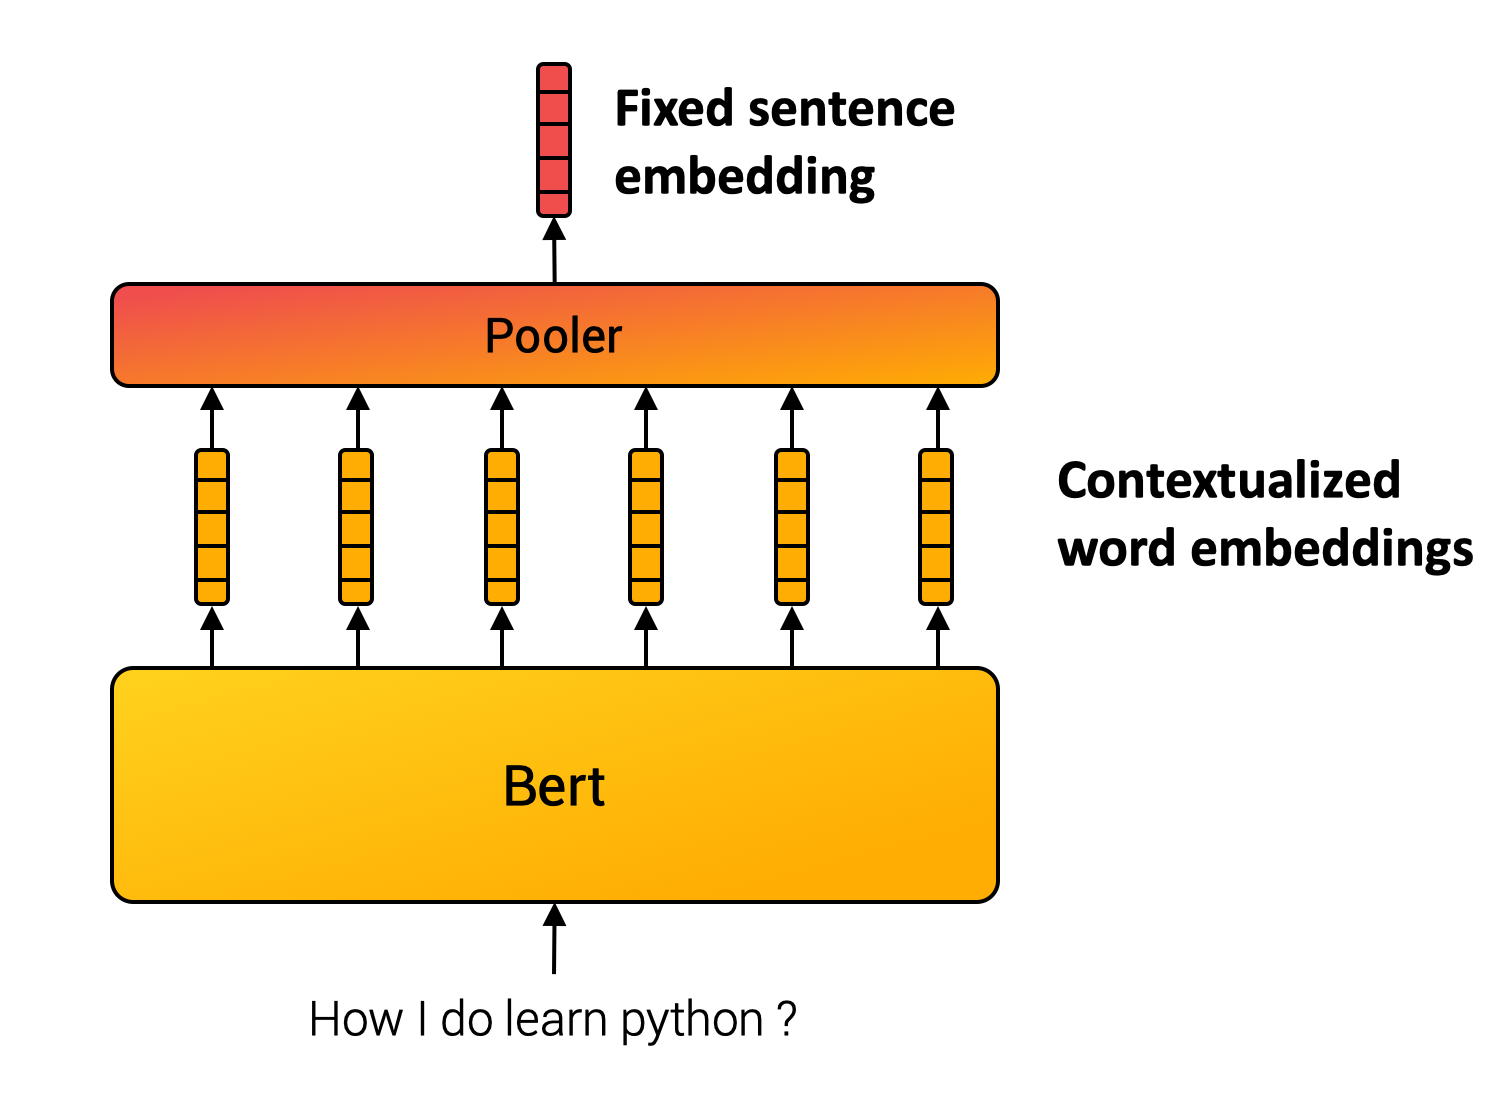
სიტყვებისგან განსხვავებით, წინადადებების სასრული ნაკრების განსაზღვრა შეუძლებელია. ამიტომ, წინადადებების ჩაშენების მეთოდები ქმნიან საბოლოო წარმოდგენას შიდა სიტყვების კომბინაციით. მაგალითად, SentenceBert მოდელი (Reimers and Gurevych, 2019) იყენებს ტრანსფორმერს (Transformer), რომელიც მრავალი NLP აპლიკაციის ქვაკუთხედია, რასაც მოსდევს კონტექსტუალიზებული სიტყვების ვექტორებზე პულინგის ოპერაცია (pooling operation). (იხ. ქვემოთ მოცემული სურათი.) კომპოზიციური მოდულის პარამეტრები, როგორც წესი, თვითკონტროლირებადი (self-supervised) მიზნის გამოყენებით ითვისება.
პროექტისთვის ჩვენ გამოვიყენეთ კონტრასტული სწავლების მეთოდი, რომელიც ქვემოთ მოცემულ სურათზეა ნაჩვენები. ჩვენ შევქმენით მონაცემთა ნაკრები წინადადებების წყვილებით (ai,pi), ისე რომ წყვილში შემავალ წინადადებებს ჰქონდეთ მსგავსი მნიშვნელობა. მაგალითად, განვიხილავდით წყვილებს, როგორიცაა (შეკითხვა, პასუხი-ნაწყვეტი), (შეკითხვა, დუბლირებული შეკითხვა), (სტატიის სათაური, ციტირებული სტატიის სათაური). შემდეგ ჩვენი მოდელი იწვრთნება, რათა (ai,pi) წყვილები ახლო ვექტორებად ასახოს, ხოლო შეუსაბამო წყვილები (ai,pj),i≠j – შორეულ ვექტორებად ჩაშენების სივრცეში. სწავლების ამ მეთოდს ასევე უწოდებენ სწავლებას in-batch negatives-ით, InfoNCE-ით ან NTXentLoss-ით.
ფორმალურად, სასწავლო ნიმუშების პაკეტის (batch) გათვალისწინებით, მოდელი ოპტიმიზაციას უკეთებს დანაკარგის შემდეგ ფუნქციას: −1n∑i=1nexp(sim(ai,pi))∑jexp(sim(ai,pj)). ქვემოთ მოცემულია თვალსაჩინო მაგალითი. მოდელი ჯერ ჩაშენებს პაკეტში შემავალი თითოეული წყვილის თითოეულ წინადადებას. შემდეგ, ჩვენ გამოვთვლით მსგავსების მატრიცას ყველა შესაძლო წყვილს (ai,pj) შორის. ამის შემდეგ მსგავსების მატრიცას ვადარებთ „ჭეშმარიტებას“ (ground truth), რომელიც მიუთითებს ორიგინალ წყვილებზე. საბოლოოდ, შედარებას ვახორციელებთ cross entropy loss-ის გამოყენებით. ინტუიციურად, მოდელმა მაღალი მსგავსება უნდა მიანიჭოს წინადადებებს „რამდენი ადამიანი ცხოვრობს ბერლინში?“ და „ბერლინში დაახლოებით 3.5 მილიონი ადამიანი ცხოვრობს“, ხოლო დაბალი მსგავსება – სხვა უარყოფით პასუხებს, როგორიცაა „საფრანგეთის დედაქალაქი პარიზია“, როგორც ეს ქვემოთ მოცემულ სურათზეა დეტალურად აღწერილი.
დანაკარგის განტოლებაში, sim აღნიშნავს მსგავსების ფუნქციას (a,p) წყვილებს შორის. მსგავსების ფუნქცია შეიძლება იყოს კოსინუსური მსგავსება (Cosine-Similarity) ან წერტილოვანი ნამრავლის ოპერატორი (Dot-Product operator). ორივე მეთოდს აქვს თავისი დადებითი და უარყოფითი მხარეები (Thakur et al., 2021, Bachrach et al., 2014): პრაქტიკაში, ჩვენ გამოვიყენეთ მასშტაბირებული მსგავსება (scaled similarity), რადგან ქულათა განსხვავებები ხშირად ძალიან მცირეა, და ვიყენებთ მასშტაბირების ფაქტორს C, ისე რომ simscaled(a,b)=C∗sim(a,b), სადაც C, როგორც წესი, 20-ის ტოლია (Henderson and al., 2020, Radford and al., 2021). ჩვენს მეთოდში, ჩვენ ვქმნით ნიმუშის წყვილების (ai,pi) პაკეტებს. პაკეტის ყველა სხვა ნიმუშს, (ai,pj),i≠j, განვიხილავთ, როგორც უარყოფით ნიმუშთა წყვილებს (negatives sample pairs). ამიტომ, პაკეტის შედგენა სწავლების ძირითადი ასპექტია. სფეროში არსებული ლიტერატურის გათვალისწინებით, ჩვენ ძირითადად ფოკუსირებული ვიყავით პაკეტის სამ მთავარ ასპექტზე. კონტრასტულ სწავლებაში, უფრო დიდი პაკეტის ზომა (batch size) უკეთეს მუშაობას ნიშნავს. როგორც ნაჩვენებია Qu და სხვების ნაშრომიდან (2021) აღებულ სურათზე, უფრო დიდი პაკეტის ზომა აუმჯობესებს შედეგებს.
იმავე სურათზე ვხედავთ, რომ „რთული უარყოფითი“ (hard negatives) მაგალითების ჩართვა ასევე აუმჯობესებს მუშაობას. რთული უარყოფითი მაგალითებია ისეთი ნიმუშები pj, რომელთა გარჩევა pi-ისგან რთულია. ჩვენს მაგალითში, ეს შეიძლება იყოს წყვილები „რომელია საფრანგეთის დედაქალაქი?“ და „რომელია აშშ-ის დედაქალაქი?“, რომლებსაც ახლო სემანტიკური შინაარსი აქვთ და სწორი პასუხის გასაცემად წინადადების ზუსტ გაგებას მოითხოვს. პირიქით, ნიმუშები „რომელია საფრანგეთის დედაქალაქი?“ და „რამდენი ვარსკვლავური ომების ფილმი არსებობს?“ ნაკლებად რთულია გასარჩევად, რადგან ისინი სხვადასხვა თემას ეხება.
ჩვენი მოდელების გასაწვრთნელად მრავალი მონაცემთა ნაკრები გავაერთიანეთ. შევქმენით დიდი პაკეტი და შევაგროვეთ ნიმუშები ერთი და იმავე პაკეტის მონაცემთა ნაკრებიდან, რათა შეგვეზღუდა თემების განაწილება და ხელი შეგვეწყო რთული უარყოფითი მაგალითებისთვის. თუმცა, ჩვენ ასევე ავურიეთ მინიმუმ ორი მონაცემთა ნაკრები პაკეტში, რათა შეგვესწავლა გლობალური სტრუქტურა თემებს შორის და არა მხოლოდ ლოკალური სტრუქტურა ერთი თემის ფარგლებში. როგორც უკვე აღვნიშნეთ, მონაცემთა რაოდენობა და პაკეტის ზომა პირდაპირ გავლენას ახდენს მოდელის მუშაობაზე. პროექტის ფარგლებში, ჩვენ ვისარგებლეთ ეფექტიანი აპარატული ინფრასტრუქტურით. ჩვენი მოდელები გავწვრთნეთ TPUs-ზე, რომლებიც Google-ის მიერ შემუშავებული გამომთვლელი ერთეულებია და სუპერ ეფექტიანია მატრიცული გამრავლებისთვის. TPUs-ს აქვს გარკვეული აპარატული სპეციფიკა, რამაც შესაძლოა კონკრეტული კოდის იმპლემენტაცია მოითხოვოს. გარდა ამისა, ჩვენ მოდელები გავწვრთნეთ დიდ კორპუსზე, რადგან გავაერთიანეთ მრავალი მონაცემთა ნაკრები, საერთო ჯამში 1 მილიარდამდე...
თეგები:
#ხელოვნური ინტელექტი
#google
#მანქანური სწავლება
#ღრმა სწავლება
#hugging face
#jax
#nlp
#tpu
#flax
#წინადადებების ჩაშენება
#კონტრასტული სწავლება
წყარო: huggingface.co
AI-ით გადამუშავებული


