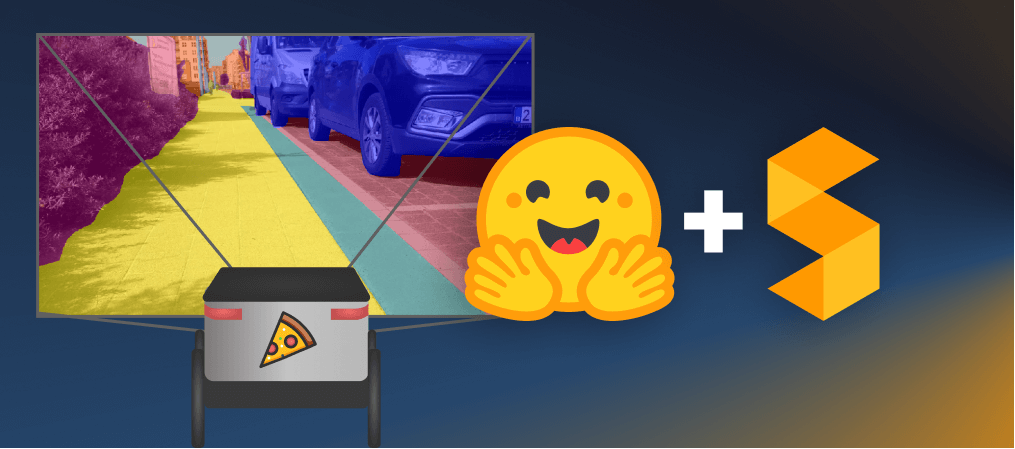
სემანტიკური სეგმენტაცია SegFormer-ით: ავტონომიური სისტემების გაუმჯობესება
სემანტიკური სეგმენტაცია გამოსახულების თითოეული პიქსელის კლასიფიკაციის ამოცანაა, რაც გამოსახულების ანალიზის უფრო ზუსტი მეთოდია. მას ფართო გამოყენება აქვს ისეთ სფეროებში, როგორიცაა სამედიცინო გამოსახულება და ავტონომიური მართვა. სტატია განიხილავს SegFormer მოდელს, რომელიც იყენებს ტრანსფორმერებს სემანტიკური სეგმენტაციისთვის და წარმოადგენს უახლეს მიღწევებს ამ სფეროში. ნაჩვენებია, თუ როგორ იქმნება და მუშავდება სპეციალიზებული მონაცემთა ნაკრები პიცის მიმწოდებელი რობოტისთვის, რაც უზრუნველყოფს მის ეფექტურ
სემანტიკური სეგმენტაცია არის გამოსახულებაში თითოეული პიქსელის კლასიფიკაციის ამოცანა. მისი აღქმა შეიძლება, როგორც გამოსახულების კლასიფიკაციის უფრო ზუსტი მეთოდი. მას გამოყენების ფართო სპექტრი აქვს ისეთ სფეროებში, როგორიცაა სამედიცინო გამოსახულება და ავტონომიური მართვა. მაგალითად, ჩვენი პიცის მიმწოდებელი რობოტისთვის მნიშვნელოვანია ზუსტად იცოდეს, სად მდებარეობს ტროტუარი გამოსახულებაზე და არა მხოლოდ ის, არის თუ არა იქ ტროტუარი. რადგან სემანტიკური სეგმენტაცია კლასიფიკაციის ტიპია, გამოსახულების კლასიფიკაციისა და სემანტიკური სეგმენტაციისთვის გამოყენებული ქსელური არქიტექტურები ძალიან მსგავსია. 2014 წელს, Long და სხვების ფუნდამენტურ ნაშრომში გამოყენებული იქნა კონვოლუციური ნერვული ქსელები სემანტიკური სეგმენტაციისთვის. უფრო მოგვიანებით, ტრანსფორმერები გამოიყენეს გამოსახულების კლასიფიკაციისთვის (მაგ. ViT), ახლა კი ისინი ასევე გამოიყენება სემანტიკური სეგმენტაციისთვის, რაც კიდევ უფრო ავითარებს სფეროს უახლეს მიღწევებს. SegFormer არის სემანტიკური სეგმენტაციის მოდელი, რომელიც Xie და სხვების მიერ 2021 წელს იქნა წარმოდგენილი. მას აქვს იერარქიული ტრანსფორმერ ენკოდერი, რომელიც არ იყენებს პოზიციურ ენკოდირებას (ViT-ისგან განსხვავებით) და მარტივი მრავალშრიანი პერცეპტრონის დეკოდერი. SegFormer აღწევს უახლეს შედეგებს მრავალ საერთო მონაცემთა ნაკრებზე. ვნახოთ, როგორ მუშაობს ჩვენი პიცის მიმწოდებელი რობოტი ტროტუარის გამოსახულებებზე.
დავიწყოთ საჭირო დამოკიდებულებების ინსტალაციით. იმის გამო, რომ ჩვენ ვაპირებთ ჩვენი მონაცემთა ნაკრებისა და მოდელის Hugging Face Hub-ში ატვირთვას, გვჭირდება Git LFS-ის ინსტალაცია და Hugging Face-ში შესვლა. git-lfs-ის ინსტალაცია შეიძლება განსხვავებული იყოს თქვენს სისტემაზე. აღსანიშნავია, რომ Google Colab-ს აქვს Git LFS წინასწარ დაინსტალირებული. ნებისმიერი ML პროექტის პირველი ნაბიჯი არის კარგი მონაცემთა ნაკრების შეგროვება. სემანტიკური სეგმენტაციის მოდელის საწვრთნელად, გვჭირდება მონაცემთა ნაკრები სემანტიკური სეგმენტაციის ეტიკეტებით. ჩვენ შეგვიძლია გამოვიყენოთ არსებული მონაცემთა ნაკრები Hugging Face Hub-იდან, როგორიცაა ADE20k, ან შევქმნათ ჩვენი საკუთარი მონაცემთა ნაკრები გამოსახულებების ანოტირებით შესაბამისი სეგმენტაციის რუკებით. ჩვენი პიცის მიმწოდებელი რობოტისთვის შეგვეძლო გამოგვეყენებინა არსებული ავტონომიური მართვის მონაცემთა ნაკრები, როგორიცაა CityScapes ან BDD100K. თუმცა, ეს მონაცემთა ნაკრებები გზაზე მოძრავი მანქანების მიერ იყო შეგროვებული. ვინაიდან ჩვენი მიმწოდებელი რობოტი ტროტუარზე იმოძრავებს, იქნება შეუსაბამობა ამ მონაცემთა ნაკრებებში არსებულ გამოსახულებებსა და იმ მონაცემებს შორის, რომლებსაც ჩვენი რობოტი რეალურ სამყაროში იხილავს. არ გვინდა, რომ ჩვენი მიმწოდებელი რობოტი დაიბნეს, ამიტომ შევქმენით ჩვენი საკუთარი სემანტიკური სეგმენტაციის მონაცემთა ნაკრები ტროტუარებზე გადაღებული გამოსახულებების გამოყენებით. ის ხელმისაწვდომია segments/sidewalk-semantic-ზე. ეს შეიძლება გაკეთდეს ანოტირების პლატფორმების გამოყენებით, როგორიცაა CVAT ან Segments.ai. ჩვენ აქ ჩავტვირთავთ სრულ ეტიკეტირებულ ტროტუარის მონაცემთა ნაკრებს. გაითვალისწინეთ, რომ მაგალითების ნახვა შეგიძლიათ პირდაპირ თქვენს ბრაუზერში.
ახლა, როდესაც შევქმენით ახალი მონაცემთა ნაკრები და ავტვირთეთ ის Hugging Face Hub-ში, შეგვიძლია ჩავტვირთოთ მონაცემთა ნაკრები ერთი ხაზით. ავურიოთ მონაცემთა ნაკრები და გავყოთ ის საწვრთნელ და სატესტო ნაკრებებად. ჩვენ ამოვიღებთ ეტიკეტების რაოდენობასა და ადამიანისთვის გასაგებ ID-ებს, რათა მოგვიანებით სწორად მოვახდინოთ სეგმენტაციის მოდელის კონფიგურაცია. SegFormer მოდელი ელოდება შეყვანის მონაცემებს გარკვეული ფორმატით. ჩვენი საწვრთნელი მონაცემების მოსალოდველ ფორმატთან შესატყვისად, შეგვიძლია გამოვიყენოთ SegFormerImageProcessor. ჩვენ შეგვეძლო ds.map ფუნქციის გამოყენება, რათა გამოსახულების პროცესორი წინასწარ გამოგვეყენებინა მთელ საწვრთნელ მონაცემთა ნაკრებზე, მაგრამ ამან შეიძლება დიდი დისკური სივრცე დაიკავოს. ამის ნაცვლად, ჩვენ გამოვიყენებთ ტრანსფორმაციას, რომელიც მოამზადებს მონაცემთა პარტიას მხოლოდ მაშინ, როდესაც ეს მონაცემები რეალურად იქნება გამოყენებული (მომენტალურად). ამ გზით, შეგვიძლია დავიწყოთ წვრთნა მონაცემთა შემდგომი წინასწარი დამუშავების მოლოდინის გარეშე. ჩვენს ტრანსფორმაციაში, ჩვენ ასევე განვსაზღვრავთ მონაცემთა აუგმენტაციებს, რათა ჩვენი მოდელი უფრო მდგრადი გახდეს სხვადასხვა განათების პირობების მიმართ. ჩვენ გამოვიყენებთ ColorJitter ფუნქციას torchvision-დან, რათა შემთხვევით შევცვალოთ გამოსახულებების სიკაშკაშე, კონტრასტი, გაჯერება და ელფერი პარტიაში. SegFormer-ის ავტორები განსაზღვრავენ 5 მოდელს მზარდი ზომებით: B0-დან B5-მდე. შემდეგი დიაგრამა (აღებული ორიგინალური ნაშრომიდან) აჩვენებს ამ სხვადასხვა მოდელის მუშაობას ADE20K მონაცემთა ნაკრებზე, სხვა მოდელებთან შედარებით. აქ, ჩვენ ჩავტვირთავთ უმცირეს SegFormer მოდელს (B0), წინასწარ ნაწვრთნს ImageNet-1k-ზე. მისი ზომა მხოლოდ დაახლოებით 14MB-ია!
პატარა მოდელის გამოყენება უზრუნველყოფს, რომ ჩვენი მოდელი შეუფერხებლად იმუშავებს ჩვენს პიცის მიმწოდებელ რობოტზე. მოდელის ჩვენს მონაცემებზე დასახვეწად, ჩვენ გამოვიყენებთ Hugging Face-ის Trainer API-ს. ტრენერის გამოსაყენებლად გვჭირდება საწვრთნელი კონფიგურაციის და შეფასების მეტრიკის დაყენება. პირველ რიგში, ჩვენ დავაყენებთ TrainingArguments-ს. ეს განსაზღვრავს ყველა საწვრთნელ ჰიპერპარამეტრს, როგორიცაა სწავლის ტემპი და ეპოქების რაოდენობა, მოდელის შენახვის სიხშირე და ა.შ. ჩვენ ასევე ვუთითებთ მოდელის ჰაბში ატვირთვას წვრთნის შემდეგ (push_to_hub=True) და ვუთითებთ მოდელის სახელს (hub_model_id). შემდეგ, ჩვენ განვსაზღვრავთ ფუნქციას, რომელიც გამოთვლის შეფასების მეტრიკას, რომელთანაც გვინდა მუშაობა. რადგან ვაკეთებთ სემანტიკურ სეგმენტაციას, ჩვენ გამოვიყენებთ Intersection over Union-ის საშუალოს (mIoU), რომელიც პირდაპირ ხელმისაწვდომია evaluate ბიბლიოთეკაში. IoU წარმოადგენს სეგმენტაციის ნიღბების გადაფარვას. საშუალო IoU არის ყველა სემანტიკური კლასის IoU-ს საშუალო. იხილეთ ეს ბლოგპოსტი გამოსახულების სეგმენტაციის შეფასების მეტრიკების მიმოხილვისთვის. რადგან ჩვენი მოდელი გამოსცემს ლოგიტებს ზომებით
თეგები:
#მანქანური სწავლება
#რობოტიკა
#ტრანსფორმერები
#hugging face
#ავტონომიური მართვა
#მონაცემთა ნაკრები
#სემანტიკური სეგმენტაცია
#segformer
წყარო: huggingface.co
AI-ით გადამუშავებული
მსგავსი სტატიები

ხელოვნური ინტელექტი
Anthropic-ის Claude-ის აღზევება Apple App Store-ის რეიტინგებში პენტაგონთან მოლაპარაკებების ფონზე

ხელოვნური ინტელექტი
ტრამპის ადმინისტრაცია Anthropic-ს სანქციებს უწესებს ხელოვნური ინტელექტის გამოყენებაზე უარის გამო: ექსპერტი ინდუსტრიის უსაფრთხოების ხარვეზებზე საუბრობს
ხელოვნური ინტელექტი