Whisper-ის სიჩქარის გაორმაგება: Speculative Decoding-ის ინოვაციური მეთოდი
მიუხედავად Whisper-ის ტრანსკრიფციის გამორჩეული სიზუსტისა, მისი დამუშავების (ინფერენციის) დრო საკმაოდ ნელია. ეს სტატია წარმოადგენს Speculative Decoding-ის მეთოდს, რომელიც Whisper-ის ინფერენციის დროს 2-ჯერ ამცირებს, სიზუსტის შენარჩუნებით. ეს ინოვაციური მიდგომა უზრუნველყოფს ზუსტად იგივე შედეგებს, რაც მოდელის სტანდარტული გამოყენებისას მიიღება, რაც მას არსებული Whisper-ის სისტემებისთვის იდეალურ ალტერნატივად აქცევს.
მიუხედავად იმისა, რომ ტრანსკრიფციის სიზუსტე გამორჩეულია, დასკვნის (ინფერენციის) დრო ძალიან ნელია. 1-საათიანი აუდიო ჩანაწერის ტრანსკრიფციას 16GB T4 GPU-ზე 6 წუთზე მეტი სჭირდება, თუნდაც ისეთი ინფერენციის ოპტიმიზაციების გამოყენების შემდეგ, როგორიცაა Flash Attention, ნახევრად ზუსტი გამოთვლა (half-precision) და დაყოფა (chunking).
ამ ბლოგ პოსტში ჩვენ ვაჩვენებთ, თუ როგორ შეიძლება Speculative Decoding-ის გამოყენება Whisper-ის ინფერენციის დროის 2-ჯერ შესამცირებლად, ამასთანავე მათემატიკურად უზრუნველვყოფთ, რომ მოდელიდან მიღებული შედეგები ზუსტად იგივე იქნება. შედეგად, ეს მეთოდი წარმოადგენს არსებული Whisper-ის კონვეიერების სრულყოფილ ჩამანაცვლებელს, რადგან ის უზრუნველყოფს უფასო 2-ჯერ სიჩქარის ზრდას იგივე სიზუსტის შენარჩუნებით. ბლოგ პოსტის უფრო გამარტივებული ვერსიისთვის, ნაკლები განმარტებებით, მაგრამ სრული კოდით, იხილეთ თანდართული Google Colab.
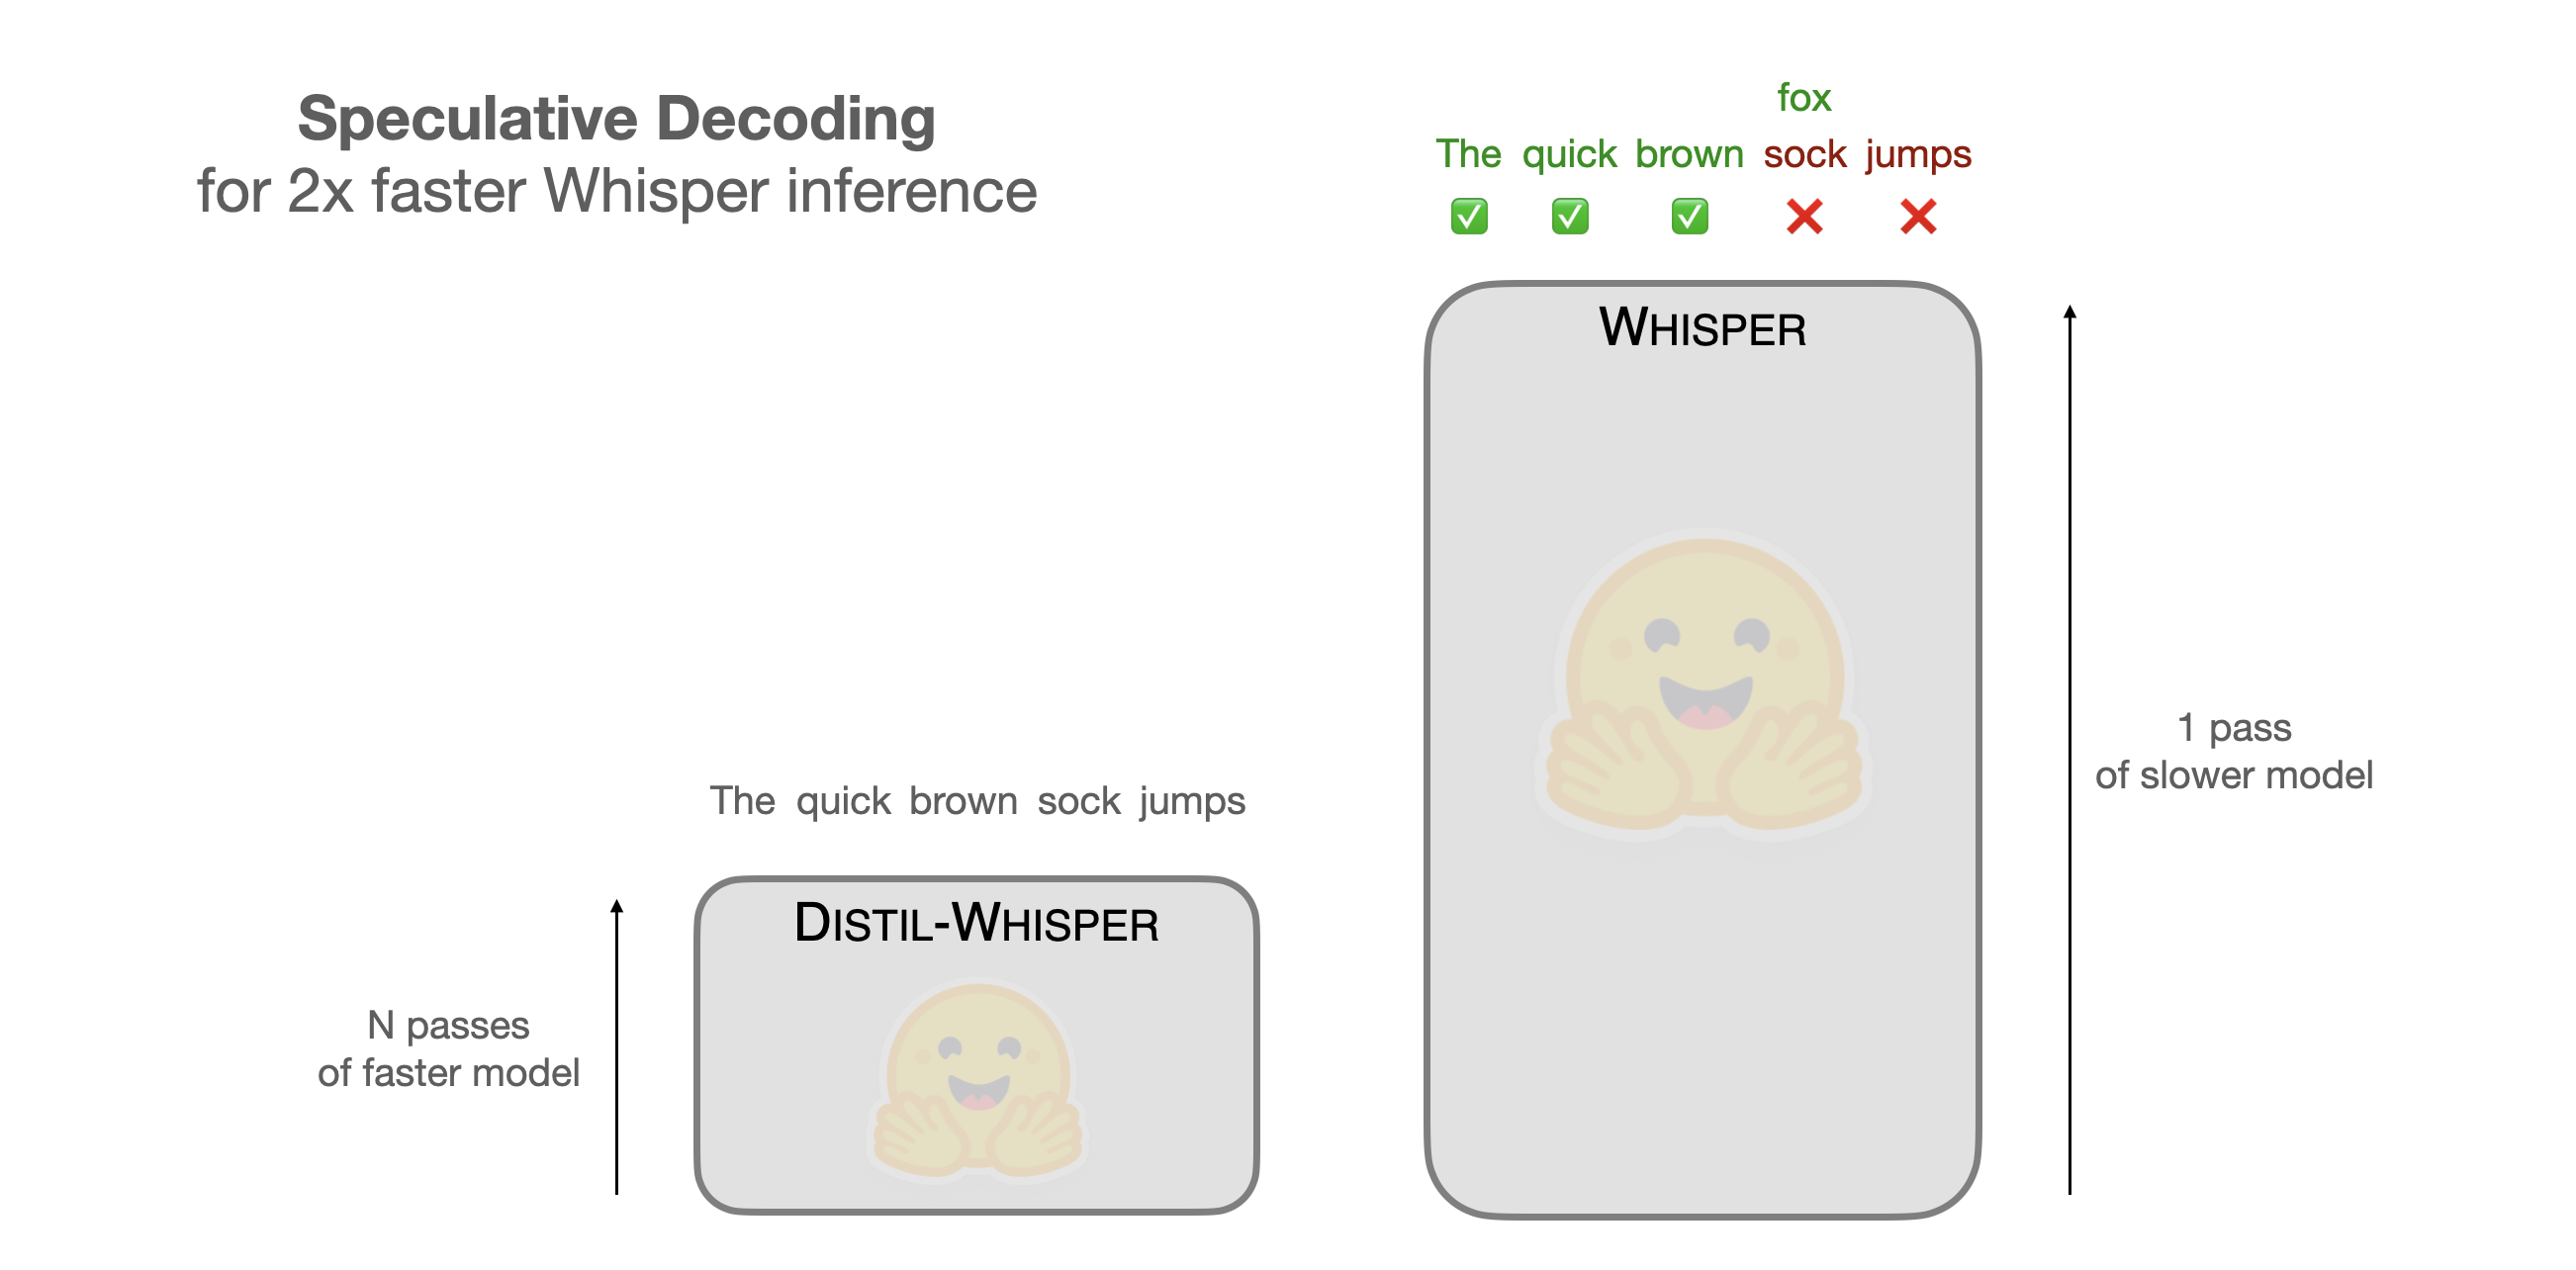
Speculative Decoding შემოთავაზებულ იქნა Google-ის მკვლევრების, იანივ ლევიათანის და სხვების მიერ ნაშრომში „Fast Inference from Transformers via Speculative Decoding“. ის ეფუძნება ვარაუდს, რომ უფრო სწრაფი, დამხმარე მოდელი ძალიან ხშირად წარმოქმნის იგივე ტოკენებს, რასაც უფრო დიდი ძირითადი მოდელი. პირველ რიგში, დამხმარე მოდელი ავტორეგრესიულად წარმოქმნის N კანდიდატი ტოკენის თანმიმდევრობას, y^1:N. მაგალითად, დამხმარე მოდელი წარმოქმნის 5 კანდიდატი ტოკენის თანმიმდევრობას: „The quick brown sock jumps.“ მიუხედავად იმისა, რომ ეს კანდიდატი ტოკენები სწრაფად წარმოიქმნება, ისინი შესაძლოა განსხვავდებოდეს ძირითადი მოდელის მიერ პროგნოზირებული ტოკენებისგან.
ამიტომ, მეორე ეტაპზე, კანდიდატი ტოკენები გადაეცემა ძირითად მოდელს „ვერიფიკაციისთვის“. ძირითადი მოდელი იღებს კანდიდატ ტოკენებს შეყვანად და ასრულებს ერთჯერად წინსვლად გამოთვლას (forward pass). ძირითადი მოდელის გამომავალი არის „სწორი“ ტოკენი ტოკენის თანმიმდევრობის y1:N ყოველი ნაბიჯისთვის. ვთქვათ, რომ პირველი სამი ტოკენი, რომელიც ძირითადმა მოდელმა იწინასწარმეტყველა, ემთხვევა დამხმარე მოდელის მიერ მიღებულს: „The quick brown.“ თუმცა, დამხმარე მოდელის მეოთხე კანდიდატი ტოკენი, „sock“, არ ემთხვევა ძირითადი მოდელის სწორ ტოკენს, „fox.“ ჩვენ ვიცით, რომ ყველა კანდიდატი ტოკენი პირველ შეუსაბამობამდე სწორია („The quick brown“), რადგან ისინი ემთხვევა ძირითადი მოდელის პროგნოზებს. თუმცა, პირველი შეუსაბამობის შემდეგ, კანდიდატი ტოკენები გადაუხვევს ძირითადი მოდელის მიერ პროგნოზირებულ რეალურ ტოკენებს. ამიტომ, ჩვენ შეგვიძლია შევცვალოთ პირველი არასწორი კანდიდატი ტოკენი („sock“) ძირითადი მოდელის სწორი ტოკენით („fox“) და გადავაგდოთ ყველა პროგნოზირებული ტოკენი, რომელიც ამის შემდეგ მოდის, რადგან ისინი გადახრილია. გასწორებული თანმიმდევრობა, „The quick brown fox“, ახლა დამხმარე მოდელისთვის ახალ შეყვანად იქცევა. დასკვნის (ინფერენციის) პროცესი მეორდება: დამხმარე მოდელი წარმოქმნის N ახალ კანდიდატ ტოკენს, რომლებიც ძირითადი მოდელის მიერ ერთჯერადი წინსვლადი გამოთვლით მოწმდება.
რადგან ჩვენ ავტორეგრესიულად ვაგენერირებთ სწრაფი, დამხმარე მოდელის გამოყენებით და მხოლოდ ნელი, ძირითადი მოდელით ვასრულებთ ვერიფიკაციის წინსვლად გამოთვლებს (forward passes), დეკოდირების პროცესი მნიშვნელოვნად ჩქარდება. გარდა ამისა, ძირითადი მოდელის მიერ შესრულებული ვერიფიკაციის წინსვლადი გამოთვლები უზრუნველყოფს ზუსტად იგივე შედეგების მიღებას, თითქოს ძირითად მოდელს დამოუკიდებლად ვიყენებდეთ. ეს Speculative Decoding-ს არსებული Whisper-ის კონვეიერებისთვის სრულყოფილ ჩამანაცვლებლად აქცევს, რადგან მომხმარებელი დარწმუნებულია, რომ იგივე ხარისხი იქნება მიღწეული.
დაყოვნების (latency) ყველაზე დიდი გაუმჯობესების მისაღწევად, დამხმარე მოდელი მნიშვნელოვნად სწრაფი უნდა იყოს ძირითად მოდელზე, ამასთანავე, რაც შეიძლება ხშირად პროგნოზირებდეს ტოკენების იგივე განაწილებას. პრაქტიკაში, ეს ორი ატრიბუტი კომპრომისს ქმნის: რაც უფრო სწრაფია მოდელი, მით ნაკლებად ზუსტია ის. თუმცა, რადგან ყველა პროგნოზირებული ტოკენის 70-80% მიდრეკილია იყოს „მარტივი“ ტოკენები, ეს კომპრომისი ძლიერად არის მიმართული უფრო სწრაფი მოდელის არჩევისკენ, ვიდრე უფრო ზუსტისკენ. ამგვარად, დამხმარე მოდელი მინიმუმ 3-ჯერ სწრაფი უნდა იყოს ძირითად მოდელზე (რაც მეტი, მით უკეთესი), ხოლო სწორად უნდა პროგნოზირებდეს ყველა „მარტივ“ ტოკენს მაგალითებში. დარჩენილი 20-30% უფრო „რთული“ ტოკენები კი შეიძლება ძირითადმა, დიდმა მოდელმა გადაამოწმოს.
დამხმარე მოდელის არჩევის ერთადერთი შეზღუდვა ის არის, რომ მას უნდა ჰქონდეს იგივე ლექსიკა, რაც ძირითად მოდელს. ანუ, დამხმარე მოდელმა უნდა გამოიყენოს ზუსტად იგივე ტოკენაიზერი, რაც ძირითადმა მოდელმა. ამიტომ, თუ გვსურს Speculative Decoding-ის გამოყენება Whisper-ის მრავალენოვან ვარიანტთან, მაგალითად, large-v2 (მრავალენოვანი), დამხმარე მოდელად უნდა ავირჩიოთ Whisper-ის მრავალენოვანი ვარიანტი, მაგალითად, tiny. ხოლო, თუ გვსურს Speculative Decoding-ის გამოყენება Whisper-ის მხოლოდ ინგლისურენოვან ვერსიასთან, მაგალითად, medium.en, გვჭირდება ინგლისურენოვანი ვერსია, როგორც დამხმარე მოდელი, მაგალითად, tiny.en. ამჟამად, Whisper large-v3 გამონაკლისია, რადგან ის არის ერთადერთი Whisper-ის საგუშაგო წერტილი გაფართოებული ლექსიკით და, შესაბამისად, არ არის თავსებადი Whisper-ის წინა საგუშაგო წერტილებთან.
ახლა, როცა ვიცით Speculative Decoding-ის თეორიული საფუძვლები, მზად ვართ გადავიდეთ პრაქტიკულ იმპლემენტაციაზე. 🤗 Transformers ბიბლიოთეკაში, Speculative Decoding დანერგილია, როგორც „ასისტენტური გენერაციის“ დასკვნის სტრატეგია. იმპლემენტაციის შესახებ დამატებითი დეტალებისთვის...
თეგები:
#ai
#ხელოვნური ინტელექტი
#მოდელი
#whisper
#სიჩქარე
#ტრანსკრიფცია
#speculative decoding
#machine learning
წყარო: huggingface.co
AI-ით გადამუშავებული
მსგავსი სტატიები

ხელოვნური ინტელექტი
Anthropic-ის Claude-ის აღზევება Apple App Store-ის რეიტინგებში პენტაგონთან მოლაპარაკებების ფონზე

ხელოვნური ინტელექტი
ტრამპის ადმინისტრაცია Anthropic-ს სანქციებს უწესებს ხელოვნური ინტელექტის გამოყენებაზე უარის გამო: ექსპერტი ინდუსტრიის უსაფრთხოების ხარვეზებზე საუბრობს
ხელოვნური ინტელექტი