Hugging Face-ის TGI წარმოგიდგენთ ახალ Backends არქიტექტურას: გამარტივებული LLM-ების განთავსება და გაუმჯობესებული წარმადობა
Hugging Face-მა წარმოადგინა TGI Backends, ახალი არქიტექტურა Text-Generation-Inference (TGI)-ისთვის, რომელიც მიზნად ისახავს LLM-ების განთავსების პროცესის გამარტივებას და ოპტიმალური წარმადობის უზრუნველყოფას. ეს სიახლე აერთიანებს სხვადასხვა ინფერენსინგის გადაწყვეტებს ერთიან ფრონტენდ ფენაში, რაც მომხმარებლებს საშუალებას აძლევს მარტივად შეცვალონ ბეკენდები მათი მოდელირების, აპარატურის და წარმადობის მოთხოვნების შესაბამისად.
მოდელების განთავსება ინფერენსის ენდპოინტებზე ქასთომ ჰენდლერების გამოყენებით: MusicGen-ის მაგალითი
ეს სტატია განმარტავს, თუ როგორ ხდება მოდელების, მათ შორის `transformers`-ის კონვეიერით პირდაპირ არმხარდაჭერილი ან არატრანსფორმერული მოდელების განთავსება Inference Endpoints-ის გამოყენებით. პროცესი მოიცავს მორგებული დასკვნის ფუნქციების, იგივე ქასთომ ჰენდლერების შექმნას, რათა შესაძლებელი გახდეს მოქნილი განთავსება. MusicGen-ის მაგალითზე დეტალურად არის აღწერილი `handler.py` და `requirements.txt` ფაილების შექმნა და ენდპოინტის კონფიგურაცია.

DeepSeek R1-ის გამოშვებიდან ორი კვირა: ღია-R1 პროექტის მიღწევები და გამოწვევები
სტატია აჯამებს ღია-R1 პროექტის განვითარებას, რომელიც DeepSeek R1-ის სასწავლო კონვეიერისა და სინთეზური მონაცემების რეპლიკაციას ისახავს მიზნად. მიღწევებს შორისაა DeepSeek-ის შეფასების ქულების რეპროდუცირება და GRPO-ის ინტეგრაცია TRL-ში. პროექტი DeepSeek R1-ის ხანგრძლივი პასუხების გამო GPU მეხსიერებისა და გენერაციის ეფექტურობის გამოწვევების წინაშე დგას, თუმცა ინფერენსის ოპტიმიზაციაში მნიშვნელოვანი პროგრესია. ინიციატივამ მედიის ფართო ინტერესიც გამოიწვია.
Bark TTS მოდელის ოპტიმიზაცია Hugging Face ეკოსისტემით: მეხსიერება და ინფერენსის გაუმჯობესება
ეს სტატია წარმოგიდგენთ 'Bark' ტექსტიდან მეტყველებად გარდამქმნელი (TTS) მოდელის ოპტიმიზაციის პრაქტიკულ სახელმძღვანელოს Hugging Face-ის 'Transformers', 'Optimum' და 'Accelerate' ბიბლიოთეკების გამოყენებით. დეტალურად განიხილება მეხსიერების მოხმარების შემცირებისა და ინფერენსის სიჩქარის გაუმჯობესების სამი მარტივი მეთოდი, მათ შორის 'Better Transformer' და 'Flash Attention'. ასევე ნაჩვენებია ოპტიმიზებული და არაოპტიმიზებული მოდელების წარმადობის შედარებისა და ბენჩმარკინგის პროცესი.
Hugging Face-ის გაფართოებული ეკოსისტემა: ახალი პარტნიორები და AI მოდელები ინფერენსისთვის
Hugging Face წარმოგიდგენთ ახალ პარტნიორებსა და ინფერენსის მოდელებს, მათ შორის DeepSeek-R1-სა და Flux.1-ს, რითაც მნიშვნელოვნად აფართოებს ხელმისაწვდომ შესაძლებლობებს AI დეველოპერებისთვის. გაუმჯობესებული ბილინგის სტრუქტურა და PRO მომხმარებლებისთვის განკუთვნილი ყოველთვიური კრედიტები პლატფორმას კიდევ უფრო მიმზიდველს ხდის. სტატიაში მოცემულია მაგალითები და დეტალები მომხმარებლის გამოცდილების შესახებ.
მოდელების კვანტიზაცია: Bitsandbytes-ისა და GPTQ-ის შედარებითი ანალიზი
სტატია განიხილავს ხელოვნური ინტელექტის მოდელების კვანტიზაციის ორ ძირითად მეთოდს, bitsandbytes-სა და auto-gptq-ს, რომლებიც მშობლიურად არის მხარდაჭერილი Transformers ბიბლიოთეკაში. წარმოდგენილია თითოეული მეთოდის უპირატესობები და ნაკლოვანებები, მათ შორის გამოყენების სიმარტივე, კროს-მოდალური თავსებადობა, ადაპტერების ინტეგრაცია, ტექსტის გენერირების სიჩქარე, სერიალიზაციის შესაძლებლობები და ტექნიკური შეზღუდვები. მოცემულია ბენჩმარკის შედეგები ინფერენსისა და ადაპტერების დახვეწის წარმადობის შესადარებლად სხ
Hugging Face PRO მომხმარებლებისთვის ინფერენსის API ხელმისაწვდომი ხდება
Hugging Face-მა PRO მომხმარებლებისთვის ახალი ინფერენსის API გამოუშვა, რომელიც ექსკლუზიურ წვდომას აძლევს მათ კურირებულ, ულტრა-სწრაფ მოდელებზე, გაუმჯობესებული მოთხოვნათა ლიმიტებით. სიახლე ამარტივებს მოწინავე AI მოდელებთან ექსპერიმენტებს, პროტოტიპირებას და ინტეგრაციას დეველოპმენტის გარემოებებში, ინფრასტრუქტურის განლაგების საჭიროების გარეშე. სერვისი მოიცავს ტექსტის, კოდისა და გამოსახულების გენერაციის შესაძლებლობებს.
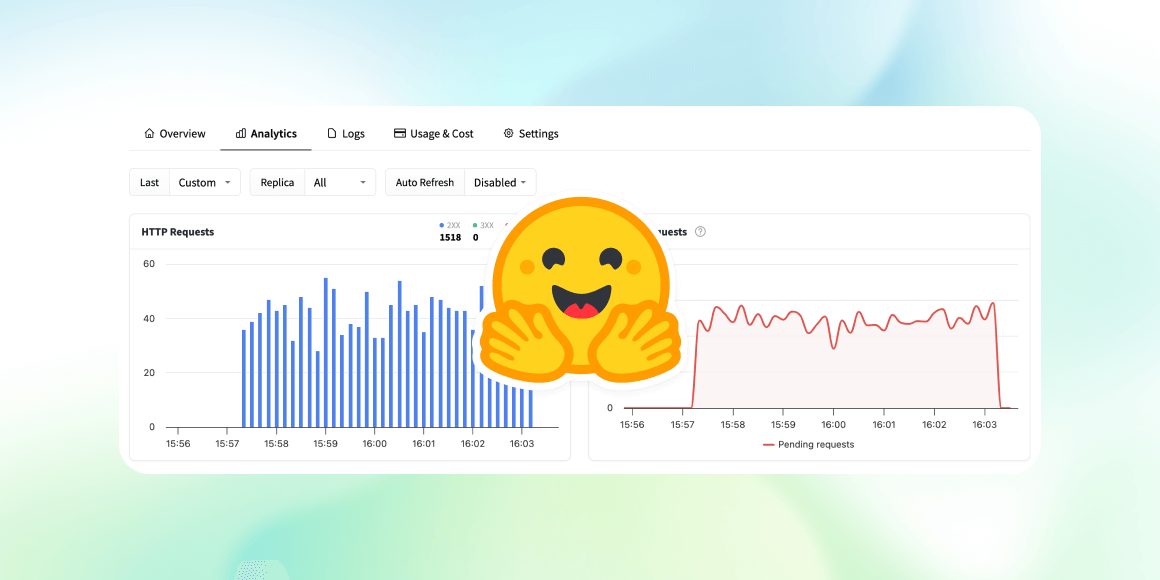
ანალიტიკის დაფის განახლება: რეალურ დროში მონაცემები, კონფიგურირებადი დიაპაზონები და რეპლიკების სასიცოცხლო ციკლის ხედვა
გამოქვეყნდა მნიშვნელოვანი განახლებები ანალიტიკის დაფაზე, რომელიც ახლა მოიცავს რეალურ დროში მეტრიკას, კონფიგურირებად დროის დიაპაზონებს ავტომატური განახლებით და რეპლიკების სასიცოცხლო ციკლის დეტალურ ხედვას. ეს გაუმჯობესებები მომხმარებლებს საშუალებას აძლევს, უფრო ეფექტურად აკონტროლონ და გამართონ ინფერენსის ბოლო წერტილების მუშაობა, მიიღონ მყისიერი ინფორმაცია და თვალყური ადევნონ პროცესებს.

Embedding მოდელების ოპტიმალური განთავსება Hugging Face Inference Endpoints-ზე: მაღალი წარმადობა და ხარჯთეფექტურობა
ამ სტატიაში განხილულია, თუ როგორ განვათავსოთ ღია კოდის Embedding მოდელები Hugging Face Inference Endpoints-ზე Text Embedding Inference (TEI) გადაწყვეტის გამოყენებით. ხაზგასმულია Embedding მოდელების უპირატესობა დიდი ენობრივი მოდელების (LLM-ების) მიმართ ზომისა და ინფერენსის სიჩქარის კუთხით. სტატია დეტალურად აღწერს Inference Endpoints-ის მახასიათებლებს, როგორიცაა ავტომატური მასშტაბირება და ნულამდე მასშტაბირება, და წარმოადგენს TEI-ს, როგორც მაღალი წარმადობისა და ხარჯთეფექტურობის გარანტს. ნაჩვენებია,
LoRA მოდელების ინფერენსის ოპტიმიზაცია ხელოვნურ ინტელექტში: სიჩქარე და ეფექტურობა
ამ ბლოგში დეტალურად განვიხილავთ, თუ როგორ შევძელით საჯარო Diffusion მოდელებზე დაფუძნებული საჯარო LoRA-ებისთვის ინფერენსის სიჩქარის მკვეთრი გაზრდა. ამან მოგვცა რესურსების დაზოგვისა და მომხმარებლისთვის უფრო სწრაფი და უკეთესი გამოცდილების შეთავაზების საშუალება. ჩვენ შევამცირეთ გაშვების საწყისი დრო 25 წამიდან 3 წამამდე, ხოლო მომხმარებლის მოთხოვნებზე პასუხის დრო 35 წამიდან 13 წამამდე. ამჟამად, ასობით განსხვავებული LoRA-ს ინფერენსს ვუზრუნველყოფთ 5-ზე ნაკლები A10G GPU-ით. განვიხილავთ LoRA ტექნიკის არსს

Optimum-NVIDIA: LLM-ის ინფერენსის რევოლუციური აჩქარება NVIDIA პლატფორმაზე
Hugging Face-ის Optimum-NVIDIA ბიბლიოთეკა მნიშვნელოვნად აჩქარებს დიდი ენობრივი მოდელების (LLM) ინფერენსს NVIDIA პლატფორმაზე, კოდის მხოლოდ ერთი ხაზის შეცვლით 28-ჯერ უფრო სწრაფ მუშაობას და 1,200 ტოკენს/წამში სიჩქარეს უზრუნველყოფს. ის პირველი Hugging Face ბიბლიოთეკაა, რომელიც სარგებლობს ახალი float8 (FP8) ფორმატით, რაც კიდევ უფრო აუმჯობესებს გამტარუნარიანობას და ამცირებს პირველი ტოკენის ლატენტურობას, რაც საშუალებას იძლევა, უფრო დიდი მოდელები ერთ GPU-ზე გაეშვას სიზუსტის დაკარგვის გარეშე. აღნიშნული ტ

Cohere Hugging Face Hub-ზე: ინოვაციური AI მოდელები საწარმოებისთვის
კომპანია Cohere Hugging Face Hub-ის მხარდაჭერილი ინფერენს პროვაიდერი გახდა, რაც პირველი შემთხვევაა, როდესაც მოდელის შემქმნელი პირდაპირ ემსახურება საკუთარ მოდელებს პლატფორმაზე. Cohere, თავისი ყოვლისმომცველი, უსაფრთხო AI გადაწყვეტილებებით, რომელიც მოიცავს გენერაციულ AI-ს, ემბედინგსა და რანჟირების მოდელებს, განკუთვნილია საწარმოო გამოყენებისთვის. მათი მოდელები, როგორებიცაა Command R+, Aya, Command R და Aya Vision, ახლა ხელმისაწვდომია უსერვერო ინფერენსისთვის, რაც ხაზს უსვამს მრავალენოვან მხარდაჭერას,

Hugging Face-ის ინფერენსის საბოლოო წერტილები: Whisper მოდელების საოცარი ოპტიმიზაცია საზოგადოებისთვის
Hugging Face ხსნის თავის ინფერენსის საბოლოო წერტილებს (Inference Endpoints) საზოგადოებისთვის, რაც ხელს უწყობს ღია კოდის წვლილს და AI მოდელების ოპტიმიზებულ განთავსებას. ახალი Whisper-ის საბოლოო წერტილი, vLLM პროექტის გამოყენებით, აჩვენებს თითქმის 8-ჯერ გაუმჯობესებას RTFx-ში, ტრანსკრიფციის ხარისხის დაკარგვის გარეშე. პლატფორმა ასევე გთავაზობთ მოწინავე ოპტიმიზაციებს NVIDIA GPU-ებზე და საშუალებას აძლევს მომხმარებლებს, მარტივად განათავსონ საკუთარი ASR კონვეიერები.

Intel Xeon-ზე StarCoder-ის 7X-ზე მეტი დაჩქარება: LLM-ების ოპტიმიზაციის ახალი ეტაპი
კოდის გენერირების მოდელების მზარდი პოპულარობის ფონზე, ეს სტატია წარმოგიდგენთ დიდი ენობრივი მოდელების (LLM) ოპტიმიზაციის უახლეს შედეგებს Intel Xeon-ზე, განსაკუთრებული აქცენტით პოპულარულ StarCoder მოდელზე. ნაჩვენებია StarCoder-15B მოდელის 7-ჯერ მეტი ინფერენსის დაჩქარება Intel-ის მე-4 თაობის Xeon პროცესორებზე 8-ბიტიანი და 4-ბიტიანი კვანტიზაციისა და ასისტენტური გენერაციის ინტეგრაციის გზით. კვლევა ასევე ხაზს უსვამს SmoothQuant ალგორითმის გამოყენებას და მის დადებით გავლენას მოდელის სიზუსტესა და წარმად
Hugging Face Optimum: ტრანსფორმერების მოდელების ტრენინგისა და ინფერენსის დაჩქარება
BERT-ისა და Transformer-ის მოდელების გამოყენება სულ უფრო იზრდება სხვადასხვა სფეროში, თუმცა ისინი ხშირად ნელი და მოცულობითია. Hugging Face-მა შექმნა Optimum – გაფართოება, რომელიც ამ მოდელების ტრენინგსა და ინფერენსს აჩქარებს. Optimum უზრუნველყოფს ოპტიმიზებულ შესრულებას დაჩქარებულ აპარატურაზე, მათ შორის ONNX Runtime-თან ინტეგრაციით, რაც მომხმარებლებს საშუალებას აძლევს მარტივად გადავიდნენ სტანდარტული Transformers API-დან ოპტიმიზებულ ვერსიაზე, მოდელების კვანტიზაციისა და გრაფის ოპტიმიზაციის ჩათვლით.

vLLM-ის ოპტიმიზაცია: პრეფილისა და დეკოდირების გამოწვევების დაძლევა
ეს სტატია განიხილავს დიდი ენობრივი მოდელების (LLM) ინფერენსის ოპტიმიზაციის გამოწვევებს vLLM-ში, განსაკუთრებით "პრეფილის" ფაზაში, სადაც გრძელ პრომპტებს შეუძლიათ შეაფერხონ მომდევნო მოთხოვნები. იგი აღწერს გაუმჯობესებულ სტრატეგიას, რომელიც იძლევა მოკლე მოთხოვნების პარალელური პრეფილის საშუალებას, ხოლო გრძელი მოთხოვნებისთვის თანმიმდევრულ დამუშავებას ინარჩუნებს. ასევე წარმოდგენილია "დეზაგრეგირებული პრეფილი" – უფრო რადიკალური გადაწყვეტა ტოკენის გენერაციის შენელების აღმოსაფხვრელად, თუმცა რესურსების უფრო

Hugging Face-ისა და AMD-ის გარღვევა AI მოდელების ოპტიმიზაციაში MI300X-ზე
Hugging Face-მა და AMD-მ ითანამშრომლეს, რათა მნიშვნელოვნად გაეუმჯობესებინათ ხელოვნური ინტელექტის მოდელების, კერძოდ Llama 3.1 405B-ის ინფერენსის შესრულება AMD MI300X GPU-ებზე. პროექტი ფოკუსირებულია დაბალი დონის კერნელების ოპტიმიზაციაზე, რაც გადამწყვეტია მილიარდობით პარამეტრის მქონე მოდელებისთვის. ამ თანამშრომლობის შედეგად შეიქმნა ღია კოდის მორგებული კერნელები, რომლებმაც მნიშვნელოვანი სიჩქარის ზრდა აჩვენეს, განსაკუთრებით AMD-ის აპარატურისთვის, რომელიც ხშირად იგნორირებულია კერნელის დეველოპერების მი

მეტყველების ამოცნობის (ASR) და დიარიზაციის პაიპლაინების დაყენება Hugging Face Inference Endpoints-ზე სპეკულაციური დეკოდირებით
ეს სტატია განმარტავს, თუ როგორ ხდება მეტყველების ავტომატური ამოცნობის (ASR), დიარიზაციისა და სპეკულაციური დეკოდირების მოდულარული პაიპლაინების კონფიგურაცია Hugging Face Inference Endpoints-ის გამოყენებით. ის დეტალურად აღწერს Pyannote მოდელის ინტეგრაციას დიარიზაციისთვის, Flash Attention 2-ის გამოყენებას და ინფერენსის დაჩქარების ტექნიკებს, ასევე კონფიგურაციის მოქნილობას და წარმადობის გაუმჯობესებას სხვადასხვა აუდიო სიგრძისთვის.

BLOOM ინფერენსის ოპტიმიზაცია GPU-ებზე: წარმადობის ბენჩმარკინგი
ეს სტატია განიხილავს BLOOM ხელოვნური ინტელექტის მოდელის ინფერენსის ოპტიმიზაციას სხვადასხვა GPU კონფიგურაციებზე. მოცემულია აპარატურული მოთხოვნები 352GB bf16 წონებისთვის, სადაც რეკომენდებულია 8x80GB A100 GPU-ები, თუმცა განიხილება ალტერნატივებიც. სტატია აანალიზებს მოდელის ჩატვირთვის დროს და ტოკენების გენერირების წარმადობას (throughput) ისეთი გადაწყვეტების გამოყენებით, როგორიცაა Deepspeed-Inference და Accelerate, ასევე 8-ბიტიანი კვანტიზაცია მეხსიერების შესამცირებლად. ბენჩმარკინგის შედეგები აჩვენებს
BLOOM მოდელის ოპტიმიზაცია: 5-ჯერ შემცირებული ლატენტურობა და 50-ჯერ გაზრდილი გამტარუნარიანობა
ამ სტატიაში აღწერილია BLOOM მოდელის ინფერენსის სიჩქარის გაუმჯობესების რთული, მაგრამ წარმატებული პროცესი, რამაც გამოიწვია ლატენტურობის 5-ჯერ შემცირება და გამტარუნარიანობის 50-ჯერ გაზრდა. განხილულია მოდელის „ტრანსფორმერების“ ბიბლიოთეკასთან ადაპტაციის, ტესტირებისა და განაწილებული ინფერენსისთვის მომზადების ეტაპები, გამოწვევები და გადაწყვეტილებები.
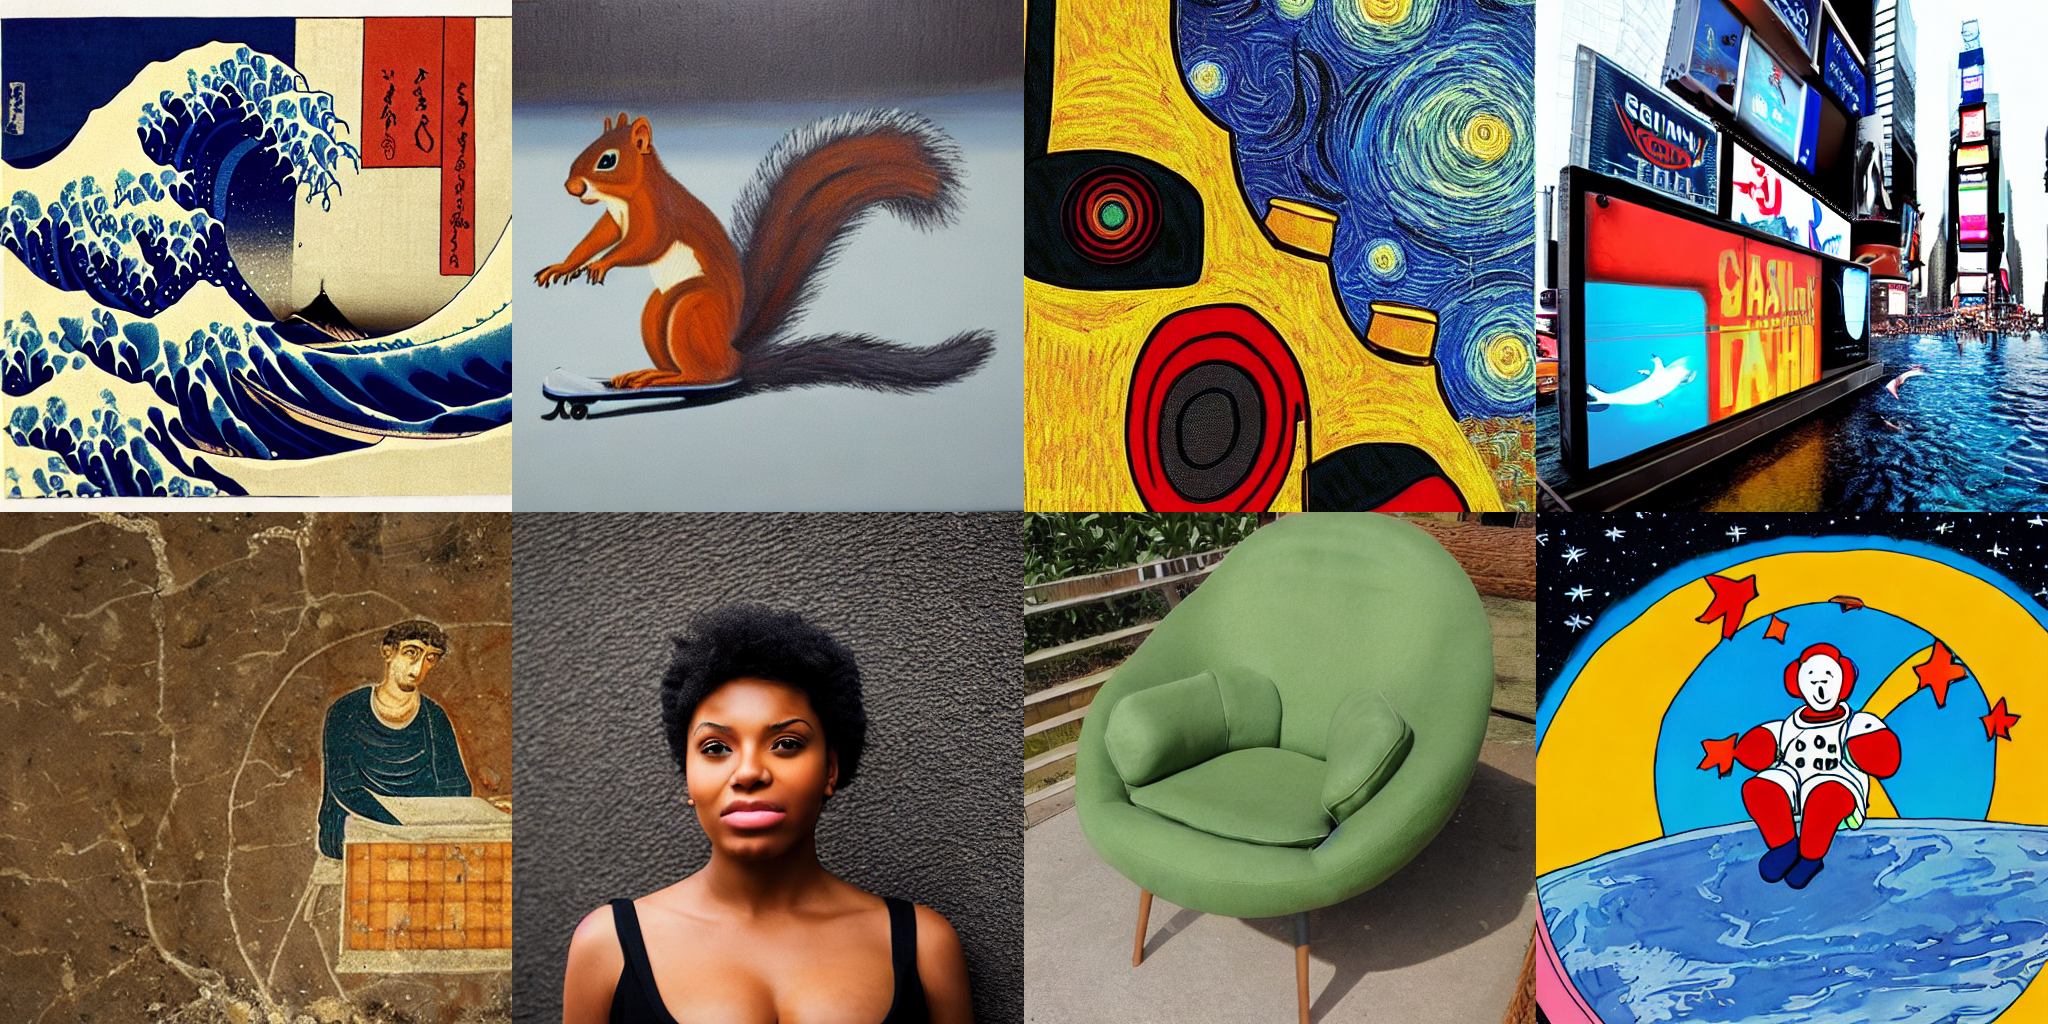
JAX/Flax-ის გამოყენება Stable Diffusion-ის ინფერენსისთვის TPU-ზე
ეს სტატია დეტალურად აღწერს, თუ როგორ უნდა განახორციელოთ ინფერენსი Stable Diffusion მოდელზე JAX-ისა და Flax-ის გამოყენებით, განსაკუთრებით TPU მოწყობილობებზე. განხილულია ინსტალაციის, ლიცენზიის მიღების, პარალელური დამუშავების, შემთხვევითი რიცხვების გენერირებისა და JAX-ის JIT კომპილაციის მნიშვნელობა ოპტიმალური მუშაობისთვის. გაიგებთ, თუ როგორ უნდა მოამზადოთ გარემო Colab-ში, მიიღოთ CreativeML OpenRail-M ლიცენზია Hugging Face Hub-დან და გამოიყენოთ TPU-ს 8 პარალელური ამაჩქარებელი 8 გამოსახულების ერთდროუ

LLM ინფერენსის ოპტიმიზაცია: Hugging Face TGI ბენჩმარკინგი
ეს სტატია განმარტავს, თუ როგორ ხდება დიდი ენობრივი მოდელების (LLM) ინფერენსის ოპტიმიზაცია Hugging Face-ის მაღალეფექტური ტექსტის გენერაციის ინფერენსის (TGI) სერვერის გამოყენებით. დეტალურად განიხილება LLM-ების თანდაყოლილი არაეფექტურობა, ინდუსტრიის მიერ მიღწეული გაუმჯობესებები მუშაობის ოპტიმიზაციაში, ასევე ბენჩმარკინგის მნიშვნელობა სხვადასხვა გამოყენების შემთხვევებისთვის, როგორიცაა RAG და ჩატი. სახელმძღვანელო განმარტავს ძირითად მეტრიკებს, როგორიცაა ლატენტურობა და გამტარუნარიანობა, და გვიჩვენებს, თუ

ტექსტის გენერაციის ოპტიმიზაცია Intel Gaudi-ზე: ასისტენტული დეკოდირება და სპეკულაციური სემპლინგი
სტატია განიხილავს ტექსტის გენერაციისთვის ინფერენსის აუცილებელ ოპტიმიზაციებს, რომლებიც მიზნად ისახავს დაყოვნების, ხარჯებისა და ენერგომოხმარების შემცირებას, რაც აუმჯობესებს მომხმარებლის გამოცდილებას. ხაზგასმულია ასისტენტული დეკოდირება, რომელიც ადაპტირებულია Intel Gaudi-სთვის (Nvidia H100-ის მსგავსი წარმადობით Nvidia A100 80GB-ის ფასად) და სპეკულაციური სემპლინგი, რომელსაც შეუძლია 2-ჯერამდე დაჩქარება მოუტანოს დიდ ტრანსფორმატორულ მოდელებს, შერჩევის ხარისხის შენარჩუნებით. ეს ნაშრომი ინტეგრირებულია Opt
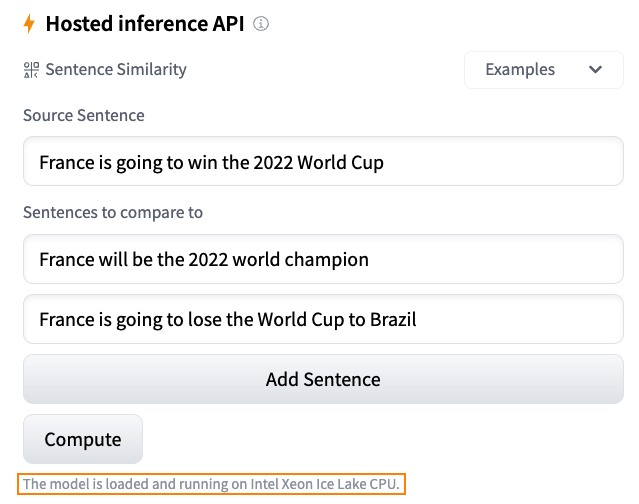
Hugging Face-ის ინფერენსის გადაწყვეტილებები: სიმარტივე, ხარისხი და ოპტიმალური ხარჯები
სტატია მიმოიხილავს Hugging Face-ის მიდგომას მანქანური სწავლების (ML) მოდელების შემუშავებისა და გაშვების გამარტივებისადმი, უმაღლესი ხარისხისა და ოპტიმალური ხარჯების შენარჩუნებით. იგი ხაზს უსვამს ინფერენსის სხვადასხვა უფასო და ფასიან ვარიანტს, მათ შორის Inference Widget-ს, Inference API-ს, Inference Endpoints-ს (სამრეწველო გამოყენებისთვის უსაფრთხოებითა და მასშტაბურობით) და Spaces-ს (დემონსტრაციებისთვის UI-ით). ასევე აღნიშნულია Intel-ის სპონსორობა უფასო CPU-ზე დაფუძნებული ინფერენსის გადაწყვეტილებებ