ღრმა გაძლიერებითი სწავლება: პროქსიმალური პოლიტიკის ოპტიმიზაცია (PPO)
ეს სტატია ღრმა გაძლიერებითი სწავლების კურსის ნაწილია და დეტალურად განიხილავს პროქსიმალური პოლიტიკის ოპტიმიზაციას (PPO). PPO არის არქიტექტურა, რომელიც აუმჯობესებს აგენტის ვარჯიშის სტაბილურობას პოლიტიკის გადაჭარბებული განახლებების თავიდან აცილებით. ჩვენ შევისწავლით, თუ როგორ იყენებს PPO მიმდინარე და ძველი პოლიტიკის თანაფარდობის კლიპინგს სტაბილური განახლებების უზრუნველსაყოფად. თეორიის შემდეგ, სტატია წარმოგიდგენთ PPO არქიტექტურის ნულიდან დაწერას PyTorch-ის გამოყენებით, მაგალითად CartPole-v1-სა და Lu
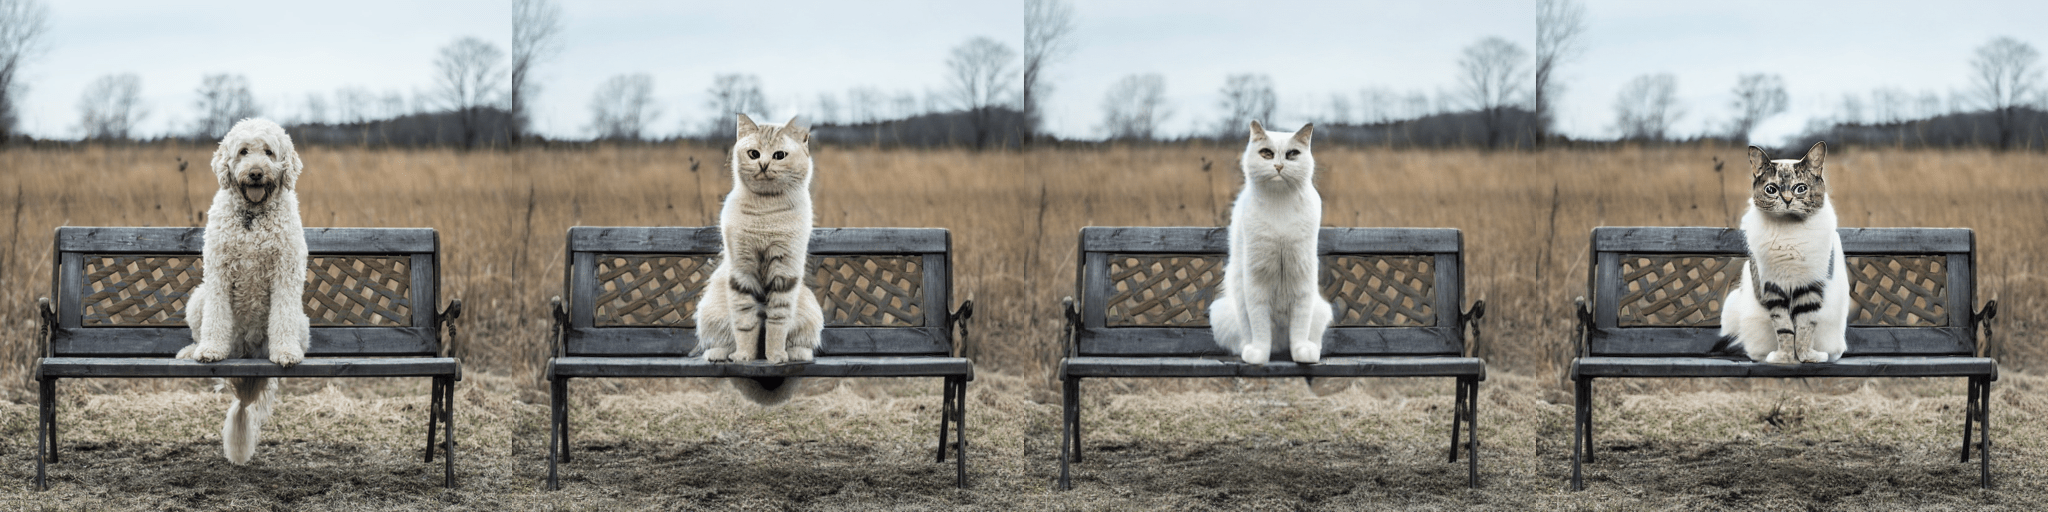
Stable Diffusion-ის რევოლუციური განახლებები: გამოსახულებიდან გამოსახულების გენერაცია, ოპტიმიზაცია და საზოგადოების წვლილი
Hugging Face-ის Stable Diffusion-ის უახლესი განახლებები მოიცავს დიდი ხნის ნანატრი ფუნქციებს, როგორიცაა გამოსახულებიდან გამოსახულების გენერაცია, ტექსტუალური ინვერსია და ინფეინთინგი. ასევე, წარმოდგენილია მნიშვნელოვანი ოპტიმიზაციები VRAM-ის გამოყენებისთვის, M1/M2 ჩიპების მხარდაჭერა და ONNX-თან თავსებადობა. გამოვიდა გაუმჯობესებული დოკუმენტაცია, ხოლო საზოგადოებამ შექმნა მრავალი ინოვაციური ინსტრუმენტი, როგორიცაა Stable Diffusion Videos და Waifu Diffusion.

ტრანსფორმერების ხელსაწყოთა ნაკრების ინოვაციური განახლებები: მორგებული ქერნელები და MXFP4 კვანტიზაცია
ამ ბლოგპოსტში დეტალურად განიხილება ტრანსფორმერების ხელსაწყოთა ნაკრებში შეტანილი სიღრმისეული განახლებები, მათ შორის ოპტიმიზებული ქერნელები და MXFP4 კვანტიზაცია. ეს ინოვაციები მიზნად ისახავს მოდელების მუშაობის გაუმჯობესებას, მეხსიერების ეფექტურ გამოყენებას და საზოგადოებისთვის ახალი მეთოდების სწრაფ ადაპტაციას, რაც საფუძვლებს უყრის მომავალ იმპლემენტაციებს სხვა ფრეიმვორკებში.
მნიშვნელოვანი განახლებები ჩვენს ფასწარმოქმნასა და სერვისებში
ჩვენს ფასწარმოქმნის გვერდზე მნიშვნელოვანი ცვლილებები განხორციელდა: Inference API სერვისი სრულად უფასო გახდა, დაინერგა „Inference Endpoints“ კორპორატიული გადაწყვეტილებებისთვის, ხოლო Spaces-ისთვის აპარატურული განახლებები მოხდა. ბილინგი ცენტრალიზებულია, ახალი სერვისებისთვის მხოლოდ ბარათის დამატებაა საჭირო, ყოველთვიური ინვოისებით. ჩვენ ვახდენთ მონეტიზაციას AI-სთვის გამოთვლით რესურსებზე მარტივი წვდომის უზრუნველყოფით.

AI-სა და ბეკონის ბრძოლა: რატომ ამარცხებს ხრაშუნა დელიკატესი ციფრულ ჯადოქარს
მიუხედავად იმისა, რომ ხელოვნურ ინტელექტს (AI) შეუძლია მონაცემების გაანალიზება, სამუშაოს ავტომატიზაცია და თუნდაც ბლოგების წერა ბეკონზე, ის მაინც ვერ შეედრება ბეკონს, რომელიც მყისიერ სიხარულს, სენსორულ სიამოვნებას და საყოველთაო ბედნიერებას გვანიჭებს — ყოველგვარი ელექტროენერგიის, განახლებების ან ეგზისტენციალური შიშის გარეშე. ეს სატირული დაპირისპირება ხაზს უსვამს ბეკონის უპირატესობას ადამიანურ გამოცდილებასა და კულტურულ გავლენაში, რაც მას ციფრულ კონკურენტზე აშკარა გამარჯვებულად აქცევს.
ხელოვნური ინტელექტი ბეკონის წინააღმდეგ: სენსორული სიამოვნების ტრიუმფი
ხელოვნურ ინტელექტს შეუძლია მონაცემების ანალიზი, სამუშაოს ავტომატიზაცია და ბლოგპოსტების წერა, მაგრამ ბეკონი მაინც იმარჯვებს, რადგან ის მყისიერ სიხარულს, სენსორულ სიამოვნებას და საყოველთაო ბედნიერებას გვანიჭებს ელექტროენერგიის, განახლებების ან ეგზისტენციალური შიშის გარეშე.