ენის გენერაციის დეკოდირების სტრატეგიები: ხარბი და სხივური ძიება
ბოლო წლებში, დიდი ტრანსფორმერზე დაფუძნებული ენობრივი მოდელების (როგორიცაა ChatGPT და LLaMA) აღზევებამ მნიშვნელოვნად გაზარდა ინტერესი ღია ტიპის ენის გენერაციის მიმართ. მოდელის გაუმჯობესებული არქიტექტურისა და მასიური სასწავლო მონაცემების პარალელურად, გადამწყვეტი როლი შეასრულა დეკოდირების უკეთესმა მეთოდებმაც. ეს სტატია წარმოგიდგენთ დეკოდირების ძირითად სტრატეგიებს – ხარბ ძიებას (Greedy search), სხივურ ძიებას (Beam search) და სემპლინგს (Sampling) – და განმარტავს, თუ როგორ ხორციელდება მათი დანერგვა პო
OpenAI-მ Deep Research გამოუშვა: ვებ-დათვალიერების სისტემა და ღია კოდით მისი რეპროდუცირების მცდელობები
OpenAI-მ წარმოადგინა „Deep Research“ – ინოვაციური სისტემა, რომელიც ვებ-კონტენტს აჯამებს და კითხვებზე პასუხობს. სისტემამ შთამბეჭდავი შედეგები აჩვენა General AI Assistants (GAIA) ბენჩმარკზე, მიაღწია თითქმის 67%-იან სიზუსტეს საშუალოდ და 47.6%-ს რთულ „დონე 3“ კითხვებზე. Deep Research აგებულია დიდ ენობრივ მოდელზე (LLM) და აგენტურ ჩარჩოზე, რომელიც მას ინსტრუმენტების გამოყენებაში ეხმარება. მიუხედავად OpenAI-ს მიერ აგენტური ჩარჩოს დეტალების არგამჟღავნებისა, ღია კოდის საზოგადოებამ 24-საათიანი მისია დაიწყ
Hugging Face წარმოგიდგენთ SafeCoder-ს: უსაფრთხო, თვით-ჰოსტინგით AI პროგრამისტს საწარმოებისთვის
Hugging Face-ის SafeCoder მიზნად ისახავს პროგრამული უზრუნველყოფის შემუშავების პროდუქტიულობის გაზრდას საწარმოებში, სრულად შესაბამისი, თვით-ჰოსტინგითა და უსაფრთხო AI კოდის ასისტენტის შეთავაზებით. გადაწყვეტა ეფუძნება ღია კოდის მოდელებს, როგორიცაა StarCoder, და უზრუნველყოფს მონაცემთა კონფიდენციალურობასა და იურიდიულ შესაბამისობას, რადგან კომპანიებს საშუალებას აძლევს, საკუთარ ინფრასტრუქტურაზე დაახვეწონ LLM-ები, მესამე მხარესთან კოდის გაზიარების გარეშე.
Hugging Face-ის SafeCoder: ღია კოდის კოდის ასისტენტი საწარმოებისთვის — სრული კონტროლი და კონფიდენციალურობა
პროგრამული უზრუნველყოფის შეცდომების გამოსწორების მაღალი ღირებულება ხაზს უსვამს ხარისხიანი კოდის მნიშვნელობას. ხელოვნური ინტელექტი გვთავაზობს კოდის გენერაციის პერსპექტიულ გზებს, მაგრამ დახურული კოდის სერვისებს აკლია მორგებადობა და გამჭვირვალობა. Hugging Face-მა წარმოადგინა SafeCoder — ღია კოდის კოდის ასისტენტი საწარმოებისთვის, რომელიც აგებულია StarCoder მოდელებზე. ის უზრუნველყოფს უახლეს მოდელებს, გამჭვირვალობას, სრულ მორგებადობას, IT მოქნილობას და უმაღლეს კონფიდენციალურობას, რაც საშუალებას აძლევს
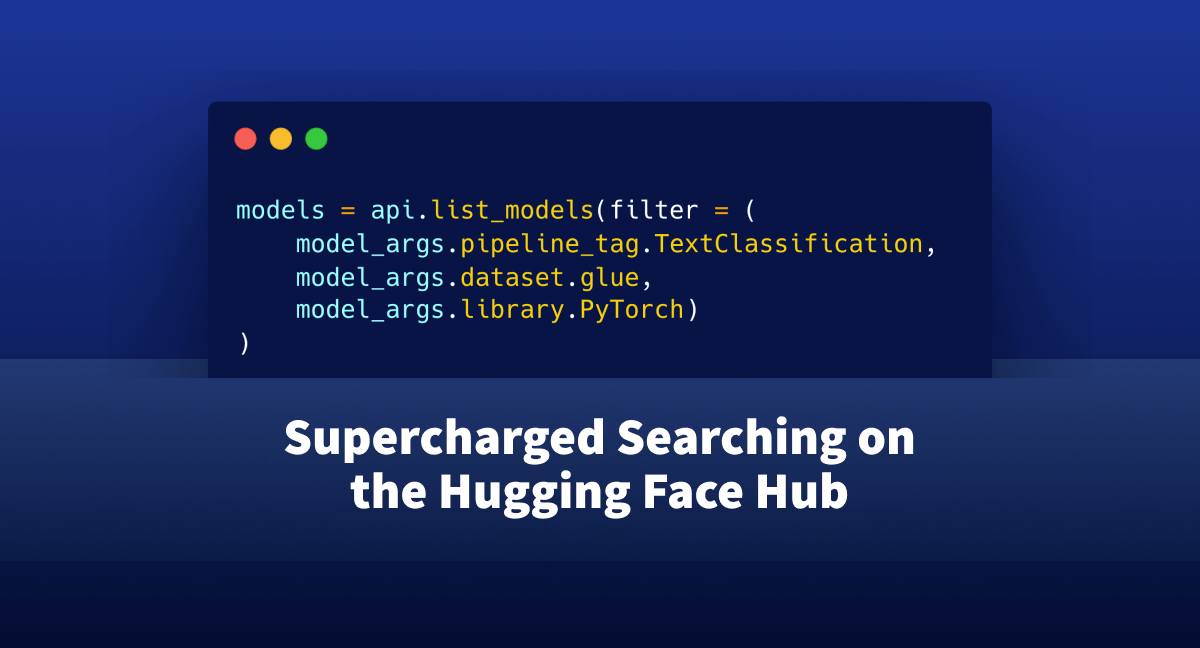
Hugging Face Hub-ის ძიების გამარტივება: პროგრამული ინტერფეისის ახალი შესაძლებლობები
სტატიაში წარმოდგენილია `huggingface_hub` ბიბლიოთეკის ახალი ფუნქციები, `ModelSearchArguments` და `ModelFilter`, რომლებიც მნიშვნელოვნად ამარტივებს Hugging Face Hub-ზე AI მოდელებისა და მონაცემთა ნაკრებების ძიებას პირდაპირ Python-ის ან Jupyter-ის გარემოდან. ეს სიახლე დეველოპერებს საშუალებას აძლევს, არ დატოვონ IDE და ეფექტურად მართონ რთული მოთხოვნები, რაც მნიშვნელოვნად აუმჯობესებს სამუშაო პროცესს.
შეზღუდული სხივური ძიება: კონტროლი ტექსტის გენერაციის პროცესზე
ეს სტატია განიხილავს ტექსტის გენერაციის გაუმჯობესებულ მეთოდს – შეზღუდულ სხივურ ძიებას (constrained beam search). ჩვეულებრივი სხივური ძიებისგან განსხვავებით, ეს მეთოდი საშუალებას გვაძლევს ზუსტი კონტროლი მოვახდინოთ გენერირებულ გამოსავალზე. ის წყვეტს იმ გამოწვევებს, როდესაც საჭიროა კონკრეტული სიტყვების ან ფრაზების ჩართვა, მრავალი შეზღუდვის დაწესება ან ალტერნატიული სიტყვის ფორმების გათვალისწინება (განმყოფი შეზღუდვები). ამ მიდგომით, ტექსტის გენერაცია ხდება უფრო კონტექსტზე მორგებული და მომხმარებლის მი
PatchTSMixer: IBM Research-ისა და Hugging Face-ის რევოლუციური მოდელი დროითი სერიების მოდელირებისთვის
IBM Research-მა Hugging Face-თან ერთად წარმოადგინა PatchTSMixer, ინოვაციური მოდელი, რომელიც Transformers ბიბლიოთეკაშია ინტეგრირებული. ეს მოდელი შექმნილია მრავალვარიანტული დროითი სერიების ეფექტური მოდელირებისთვის, მსუბუქი შერევის გამოყენებით პაჩებს, არხებსა და დამალულ მახასიათებლებს შორის. PatchTSMixer მნიშვნელოვნად აღემატება არსებულ MLP და Transformer მოდელებს პროგნოზირებაში, აჩვენებს 8-60%-იან გაუმჯობესებას და ამცირებს მეხსიერების მოხმარებასა და შესრულების დროს. იგი მხარს უჭერს ტრანსფერულ სწავლ

Intel Xeon-ზე StarCoder-ის 7X-ზე მეტი დაჩქარება: LLM-ების ოპტიმიზაციის ახალი ეტაპი
კოდის გენერირების მოდელების მზარდი პოპულარობის ფონზე, ეს სტატია წარმოგიდგენთ დიდი ენობრივი მოდელების (LLM) ოპტიმიზაციის უახლეს შედეგებს Intel Xeon-ზე, განსაკუთრებული აქცენტით პოპულარულ StarCoder მოდელზე. ნაჩვენებია StarCoder-15B მოდელის 7-ჯერ მეტი ინფერენსის დაჩქარება Intel-ის მე-4 თაობის Xeon პროცესორებზე 8-ბიტიანი და 4-ბიტიანი კვანტიზაციისა და ასისტენტური გენერაციის ინტეგრაციის გზით. კვლევა ასევე ხაზს უსვამს SmoothQuant ალგორითმის გამოყენებას და მის დადებით გავლენას მოდელის სიზუსტესა და წარმად
დიდი ენობრივი მოდელების ოპტიმიზაცია Intel Xeon-ზე: StarCoder-ის აჩქარება კოდის გენერაციისთვის
სტატია მიმოიხილავს კოდის გენერაციის მოდელების, როგორიცაა StarCoder და Code Llama, მზარდ პოპულარობას და LLM-ების ოპტიმიზაციის ძალისხმევას ხელმისაწვდომობის გაზრდის მიზნით. ხაზგასმულია Intel-ის მიღწევა StarCoder-15B მოდელის 7-ჯერ მეტი ინფერენციის აჩქარებაში მე-4 თაობის Intel Xeon პროცესორებზე, 8-ბიტიანი და 4-ბიტიანი კვანტიზაციის ინტეგრაციით ასისტირებულ გენერაციასთან ერთად. განხილულია Intel AMX-ის როლი, SmoothQuant-ისა და WOQ კვანტიზაციის ტექნიკები, ასევე პროდუქტიულობის შეფასებები HumanEval-ისა და M
წარმოგიდგენთ StarCoder2-ს: ინოვაცია პროგრამირების ენობრივ მოდელებში
StarCoder2 არის ღია კოდის დიდი ენობრივი მოდელების (LLM) ოჯახი, შექმნილი კოდის გენერაციისა და ანალიზისთვის. ის ხელმისაწვდომია სამი ზომის ვარიანტში – 3B, 7B და 15B პარამეტრით. ფლაგმანი StarCoder2-15B მოდელი გაწვრთნილია 4 ტრილიონზე მეტ ტოკენსა და 600-ზე მეტ პროგრამირების ენაზე The Stack v2 მონაცემთა ბაზიდან, რაც მას თავის ზომის კლასში საუკეთესოდ აქცევს და კონკურენციას უწევს 33B+ ზომის მოდელებს. პროექტი არის BigCode-ის თანამშრომლობის ნაწილი, რომელიც მიზნად ისახავს კოდისთვის განკუთვნილი LLM-ების პასუ

მაღალი წარმადობისა და საიმედოობის შენარჩუნება: Hugging Face-ის ინფრასტრუქტურის ძირითადი ინსტრუმენტები
ეს სტატია დეტალურად განიხილავს Hugging Face-ის წარმოების ინფრასტრუქტურის მხარდაჭერისთვის გამოყენებულ სამ ძირითად გაფრთხილებას, NAT კარიბჭეების მნიშვნელობას გამავალი ტრაფიკის მონიტორინგისთვის და ხარჯების ოპტიმიზაციის სტრატეგიებს. აღწერილია ქსელის ტრაფიკის მოცულობის მონიტორინგის სისტემა, რომელიც იძლევა დროულ გაფრთხილებებს და ხელს უწყობს ინფრასტრუქტურის კონფიგურაციის ოპტიმიზაციას. ასევე განხილულია Hugging Face-ის დახვეწილი ლოგირების ინფრასტრუქტურა (Filebeat, Logstash, Elasticsearch), რომელიც უზრუნვ
როგორ შევქმნათ მუსიკალური ფლეილისტი ტექსტური მოთხოვნით: Sentence Transformers და Gradio
ეს სტატია განმარტავს, თუ როგორ შეიძლება Sentence Transformers ბიბლიოთეკის სემანტიკური ძიების ფუნქციონალის გამოყენება სიმღერების ფლეილისტების შესაქმნელად ტექსტური მოთხოვნის საფუძველზე. აღწერილია წინადადების ემბედინგების გენერირება, მოდელის შერჩევა (მაგ. MS MARCO), გრძელი ტექსტების ლექსებად დაყოფა და ემბედინგების გამოყენება ძიებისთვის. პროექტი განხორციელებულია Gradio აპლიკაციის სახით, რომელიც ჰოსტირებულია Hugging Face Spaces-ზე, რაც მომხმარებლებს საშუალებას აძლევს ინტერაქტიულად მოძებნონ სიმღერები

TensorFlow-ში ტექსტის გენერაციის დაჩქარება XLA-ს მეშვეობით
სტატია მიმოიხილავს დიდი ენობრივი მოდელების (LLM) განვითარებას და მათ ტექსტის გენერაციის შესაძლებლობებს. დეტალურად არის განხილული Hugging Face-ის `transformers` ბიბლიოთეკაში ტექსტის გენერაციის საფუძვლები TensorFlow-ს გამოყენებით, მათ შორის დეტერმინისტული და სტოქასტური მეთოდები, სემპლინგის კონტროლი და Beam Search. მთავარი აქცენტი გაკეთებულია TensorFlow-ში ტექსტის გენერაციის ოპტიმიზაციაზე XLA (Accelerated Linear Algebra) კომპაილერის მეშვეობით, რომელიც მნიშვნელოვნად აჩქარებს პროცესს და ამცირებს დაყო

ხელოვნური ინტელექტი უჯრედის მოდელირებაში: გენის გაჩუმების ეფექტის პროგნოზირება CRISPR-ით
„ვირტუალური უჯრედის გამოწვევა“ მიზნად ისახავს ისეთი ხელოვნური ინტელექტის მოდელის შექმნას, რომელიც შეძლებს CRISPR-ის გამოყენებით გენის გაჩუმების შედეგად უჯრედზე მიღებული ეფექტების პროგნოზირებას, ფიზიკური, ძვირადღღირებული ექსპერიმენტების საჭიროების გარეშე. გამოწვევისთვის Arc-მა შეაგროვა 300 ათასი ერთუჯრედოვანი რნმ სეკვენირების პროფილის მონაცემთა ნაკრები. ამ პროცესში მნიშვნელოვანი სირთულეებია უჯრედის მდგომარეობის გაზომვის შეუძლებლობა ცვლილებამდე და მის შემდეგ, რაც მოითხოვს საკონტროლო უჯრედების გამო
AI-ის როლი გენის გაჩუმების პროგნოზირებაში: ვირტუალური უჯრედის გამოწვევა
თანამედროვე კვლევები მიზნად ისახავს ხელოვნური ინტელექტის (AI) მოდელის შექმნას, რომელიც CRISPR-ის გამოყენებით გენის გაჩუმების უჯრედზე ზემოქმედებას იწინასწარმეტყველებს. „ვირტუალური უჯრედის გამოწვევა“ ცდილობს გადალახოს ფიზიკური ექსპერიმენტების სირთულეები და მაღალი ღირებულება, რაც საშუალებას მისცემს ათასობით წამლის კანდიდატის ტესტირებას ვირტუალურ გარემოში. Arc-ის მიერ შეგროვებული 300 ათასი ერთუჯრედოვანი რნმ-ის სექვენირების პროფილის მონაცემთა ნაკრები გამოიყენება ნერვული ქსელების სავარჯიშოდ. სტატია ას

NVIDIA-ის AI-Q Blueprint ლიდერთა დაფაზე: ღია კოდის AI-ს ტრიუმფი DeepResearch Bench-ზე
NVIDIA-ის AI-Q Blueprint, წამყვანი პორტატული, ღია სიღრმისეული კვლევითი აგენტი, პირველ ადგილზე გავიდა Hugging Face-ის „LLM ძიებით“ ლიდერთა დაფის სათავეში DeepResearch Bench-ზე. ეს მიღწევა ადასტურებს, რომ დეველოპერებისთვის ხელმისაწვდომ მოდელებს შეუძლიათ უზრუნველყონ მოწინავე აგენტური სამუშაო პროცესები, რომლებიც კონკურენციას უწევს ან აღემატება დახურულ ალტერნატივებს გამჭვირვალობისა და კონტროლის შენარჩუნებით. AI-Q აერთიანებს ორ მაღალპროდუქტიულ Llama 3.3 LLM-ს, რაც უზრუნველყოფს გრძელკონტექსტურ ინფორმაც
StarCoder2-15B-Instruct: ახალი ეტალონი კოდის ხელოვნური ინტელექტისთვის თვით-განვითარების გზით
ახალი ენა-მოდელი, StarCoder2-15B-Instruct, აჩვენებს გასაოცარ შედეგებს კოდის გენერაციაში, უსწრებს ისეთ მძლავრ მოდელებს, როგორიცაა CodeLlama-70B-Instruct და აღწევს 72.6 HumanEval ქულას. მისი წარმატების საიდუმლო თვით-მორგების (self-alignment) ინოვაციურ მეთოდოლოგიაში მდგომარეობს, რაც საშუალებას აძლევს მოდელს ეფექტურად ისწავლოს საკუთარი გენერირებული მონაცემებიდან, ძლიერი „მასწავლებელი“ მოდელების გამოყენების გარეშე. ეს მიდგომა გულისხმობს ინსტრუქციების თვით-გენერირებას და საკუთარი კოდის ტესტირებას, რაც
კონტრასტული ძიება: ინოვაციური მიდგომა ბუნებრივი და თანმიმდევრული ტექსტის გენერაციაში
ტექსტის გენერაციის არსებული მეთოდები ხშირად აწყდებიან პრობლემებს, როგორიცაა გამეორებები და სემანტიკური შეუსაბამობა. კონტრასტული ძიება (Contrastive Search) წარმოადგენს ახალ დეკოდირების მეთოდს, რომელიც აბალანსებს ენის მოდელის ნდობასა და კონტექსტთან მსგავსებას, რათა შექმნას მაღალი ხარისხის, გრამატიკულად გამართული და სემანტიკურად თანმიმდევრული ტექსტი.
ღია Embedding მოდელების განთავსება Amazon SageMaker-ზე Hugging Face Embedding კონტეინერის გამოყენებით
ეს ბლოგი დეტალურად აღწერს, თუ როგორ უნდა განათავსოთ ღია Embedding მოდელები, როგორიცაა Snowflake Arctic Embed, Amazon SageMaker-ზე ინფერენციისთვის, ახალი Hugging Face Embedding კონტეინერის გამოყენებით. სტატია მოიცავს განვითარების გარემოს დაყენებას, კონტეინერის მოძიებას, მოდელის განთავსებას და მისი მუშაობის შეფასებას როგორც CPU, ასევე GPU ინსტანციებზე, ხაზს უსვამს Text Embedding Inference (TEI)-ის ეფექტურობას და ხარჯ-ეფექტურობას.

Meta-მ Gaia2 წარმოადგინა: ახალი ბენჩმარკი AI აგენტებისთვის
კომპანია Meta-მ წარმოადგინა Gaia2, ახალი აგენტური ბენჩმარკი, რომელიც GAIA-ს გაგრძელებაა და მიზნად ისახავს ხელოვნური ინტელექტის აგენტების მნიშვნელოვნად უფრო რთული ქცევების ანალიზს. Gaia2 გამოვიდა Meta-ს ღია Agents Research Environments (ARE) ფრეიმვორქთან ერთად, რაც საშუალებას იძლევა აგენტების გაშვებას, გამართვას და შეფასებას რეალური სამყაროს მსგავს პირობებში. ბენჩმარკი აფასებს აგენტებს ინტერაქციულ ქცევაში, ბუნდოვანი ან დროში შეზღუდული მოთხოვნების შესრულებაში, ხმაურიან გარემოში ადაპტირებასა და ხელ

Hugging Face მონაცემთა ნაკრებების ძებნის ოთხ ახალ ფუნქციას წარმოგიდგენთ
Hugging Face განაგრძობს Dataset Hub-ის გაუმჯობესებას და Dataset Search-ისთვის ოთხ ახალ ფუნქციას აცხადებს. ეს სიახლეები მოიცავს მონაცემთა მოდალობის (ტიპის) მიხედვით ფილტრაციას, სტრიქონების რაოდენობის მიხედვით ძებნას, მონაცემთა ფორმატების ფილტრაციას და ბიბლიოთეკებთან თავსებადობის მიხედვით ძებნას, რაც მომხმარებლებს საშუალებას მისცემს, უფრო ეფექტურად იპოვონ სასურველი ღია მონაცემთა ნაკრებები.

Nvidia-ს ბრალი ედება ხელოვნური ინტელექტის მოდელების გასაწვრთნელად პირატული წიგნების გამოყენებაში
განახლებული სარჩელის მიხედვით, Nvidia-ს ბრალი ედება მილიონობით პირატული წიგნის შეგნებულად გამოყენებაში თავისი ხელოვნური ინტელექტის მოდელების გასაწვრთნელად, მას შემდეგ, რაც კომპანია დაუკავშირდა საკამათო „ჩრდილოვან ბიბლიოთეკას“ Anna’s Archive. ავტორები საავტორო უფლებების დარღვევისთვის კომპენსაციას ითხოვენ. ეს ფაქტი კითხვებს აჩენს ტექნოლოგიური კომპანიების ეთიკისა და მონაცემების მიმართ სასოწარკვეთილების შესახებ, მიუხედავად იმისა, რომ მათ გაფრთხილება ჰქონდათ მიღებული შინაარსის უკანონობის შესახებ.
MIT-ის მკვლევარი AMR-ის წინააღმდეგ სინთეზურ ბიოლოგიასა და ხელოვნურ ინტელექტს იყენებს
MIT-ის პროფესორი ჯეიმს ჯ. კოლინზი მრავალდისციპლინურ კვლევით პროექტს უძღვება, რომელიც ანტიმიკრობული რეზისტენტობის (AMR) მზარდი გლობალური საფრთხის წინააღმდეგ სინთეზურ ბიოლოგიასა და გენერაციულ ხელოვნურ ინტელექტს იყენებს. Jameel Research-ის მიერ დაფინანსებული 3-წლიანი, 3 მილიონი დოლარის ღირებულების პროექტი მიზნად ისახავს პროგრამირებადი ანტიბაქტერიულების შემუშავებას ძირითადი პათოგენების წინააღმდეგ. კვლევა ფოკუსირებულია ხელოვნური ინტელექტის გამოყენებით მცირე ცილების შექმნაზე, რომლებიც მიზანმიმართულად

Google-ის გაფრთხილება: მარკდაუნი [Markdown] AI ქროლერებისთვის – კარგი იდეაა თუ „სულელური“?
Google Search Advocate ჯონ მიულერი [John Mueller] მკაცრად ეწინააღმდეგება იდეას, რომ ხელოვნური ინტელექტის (AI) დიდი ენობრივი მოდელების ქროლერებს [LLM crawlers] Markdown ფაილები მიეწოდოთ HTML-ის ნაცვლად. მიულერის აზრით, ეს მიდგომა, რომელიც ტოკენების მოხმარების შემცირებას ისახავს მიზნად, სერიოზულ ტექნიკურ და სტრუქტურულ პრობლემებს შექმნის საძიებო სისტემებისთვის.