Twitter-ზე სენტიმენტების ანალიზი: დამწყებთათვის სრული გზამკვლევი
ეს გზამკვლევი მოიცავს ყველაფერს, რაც უნდა ისწავლოთ Twitter-ზე სენტიმენტების ანალიზის დასაწყებად, როგორც პროგრამისტებისთვის, ასევე არაპროგრამისტებისთვის. თქვენ გაეცნობით Inference API-ის გამოყენებას კოდის რამდენიმე ხაზით ან Zapier-ის, უ-კოდო ხელსაწყოს მეშვეობით, ტვიტების შესაგროვებლად, გასაანალიზებლად და შედეგების Google Sheets-ში გასაგზავნად. ისწავლეთ, როგორ გამოიყენოთ მანქანური სწავლება ბრენდის მონიტორინგისთვის და მომხმარებლის უკუკავშირის გასაანალიზებლად.
Twitter-ზე სენტიმენტების ანალიზი: სრული გზამკვლევი
ეს გზამკვლევი წარმოგიდგენთ Twitter-ზე სენტიმენტების ანალიზის ყოვლისმომცველ, ნაბიჯ-ნაბიჯ პროცესს, რომელიც განკუთვნილია როგორც პროგრამისტებისთვის, ასევე არაპროგრამისტებისთვის. ის განმარტავს სენტიმენტების ანალიზის არსს, მის მნიშვნელობას ბიზნესისთვის და გვიჩვენებს, თუ როგორ შეიძლება ისეთი ხელსაწყოების გამოყენება, როგორიცაა Inference API, Zapier და Python-ის ბიბლიოთეკები, რათა ტვიტებიდან ღირებული ინფორმაცია მოვიპოვოთ, მომხმარებელთა უკუკავშირი აღმოვაჩინოთ და ბრენდის ხსენებებს რეალურ დროში დავაკვირდეთ.
Gradio-ს გადატვირთვის რეჟიმი: ხელოვნური ინტელექტის აპლიკაციების სწრაფი შექმნა
ეს სტატია განმარტავს Gradio-ს გადატვირთვის რეჟიმის (reload mode) მუშაობის პრინციპს, რაც დეველოპერებს საშუალებას აძლევს, ავტომატურად განაახლონ კოდის ცვლილებები სერვერის გადატვირთვის გარეშე. აღწერილია, თუ როგორ შეიძლება ამ რეჟიმის გამოყენება ხელოვნური ინტელექტის აპლიკაციის სწრაფად შესაქმნელად Hugging Face Inference API-სა და LLM-ების მეშვეობით, რომელიც დოკუმენტების სურათებიდან შეკითხვებზე პასუხებს ბუნებრივ ენაზე გასცემს.

მეტყველების ამოცნობის (ASR) და დიარიზაციის პაიპლაინების დაყენება Hugging Face Inference Endpoints-ზე სპეკულაციური დეკოდირებით
ეს სტატია განმარტავს, თუ როგორ ხდება მეტყველების ავტომატური ამოცნობის (ASR), დიარიზაციისა და სპეკულაციური დეკოდირების მოდულარული პაიპლაინების კონფიგურაცია Hugging Face Inference Endpoints-ის გამოყენებით. ის დეტალურად აღწერს Pyannote მოდელის ინტეგრაციას დიარიზაციისთვის, Flash Attention 2-ის გამოყენებას და ინფერენსის დაჩქარების ტექნიკებს, ასევე კონფიგურაციის მოქნილობას და წარმადობის გაუმჯობესებას სხვადასხვა აუდიო სიგრძისთვის.

BLOOM ინფერენსის ოპტიმიზაცია GPU-ებზე: წარმადობის ბენჩმარკინგი
ეს სტატია განიხილავს BLOOM ხელოვნური ინტელექტის მოდელის ინფერენსის ოპტიმიზაციას სხვადასხვა GPU კონფიგურაციებზე. მოცემულია აპარატურული მოთხოვნები 352GB bf16 წონებისთვის, სადაც რეკომენდებულია 8x80GB A100 GPU-ები, თუმცა განიხილება ალტერნატივებიც. სტატია აანალიზებს მოდელის ჩატვირთვის დროს და ტოკენების გენერირების წარმადობას (throughput) ისეთი გადაწყვეტების გამოყენებით, როგორიცაა Deepspeed-Inference და Accelerate, ასევე 8-ბიტიანი კვანტიზაცია მეხსიერების შესამცირებლად. ბენჩმარკინგის შედეგები აჩვენებს
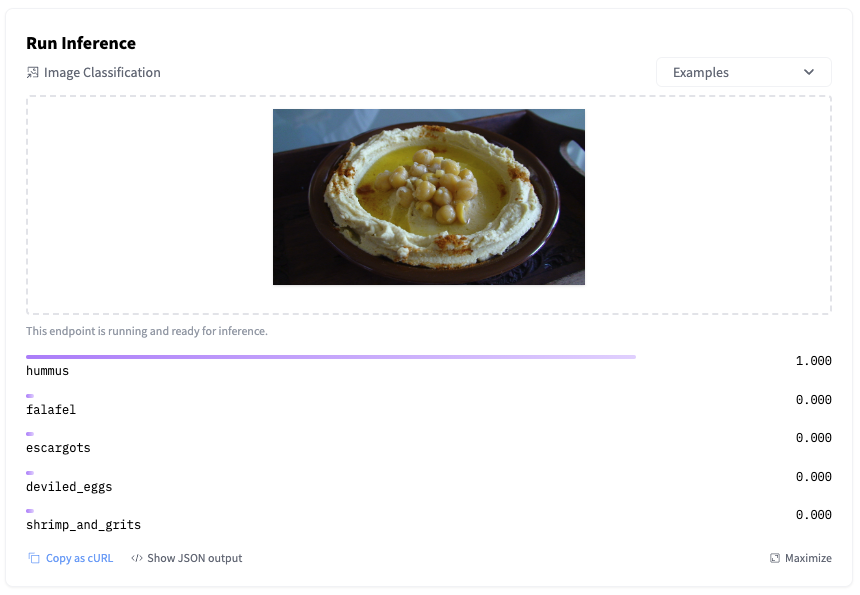
Hugging Face Inference Endpoints: ML მოდელების პროდუქციაში განთავსების გამარტივება
ეს სტატია განმარტავს, თუ როგორ ამარტივებს Hugging Face Inference Endpoints მანქანური სწავლების (ML) მოდელების პროდუქციაში განთავსების რთულ პროცესს. სერვისი საშუალებას გაძლევთ, რამდენიმე დაწკაპუნებით განათავსოთ მოდელები უშუალოდ Hugging Face Hub-იდან მართულ ინფრასტრუქტურაზე, რაც უზრუნველყოფს სიმარტივეს, უსაფრთხოებას და მასშტაბურობას. სტატია დეტალურად აღწერს, თუ როგორ ხდება დაცული და პირადი Endpoint-ების კონფიგურაცია AWS-ზე.

Hugging Face-ი და AMD ხელოვნური ინტელექტის განვითარებას AMD Instinct MI300 GPU-ების ინტეგრაციით აძლიერებენ
Hugging Face-ი და AMD აცხადებენ თანამშრომლობის გაფართოებას უახლესი თაობის AMD Instinct MI300 GPU სერვერების Hugging Face პლატფორმაში სრულფასოვანი ინტეგრაციის მიზნით. ეს ნაბიჯი დეველოპერებს საშუალებას მისცემს, მარტივად განათავსონ და მაქსიმალური წარმადობით გამოიყენონ ხელოვნური ინტელექტის მოდელები, კოდის შეცვლის გარეშე, ადგილობრივი გარემოდან დაწყებული Azure-ის საწარმოო ვირტუალურ მანქანებამდე. ინტეგრაცია მოიცავს CI/CD-ის გაუმჯობესებას, TGI-ის (text-generation-inference) ოპტიმიზაციას Meta Llama ოჯახი
AWS Inferentia2 აფართოებს ხელოვნური ინტელექტის შესაძლებლობებს Hugging Face-ის მომხმარებლებისთვის
Amazon Web Services (AWS) აცხადებს, რომ მისი უახლესი მანქანური სწავლების ჩიპი, Inferentia2, სრულად ხელმისაწვდომია Hugging Face Hub-ის მომხმარებლებისთვის. ეს ინტეგრაცია მნიშვნელოვნად ამარტივებს დიდი ენობრივი მოდელების (LLMs) და სხვა AI მოდელების განთავსებასა და გამოყენებას AWS SageMaker-ზე და Hugging Face Inference Endpoints-ის მეშვეობით. Inferentia2 ინსტანციები გვთავაზობს მაღალ წარმადობას, ხარჯთეფექტურობას და მხარდაჭერას 100,000-ზე მეტი მოდელისა და ამოცანისთვის, მათ შორის Llama 3-ისთვის, რაც ხელ
მნიშვნელოვანი განახლებები ჩვენს ფასწარმოქმნასა და სერვისებში
ჩვენს ფასწარმოქმნის გვერდზე მნიშვნელოვანი ცვლილებები განხორციელდა: Inference API სერვისი სრულად უფასო გახდა, დაინერგა „Inference Endpoints“ კორპორატიული გადაწყვეტილებებისთვის, ხოლო Spaces-ისთვის აპარატურული განახლებები მოხდა. ბილინგი ცენტრალიზებულია, ახალი სერვისებისთვის მხოლოდ ბარათის დამატებაა საჭირო, ყოველთვიური ინვოისებით. ჩვენ ვახდენთ მონეტიზაციას AI-სთვის გამოთვლით რესურსებზე მარტივი წვდომის უზრუნველყოფით.

Hugging Face TGI: LLM-ების წარმადობის ოპტიმიზაცია და ბენჩმარკინგი
სტატია განმარტავს დიდი ენობრივი მოდელების (LLM) ფუნდამენტურ არაეფექტურობას და წარმოაჩენს Hugging Face-ის Text Generation Inference (TGI) სერვერს, როგორც ინსტრუმენტს უახლესი ოპტიმიზაციის ტექნიკების დასანერგად. ის ხაზს უსვამს ბენჩმარკინგის მნიშვნელობას სხვადასხვა გამოყენების შემთხვევებისთვის, როგორიცაა RAG და ჩატბოტები, და განმარტავს ლატენტურობისა და გამტარუნარიანობის, როგორც ორთოგონალური მეტრიკების, როლს. ავტორი გვიჩვენებს, თუ როგორ შეიძლება TGI ბენჩმარკინგის ინსტრუმენტის გამოყენება Hugging Face
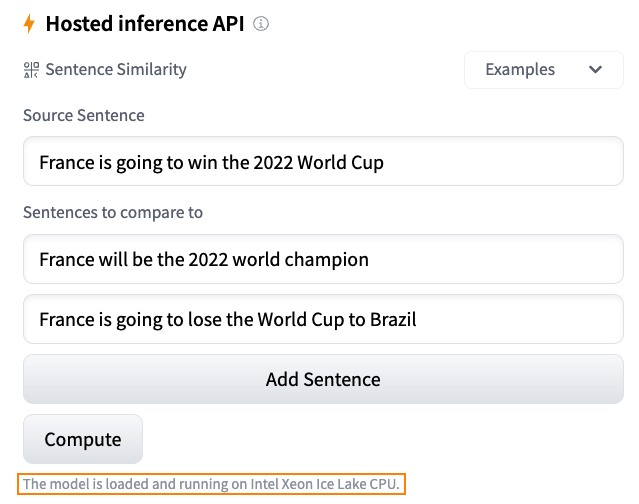
Hugging Face-ის ინფერენსის გადაწყვეტილებები: სიმარტივე, ხარისხი და ოპტიმალური ხარჯები
სტატია მიმოიხილავს Hugging Face-ის მიდგომას მანქანური სწავლების (ML) მოდელების შემუშავებისა და გაშვების გამარტივებისადმი, უმაღლესი ხარისხისა და ოპტიმალური ხარჯების შენარჩუნებით. იგი ხაზს უსვამს ინფერენსის სხვადასხვა უფასო და ფასიან ვარიანტს, მათ შორის Inference Widget-ს, Inference API-ს, Inference Endpoints-ს (სამრეწველო გამოყენებისთვის უსაფრთხოებითა და მასშტაბურობით) და Spaces-ს (დემონსტრაციებისთვის UI-ით). ასევე აღნიშნულია Intel-ის სპონსორობა უფასო CPU-ზე დაფუძნებული ინფერენსის გადაწყვეტილებებ
Hugging Face-ის ინოვაციები: მანქანური სწავლის მოდელების განთავსების გამარტივებული გზები
Hugging Face წარმოგიდგენთ ინოვაციურ გადაწყვეტილებებს მანქანური სწავლის (ML) განვითარებისა და ოპერაციების გასამარტივებლად, უმაღლესი ხარისხის სტანდარტების დათმობის გარეშე. სტატია მიმოიხილავს Inference Widget-ს, Inference API-ს, Inference Endpoints-სა და Spaces-ს, როგორც ინსტრუმენტებს ML მოდელების მარტივი ტესტირების, განთავსებისა და ოპტიმიზაციისთვის. ხაზგასმულია Intel-თან პარტნიორობა, რაც უზრუნველყოფს უფასო CPU-ზე დაფუძნებულ ინფერენსის გადაწყვეტილებებს და მომხმარებლებს Intel Xeon Ice Lake არქიტექტუ

Scaleway Hugging Face Hub-ის დასკვნის (Inference) პროვაიდერებს უერთდება
Scaleway, ღრუბლოვანი სერვისების წამყვანი პროვაიდერი, Hugging Face Hub-ის მხარდაჭერილი დასკვნის (Inference) პროვაიდერების ეკოსისტემას შეუერთდა. ეს ინტეგრაცია აფართოებს serverless inference-ის შესაძლებლობებს Hub-ზე, მომხმარებლებს უადვილებს წვდომას პოპულარულ ღია მოდელებზე, როგორიცაა gpt-oss, Qwen3 და Gemma 3. Scaleway გთავაზობთ კონკურენტულ ფასებს, ევროპულ მონაცემთა ცენტრებს და მოწინავე ფუნქციებს, რაც უზრუნველყოფს სწრაფ და უსაფრთხო AI ინფერენსს.
ღია Embedding მოდელების განთავსება Amazon SageMaker-ზე Hugging Face Embedding კონტეინერის გამოყენებით
ეს ბლოგი დეტალურად აღწერს, თუ როგორ უნდა განათავსოთ ღია Embedding მოდელები, როგორიცაა Snowflake Arctic Embed, Amazon SageMaker-ზე ინფერენციისთვის, ახალი Hugging Face Embedding კონტეინერის გამოყენებით. სტატია მოიცავს განვითარების გარემოს დაყენებას, კონტეინერის მოძიებას, მოდელის განთავსებას და მისი მუშაობის შეფასებას როგორც CPU, ასევე GPU ინსტანციებზე, ხაზს უსვამს Text Embedding Inference (TEI)-ის ეფექტურობას და ხარჯ-ეფექტურობას.
როგორ გავუშვათ Stable Diffusion Apple-ის მოწყობილობებზე Core ML-ის გამოყენებით
Apple-ის რეპოზიტორიუმი გვთავაზობს Stable Diffusion-ის კონვერტაციის სკრიპტებსა და დასკვნის (inference) კოდს Core ML-ისთვის. სიმარტივისთვის, მოდელების Core ML ვერსიები უკვე გადაყვანილია და ხელმისაწვდომია Hugging Face Hub-ზე. ასევე, შეიქმნა მშობლიური Swift აპლიკაცია, რომელიც Mac App Store-სა და ღია კოდის სახითაა გამოქვეყნებული, რათა მომხმარებლებმა მარტივად გაუშვან Stable Diffusion საკუთარ აპარატურაზე. სტატია დეტალურად აღწერს, თუ როგორ გამოიყენოთ კონვერტირებული წონები, ან თავად გადაიყვანოთ დამატებით
Google Cloud TPUs-ის ხელმისაწვდომობა Hugging Face-ზე: განცხადება და შემდგომი შეჩერება
Google Cloud TPUs-ის Hugging Face-ის Inference Endpoints-სა და Spaces-ზე ხელმისაწვდომობის შესახებ გაკეთდა განცხადება, რაც ხელოვნური ინტელექტის აპლიკაციების დაჩქარებას გვპირდებოდა. თუმცა, ამ ფუნქციის დანერგვიდან მალევე, ის დროებით შეჩერდა. ეს ინტეგრაცია მიზნად ისახავდა Google-ის ხელოვნური ინტელექტის აპარატურის, რომელიც ცნობილია თავისი მაღალი წარმადობითა და ეკონომიურობით, Hugging Face-ის მომხმარებლებისთვის მიწოდებას, მაგრამ ამჟამად მიუწვდომელია.