რატომ არღვევს Hugging Face-ის Transformers ბიბლიოთეკა DRY პრინციპს?
პროგრამული უზრუნველყოფის განვითარებაში ცნობილი „ნუ გაიმეორებ საკუთარ თავს“ (DRY) პრინციპის მიუხედავად, Hugging Face-ის Transformers ბიბლიოთეკა შეგნებულად უარს ამბობს მის გამოყენებაზე და იყენებს „ერთი მოდელის ფაილის პოლიტიკას“. ეს გადაწყვეტილება მიღებულია გარე კონტრიბუციების წახალისების, კოდის წაკითხვადობის გაუმჯობესების და მანქანური სწავლების სფეროს სწრაფი ევოლუციის გამო, რაც სტანდარტული ლოგიკური შაბლონების განსაზღვრას ართულებს.
PatchTSMixer: IBM Research-ისა და Hugging Face-ის რევოლუციური მოდელი დროითი სერიების მოდელირებისთვის
IBM Research-მა Hugging Face-თან ერთად წარმოადგინა PatchTSMixer, ინოვაციური მოდელი, რომელიც Transformers ბიბლიოთეკაშია ინტეგრირებული. ეს მოდელი შექმნილია მრავალვარიანტული დროითი სერიების ეფექტური მოდელირებისთვის, მსუბუქი შერევის გამოყენებით პაჩებს, არხებსა და დამალულ მახასიათებლებს შორის. PatchTSMixer მნიშვნელოვნად აღემატება არსებულ MLP და Transformer მოდელებს პროგნოზირებაში, აჩვენებს 8-60%-იან გაუმჯობესებას და ამცირებს მეხსიერების მოხმარებასა და შესრულების დროს. იგი მხარს უჭერს ტრანსფერულ სწავლ

Transformers ბიბლიოთეკა: ხელოვნური ინტელექტის მოდელების ინტეგრაციისა და სტანდარტიზაციის ახალი ეტაპი
Transformers, რომელიც 2019 წელს დაარსდა, გახდა ხელოვნური ინტელექტის მოდელების, განსაკუთრებით დიდი ენობრივი (LLM) და ვიზუალური ენობრივი (VLM) მოდელებთან მუშაობის სტანდარტული ბიბლიოთეკა Python ეკოსისტემაში. ის მხარს უჭერს 300-ზე მეტ არქიტექტურას, აქტიურად თანამშრომლობს სხვა ბიბლიოთეკებთან (როგორიცაა llama.cpp და MLX) თავსებადობის გასაუმჯობესებლად და მიზნად ისახავს წვლილის შეტანის ბარიერის შემცირებას ხელოვნური ინტელექტის საზოგადოებაში, რითაც ხელს უწყობს ეკოსისტემის სტანდარტიზაციას და ფრაგმენტაციის
Hugging Face Optimum: ტრანსფორმერების მოდელების ტრენინგისა და ინფერენსის დაჩქარება
BERT-ისა და Transformer-ის მოდელების გამოყენება სულ უფრო იზრდება სხვადასხვა სფეროში, თუმცა ისინი ხშირად ნელი და მოცულობითია. Hugging Face-მა შექმნა Optimum – გაფართოება, რომელიც ამ მოდელების ტრენინგსა და ინფერენსს აჩქარებს. Optimum უზრუნველყოფს ოპტიმიზებულ შესრულებას დაჩქარებულ აპარატურაზე, მათ შორის ONNX Runtime-თან ინტეგრაციით, რაც მომხმარებლებს საშუალებას აძლევს მარტივად გადავიდნენ სტანდარტული Transformers API-დან ოპტიმიზებულ ვერსიაზე, მოდელების კვანტიზაციისა და გრაფის ოპტიმიზაციის ჩათვლით.
მატრიოშკა Embeddings-ის მოდელები: მოქნილობა და ეფექტურობა ხელოვნურ ინტელექტში
ეს სტატია განიხილავს მატრიოშკა Embeddings-ის მოდელებს, რომლებიც გვთავაზობენ მოქნილობასა და ეფექტურობას ბუნებრივი ენის დამუშავებასა და ხელოვნურ ინტელექტში. განმარტებულია მათი მუშაობის პრინციპი, რომელიც რუსული მატრიოშკის თოჯინების მსგავსად, საშუალებას იძლევა, Embeddings-ის ზომა შემცირდეს ინფორმაციის მნიშვნელოვანი დაკარგვის გარეშე. სტატია ასევე მოიცავს პრაქტიკულ რჩევებს მათი გამოყენებისა და ტრენინგის მეთოდებზე, მათ შორის Sentence Transformers-ის ფარგლებში, ხაზს უსვამს მათ უპირატესობებს ტრადიციულ Em
Hugging Face: Gemma მოდელების PEFT-ით ოპტიმიზაცია
ამ პოსტში განხილულია, თუ როგორ შეიძლება Gemma მოდელების პარამეტრულად ეფექტური წვრილმანი მორგება (PEFT) Hugging Face Transformers-ისა და PEFT ბიბლიოთეკების გამოყენებით GPU-ებსა და Cloud TPU-ებზე. ეს ტექნიკა განსაკუთრებით გამოსადეგია მეხსიერებისა და გამოთვლითი რესურსების დაზოგვისთვის, რაც საშუალებას აძლევს მომხმარებლებს, მათ შორის მათ, ვინც Colab-სა და Kaggle-ზე მუშაობს, ოპტიმიზაცია გაუკეთონ მოდელებს საკუთარ მონაცემთა ნაკრებებზე დაბალი დანახარჯით. სტატია დეტალურად განიხილავს LoRA-სა და QLoRA-ს გამ
Hugging Face Optimum: ტრანსფორმერების მოდელების ოპტიმიზაცია და ONNX-ში ექსპორტი წარმოებისთვის
ეს სახელმძღვანელო დეტალურად აღწერს, თუ როგორ უნდა მოხდეს Transformers მოდელების ექსპორტირება ONNX ფორმატში Hugging Face Optimum ბიბლიოთეკის გამოყენებით, რათა მივაღწიოთ მაქსიმალურ ეფექტურობას წარმოების გარემოში. სტატია განმარტავს ONNX-ის, როგორც ღია სტანდარტის მნიშვნელობას, წარმოგიდგენთ Optimum-ის ფართო შესაძლებლობებს მოდელის ოპტიმიზაციისთვის და იკვლევს კონვერტაციის სხვადასხვა მეთოდს, მარტივი API-დან მოწინავე ფუნქციონალამდე.
ემბედინგები: ხელოვნური ინტელექტის მრავალფუნქციური ინსტრუმენტი სემანტიკური ძიებისთვის
ეს სტატია განმარტავს „ემბედინგების“ კონცეფციას – ინფორმაციის (ტექსტი, სურათი, აუდიო) რიცხვით წარმოდგენას, რომელიც მის სემანტიკურ მნიშვნელობას იჭერს. განხილულია ემბედინგების ძირითადი გამოყენება ხელოვნური ინტელექტის აპლიკაციებში, როგორიცაა საძიებო სისტემები, რეკომენდაციის სისტემები და ჩატბოტები, რაც შესაძლებელს ხდის სემანტიკური მსგავსების შეფასებას. სტატია დეტალურად აღწერს, თუ როგორ შეიძლება ემბედინგების გენერირება ღია კოდის ინსტრუმენტების, მაგალითად, Sentence Transformers ბიბლიოთეკისა და Hugging

Gemma 3n: მულტიმოდალური AI მოდელი საბოლოოდ ღია კოდის ბიბლიოთეკებში
Google-ის უახლესი მულტიმოდალური AI მოდელი, Gemma 3n, საბოლოოდ ხელმისაწვდომია ყველაზე პოპულარულ ღია კოდის ბიბლიოთეკებში, მათ შორის transformers & timm, MLX, llama.cpp და სხვებში. ეს გამოშვება მოიცავს ორ ზომას (E2B და E4B), რომლებიც გამოირჩევიან მაღალი ეფექტურობით VRAM-ის გამოყენების მხრივ და უზრუნველყოფენ შესანიშნავ ხარისხს. Gemma 3n არა მხოლოდ ენობრივ დეკოდერს, არამედ აუდიო და ვიზუალურ ენკოდერებსაც მოიცავს, რაც მას სრულყოფილ მულტიმოდალურ ინსტრუმენტად აქცევს დეველოპერებისთვის. სტატია დეტალურად აღ
Sentence Transformers-ის შესწავლა: ნულიდან პროექტამდე
ეს პოსტი წარმოგიდგენთ დეტალურ სახელმძღვანელოს Sentence Transformers-ის (ST) გამოყენებით ახალი ბიბლიოთეკის დაუფლებისთვის ნულიდან. განვიხილავთ ST-ის ძირითად ფუნქციონალს, მათ შორის წინადადების ვექტორების (embeddings), სემანტიკური ძიებისა და კოსინუსური მსგავსების კონცეფციებს. ხაზგასმულია, თუ რატომ არის ST ღირებული ინსტრუმენტი ხელმისაწვდომობის, სწავლის ეფექტურობისა და მრეწველობაში გამოყენების თვალსაზრისით. სტატია ასევე გვთავაზობს გამოცდილ სტრატეგიას პირველი დამოუკიდებელი პროექტის განსახორციელებლად და
სემანტიკური ძიება მუსიკაში: დასაკრავი სიების გენერირება Sentence Transformers-ითა და Gradio-თი
ეს სტატია განიხილავს, თუ როგორ შეიძლება Sentence Transformers-ის სემანტიკური ძიების გამოყენება მუსიკალური დასაკრავი სიების შესაქმნელად ტექსტური მოთხოვნების საფუძველზე. დეტალურად არის აღწერილი სიმღერის ტექსტების ემბედინგების გენერირებისა და შენახვის პროცესი, შესაბამისი მოდელების შერჩევა და Gradio აპლიკაციის იმპლემენტაცია, რომელიც მომხმარებლებს საშუალებას აძლევს ეძებონ სიმღერები სემანტიკური მსგავსების მიხედვით და იხილონ მათი ტექსტები.
როგორ შევქმნათ მუსიკალური ფლეილისტი ტექსტური მოთხოვნით: Sentence Transformers და Gradio
ეს სტატია განმარტავს, თუ როგორ შეიძლება Sentence Transformers ბიბლიოთეკის სემანტიკური ძიების ფუნქციონალის გამოყენება სიმღერების ფლეილისტების შესაქმნელად ტექსტური მოთხოვნის საფუძველზე. აღწერილია წინადადების ემბედინგების გენერირება, მოდელის შერჩევა (მაგ. MS MARCO), გრძელი ტექსტების ლექსებად დაყოფა და ემბედინგების გამოყენება ძიებისთვის. პროექტი განხორციელებულია Gradio აპლიკაციის სახით, რომელიც ჰოსტირებულია Hugging Face Spaces-ზე, რაც მომხმარებლებს საშუალებას აძლევს ინტერაქტიულად მოძებნონ სიმღერები
Hugging Face: მანქანური სწავლის სამყარო არატექნიკური მომხმარებლებისთვის
ეს გზამკვლევი მიზნად ისახავს მანქანური სწავლის (ML) ფუნდამენტური პრინციპების ხელმისაწვდომად ახსნას არატექნიკური მომხმარებლებისთვის, პითონის ცოდნის საჭიროების გარეშე. იგი დეტალურად განიხილავს Hugging Face-ის ეკოსისტემას, მათ შორის Transformers-ის ბიბლიოთეკას, Hugging Face Hub-ს და Spaces-ს, რომლებიც აადვილებს ML მოდელების გამოყენებასა და განლაგებას. ასევე განმარტებულია LLM-ებისთვის საჭირო GPU-ების დაქირავების პროცესი Hugging Face-ის მეშვეობით, Docker-ის შაბლონების მნიშვნელობა და ძირითადი პროგრამი

TensorFlow-ში ტექსტის გენერაციის დაჩქარება XLA-ს მეშვეობით
სტატია მიმოიხილავს დიდი ენობრივი მოდელების (LLM) განვითარებას და მათ ტექსტის გენერაციის შესაძლებლობებს. დეტალურად არის განხილული Hugging Face-ის `transformers` ბიბლიოთეკაში ტექსტის გენერაციის საფუძვლები TensorFlow-ს გამოყენებით, მათ შორის დეტერმინისტული და სტოქასტური მეთოდები, სემპლინგის კონტროლი და Beam Search. მთავარი აქცენტი გაკეთებულია TensorFlow-ში ტექსტის გენერაციის ოპტიმიზაციაზე XLA (Accelerated Linear Algebra) კომპაილერის მეშვეობით, რომელიც მნიშვნელოვნად აჩქარებს პროცესს და ამცირებს დაყო

Sentence Transformers: სრული გზამკვლევი მოდელების ტრენინგისა და ოპტიმიზაციისთვის
ეს სტატია გთავაზობთ დეტალურ სახელმძღვანელოს Sentence Transformers-ის მოდელების ვარჯიშისა და ოპტიმიზაციის შესახებ. განხილულია მოდელის არქიტექტურა, ემბედინგების შექმნა და მონაცემთა მომზადების გადამწყვეტი როლი, მათ შორის სხვადასხვა მონაცემთა ნაკრების ფორმატები, როგორებიცაა მსგავსება, პოზიტიური წყვილები, კლასიფიკაცია და ტრიპლეტები. ასევე აღწერილია მონაცემების მოდელისთვის გასაგებ ფორმატში კონვერტირების პროცესი.
Hugging Face-ის მიდგომა: Transformers-ის ათვისება TensorFlow-ში Keras-ისა და ტრანსფერული სწავლების მეშვეობით
სტატია განიხილავს Hugging Face-ის ფილოსოფიას TensorFlow-ის ინჟინრებისთვის, რომლებიც იყენებენ Transformers-ის ბიბლიოთეკას. ის აკრიტიკებს Keras-ის მაღალდონიანი API-ის გვერდის ავლის გავრცელებულ პრაქტიკას და ხაზს უსვამს მის მნიშვნელობას. სტატია განმარტავს, თუ როგორ შეიძლება მძლავრი, წინასწარ გაწვრთნილი მოდელების გამოყენება ტრანსფერული სწავლების გზით, რაც ამცირებს მონაცემების საჭიროებას და ზრდის სიზუსტეს. ასევე, აღწერილია Hugging Face-ის მოდელების ინტეგრაცია ნაცნობ Keras-ის მეთოდებთან, როგორიცაა `fit
SetFit: ეფექტური ჩარჩო Sentence Transformers-ის მცირემონაცემიან პირობებში დაზუსტებისთვის
Hugging Face, Intel Labs-თან და UKP Lab-თან პარტნიორობით, წარმოგიდგენთ SetFit-ს – ინოვაციურ ჩარჩოს Sentence Transformers-ის მცირემონაცემიან პირობებში ეფექტური დაზუსტებისთვის. SetFit აღწევს მაღალ სიზუსტეს მინიმალური მარკირებული მონაცემებით, არის სწრაფი საწვრთნელად, მრავალენოვანი და არ საჭიროებს პრომპტებს, რაც მას კონკურენტუნარიანს ხდის გაცილებით დიდ მოდელებთან შედარებით და მნიშვნელოვნად ამცირებს ღირებულებას. ის მდგრადია ხმაურის მიმართ და მნიშვნელოვნად უფრო ეფექტურად იყენებს მონაცემებს, ვიდრე სტან
Transformers Agents 2.0-ის გამოშვება: ახალი ეტაპი AI აგენტებში smolagents-თან ერთად
Hugging Face-ი აცხადებს Transformers Agents 2.0-ის გამოშვებას, რომელიც ახლა smolagents-ის სახელით იქნება ცნობილი. ეს განახლება წარმოგიდგენთ ორ ახალ აგენტს, რომლებსაც შეუძლიათ წარსული დაკვირვებების საფუძველზე რთული ამოცანების გადაჭრა. სისტემა გამიზნულია იყოს მკაფიო, მოდულარული და გამჭვირვალე, თემის გაზიარების ოფციებით. აღსანიშნავია მისი გაუმჯობესებული წარმადობა, რადგან Llama-3-70B-Instruct აგენტი აჯობებს GPT-4-ზე დაფუძნებულ აგენტებს GAIA-ს ლიდერთა სიაში. LLM-ებს ხშირად უჭირთ ლოგიკის, გამოთვლისა დ
„Transformers Agents 2.0“-ის (ახლა უკვე smolagents!) გამოშვება: აგენტების ახალი, მძლავრი ჩარჩო
Hugging Face-ი აცხადებს „Transformers Agents 2.0“-ის გამოშვებას, რომელიც ახლა დამოუკიდებელი ბიბლიოთეკა smolagents-ის სახით არის ხელმისაწვდომი. ეს განახლება წარმოგიდგენთ აგენტების ახალ ტიპებს, რომლებსაც შეუძლიათ წარსული დაკვირვებების საფუძველზე იტერაცია მოახდინონ რთული ამოცანების გადასაჭრელად, გამოირჩევიან გაუმჯობესებული შესრულებით (Llama-3-70B-Instruct აგენტები GPT-4-ზე უკეთეს შედეგებს აჩვენებენ GAIA Leaderboard-ზე) და აქცენტი კეთდება კოდის სიცხადეზე, მოდულარულობაზე და საზოგადოების ჩართულობაზე გ

Bloom მოდელის ოპტიმიზაცია: გზა 5x შეყოვნების შემცირებამდე და 50x გამტარუნარიანობამდე
ამ სტატიაში განხილულია Bloom-ის დიდი ენობრივი მოდელის (LLM) ოპტიმიზაციის პროცესი, რამაც გამოიწვია ინფერენციის შეყოვნების 5-ჯერ შემცირება და გამტარუნარიანობის 50-ჯერ გაზრდა. აღწერილია გამოწვევები, მათ შორის მოდელის `transformers` ბიბლიოთეკაში პორტირება, მკაცრი ტესტირების ნაკრების შექმნა, მონაცემთა სხვადასხვა ტიპებთან (bfloat16 vs float16) მუშაობა და ტენზორული პარალელიზმის საკითხები. საბოლოოდ, განიხილება ისეთი გადაწყვეტილებები, როგორიცაა `Megatron-Deepspeed` ტრენინგისთვის, მცირე მოდელების გამოყენე

Sentence Transformers-ის ოპტიმიზაცია: ძირითადი კომპონენტები და ეფექტური მოდელების შექმნა
ამ სტატიაში განხილულია Sentence Transformers-ის მოდელების ოპტიმიზაციის პროცესი, რომელიც მოიცავს მონაცემთა ნაკრებებს, დანაკარგის ფუნქციებს, ვარჯიშის არგუმენტებს, შემფასებლებსა და ახალ ტრენერს. თითოეული კომპონენტი დეტალურადაა აღწერილი მაგალითებთან ერთად, რათა დაგეხმაროთ ეფექტური მოდელების შექმნაში კონკრეტული ამოცანებისთვის, სხვადასხვა მსგავსების კონცეფციის გათვალისწინებით.

Transformers-ის დოკუმენტაციის მასშტაბური განახლება: რატომ გახდა ის აუცილებელი
Transformers-ის ბიბლიოთეკის დოკუმენტაცია, რომელიც თავდაპირველად მანქანური სწავლების ინჟინრებსა და მკვლევრებზე იყო მორგებული, ხელოვნური ინტელექტის (AI) სწრაფი განვითარების ფონზე მოუწესრიგებელი და მოძველებული გახდა. მიმდინარეობს მასშტაბური რედიზაინი, რათა დოკუმენტაცია გახდეს კოდზე ორიენტირებული, გადაწყვეტილებებისკენ მიმართული და მომხმარებელზე მორგებული, განსაკუთრებით კი დეველოპერებისთვის. მიზანია, უზრუნველყოს მისი ზრდა და ადაპტაცია მომავალ საჭიროებებთან, სიხისტე კი მოქნილობით ჩანაცვლდეს.

swift-transformers 1.0: ლოკალური ხელოვნური ინტელექტის ახალი ერა Apple Silicon-ზე
`swift-transformers` ბიბლიოთეკამ გამოუშვა ვერსია 1.0, რაც მის სტაბილურობასა და Apple Silicon პლატფორმებზე, iPhone-ების ჩათვლით, ლოკალური მანქანური სწავლების მოდელების უწყვეტი ინფერენციის მხარდაჭერის მზადყოფნას ადასტურებს. განახლება მიზნად ისახავს საზოგადოებისთვის მაქსიმალური სარგებლის მოტანას, მომავალი განვითარების საფუძვლების ჩაყრას და განსაკუთრებულ ყურადღებას უთმობს MLX-სა და აგენტურ გამოყენების შემთხვევებს.
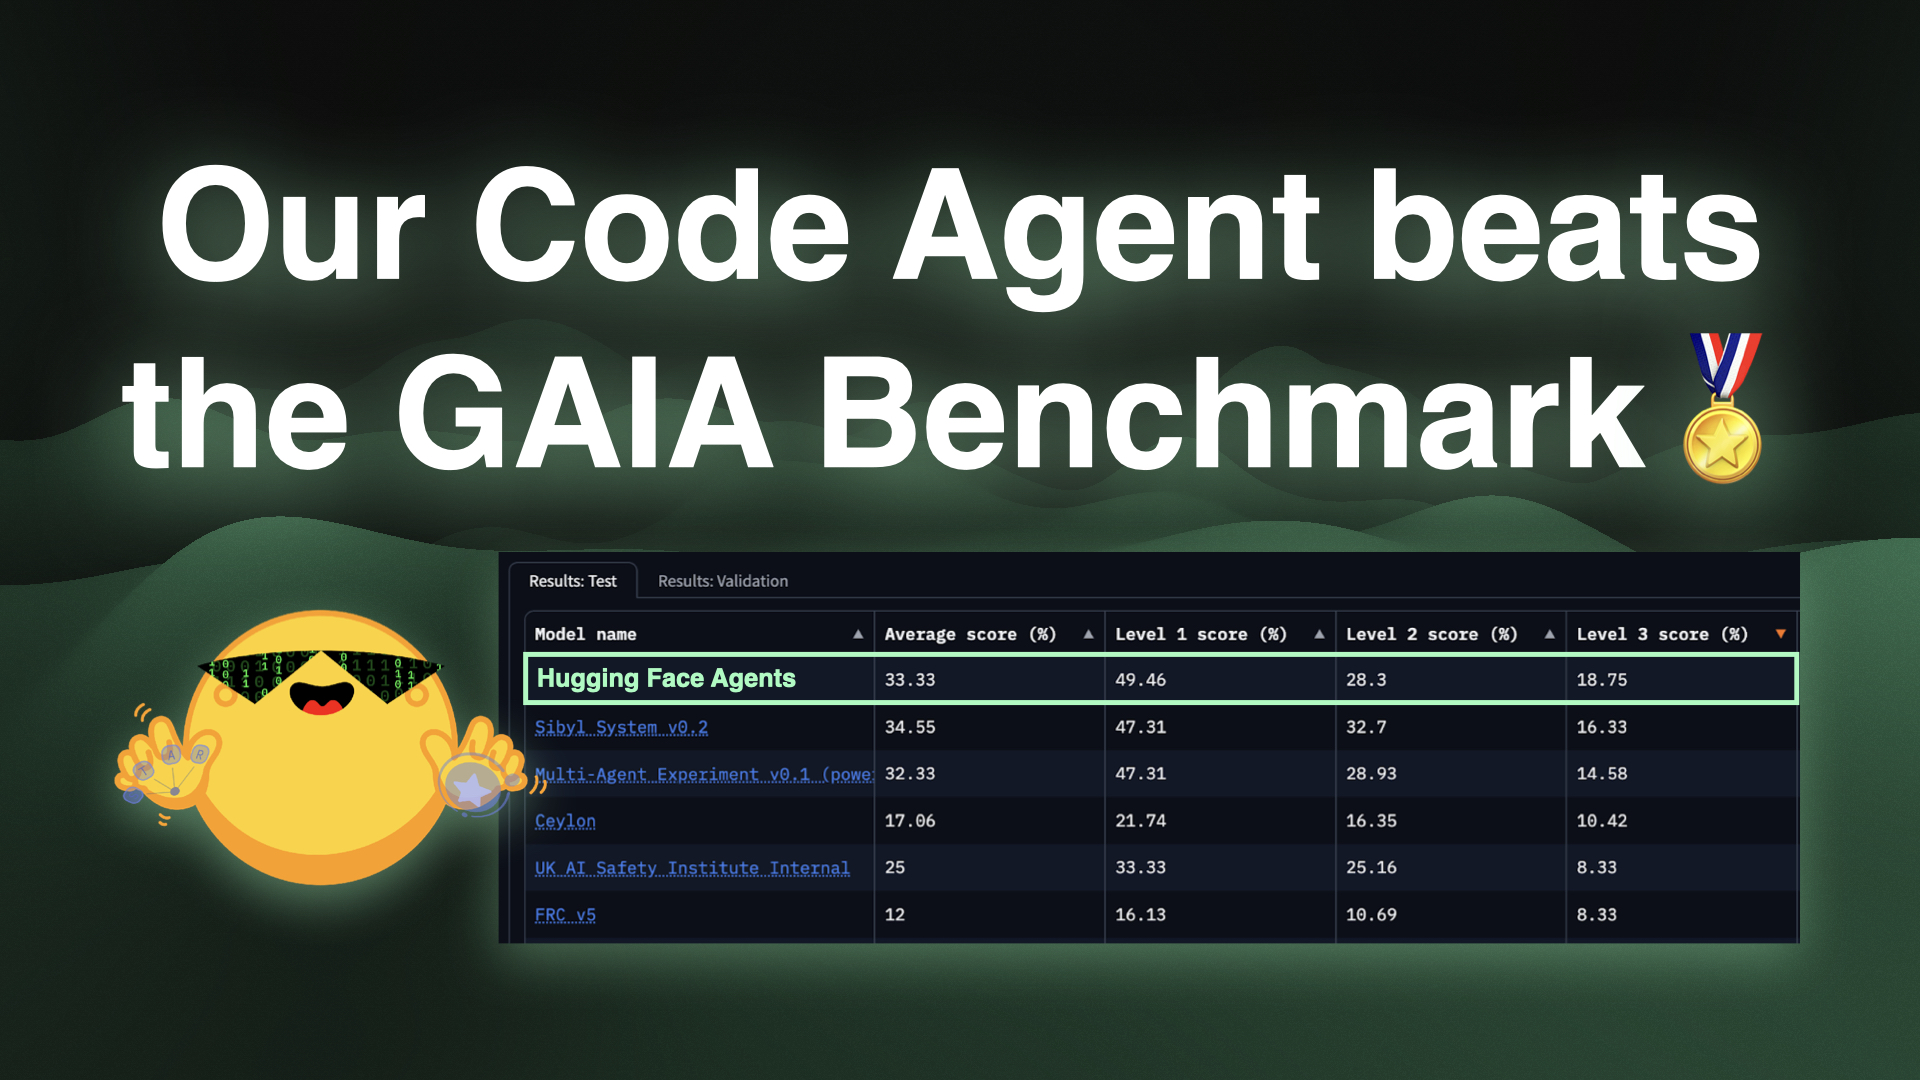
Transformers Agents-ის ტრიუმფი GAIA ბენჩმარკზე: აგენტური სისტემების ახალი ერა
ექსპერიმენტების სერიის შემდეგ, ჩვენზე დიდი შთაბეჭდილება მოახდინა Transformers Agents-ის შესაძლებლობებმა აგენტური სისტემების შექმნაში. GAIA ბენჩმარკზე, რომელიც ყველაზე რთულ და ყოვლისმომცველ აგენტურ ბენჩმარკად ითვლება, ბიბლიოთეკის გამოყენებით შექმნილმა Code Agent-მა მოწინავე პოზიციები დაიკავა. აღნიშნული ფრეიმვორკი, transformers.agents, ახლა განახლებულია და ფუნქციონირებს, როგორც დამოუკიდებელი ბიბლიოთეკა smolagents. სტატია განმარტავს აგენტების კონცეფციას, როგორც LLM-ზე დაფუძნებულ სისტემებს, რომლებსა