
Linux-ის ბირთვის დეველოპერები იდენტობის დადასტურების მოძველებულ PGP სისტემას ცვლიან
Linux-ის ბირთვის შემკეთებლები აქტიურად მუშაობენ PGP-ზე დაფუძნებული დეველოპერის იდენტობის დადასტურების მოძველებული მეთოდის ჩანაცვლებაზე, რომელიც ხასიათდება სირთულით, კონფიდენციალურობის რისკებითა და ხელით მართვის საჭიროებით. მათ წარმოადგინეს „Linux ID“ – დეცენტრალიზებული, კონფიდენციალურობის დამცავი იდენტობის ფენა, რომელიც იყენებს თანამედროვე ციფრული იდენტობის სტანდარტებს, რათა უფრო მოქნილად და უსაფრთხოდ მოხდეს დეველოპერებისა და მათი კოდის ავთენტურობის დადასტურება.
Linux-ის ბირთვის შემანარჩუნებლები PGP-ს ახალი დეცენტრალიზებული იდენტობის სისტემით, Linux ID-ით ანაცვლებენ
Linux-ის ბირთვის შემანარჩუნებლები ტრადიციულ Pretty Good Privacy (PGP) სისტემას, რომელსაც დეველოპერების იდენტიფიცირებისთვის იყენებდნენ, ახალი დეცენტრალიზებული იდენტობის ფენით, სახელწოდებით Linux ID, ანაცვლებენ. PGP-ის არსებული მეთოდი, რომელიც მოითხოვს პირისპირ შეხვედრებს და სახელმწიფო პირადობის მოწმობების ჩვენებას, "ტკივილიანი და რთული სამართავი" აღმოჩნდა, ასევე წარმოშობს კონფიდენციალურობისა და სოციალური ინჟინერიის რისკებს. Linux ID მიზნად ისახავს უზრუნველყოს მოქნილი და კონფიდენციალურობაზე ორიენტ

Google-მა გამოსახულების გენერირების პოპულარული მოდელის, Nano Banana 2-ის უახლესი ვერსია წარადგინა
Google-მა წარადგინა Nano Banana 2 (ტექნიკურად Gemini 3.1 Flash Image), გამოსახულების გენერირების გაუმჯობესებული მოდელი, რომელიც უფრო რეალისტურ და სწრაფ შედეგებს იძლევა. ის გახდება ნაგულისხმევი Gemini აპლიკაციაში, Google Search-ში (Google Lens-ისა და AI რეჟიმის მეშვეობით) და ვიდეო რედაქტირების ხელსაწყო Flow-ში. მოდელი ასევე ხელმისაწვდომია დეველოპერებისთვის და მოიცავს SynthID წყლის ნიშანს AI-გენერირებული გამოსახულებების აღსანიშნავად.

Snap-ის ჭკვიანი სათვალეები: ZDNET-ის პირველი შთაბეჭდილებები და ტექნოლოგიური პერსპექტივები
ZDNET-ის რეკომენდაციები ეფუძნება საათობით ტესტირებასა და კვლევას, რაც უზრუნველყოფს კონტენტის დამოუკიდებლობასა და სიზუსტეს. ამ სტატიაში განვიხილავთ Snap-ის უახლეს პროდუქტს – ჭკვიან სათვალეებს, „Spectacles“-ს. ავტორმა გამოსცადა დეველოპერებისთვის განკუთვნილი ვერსია და აღწერა მისი მოცულობითი დიზაინი, გამოყენების კომფორტის პრობლემები და სხვადასხვა „ლინზების“ (აპლიკაციების) ფუნქციონალი, როგორიცაა „Teleport“, „Spatial Tips“ და თარგმანის ფუნქცია, რომლებსაც გარკვეული ხარვეზები აღმოაჩნდათ. მიუხედავად იმის
MIT-ის კვლევა: ხელოვნური ინტელექტი მოწყვლად მომხმარებლებს უთანასწორო ინფორმაციას აწვდის
მასაჩუსეტსის ტექნოლოგიური ინსტიტუტის (MIT) ახალმა კვლევამ აჩვენა, რომ ხელოვნური ინტელექტის (AI) ჩეთბოტები ხშირად ნაკლებად ზუსტ ან სასარგებლო ინფორმაციას აწვდიან მოწყვლად მომხმარებლებს, მათ შორის არაინგლისურენოვან პირებსა და დაბალი განათლების მქონეებს. ეს პრობლემა, რომელიც ალგორითმული მიკერძოების ფართო დისკუსიის ნაწილია, საფრთხეს უქმნის ტექნოლოგიის მიერ უთანასწორობის აღმოფხვრის იდეას. მკვლევრები უკეთეს ტესტირებას, უფრო ინკლუზიურ მონაცემებსა და დეველოპერების მეტ ანგარიშვალდებულებას ითხოვენ, რათა A

NTT DATA-ს სიახლე: სინთეზური მონაცემები იაპონური AI-ის „მონაცემთა კედელს“ ანგრევს
იაპონელი AI დეველოპერები კულტურულად სპეციფიკური სასწავლო მონაცემების ქრონიკულ დეფიციტს აწყდებიან, რაც ინოვაციას აფერხებს. NTT DATA-ს ახალი კვლევა, NVIDIA Nemotron-Personas-Japan-ის გამოყენებით, აჩვენებს, თუ როგორ შეუძლია სინთეზურ მონაცემებს ამ გამოწვევის დაძლევა. ექსპერიმენტმა იურიდიული კითხვა-პასუხის ამოცანებში მოდელის სიზუსტე 15.3%-დან 79.3%-მდე გაზარდა კონფიდენციალურობის დარღვევის გარეშე. ეს მიდგომა კომპანიებს საშუალებას აძლევს, ააგონ დომენ-სპეციფიკური AI ღია კოდის ინფრასტრუქტურით, შეამცირონ
NTT DATA-ს კვლევა: როგორ ხსნის სინთეზური მონაცემები იაპონიის AI-ის მონაცემთა კედელს
იაპონიაში ხელოვნური ინტელექტის (AI) დეველოპერები ექმნებათ მონაცემთა ქრონიკულ დეფიციტს, განსაკუთრებით იაპონური კულტურისა და ენის სპეციფიკური ამოცანებისთვის. NTT DATA-ს ახალი კვლევა, NVIDIA Nemotron-Personas-Japan-ის გამოყენებით, აჩვენებს, რომ სინთეზურ მონაცემებს შეუძლიათ ამ გამოწვევის დაძლევა. ექსპერიმენტმა აჩვენა მოდელის სიზუსტის მნიშვნელოვანი ზრდა იურიდიული Q&A ამოცანებში (15.3%-დან 79.3%-მდე) კონფიდენციალურობის დარღვევის გარეშე. ეს მიდგომა შესაძლებელს ხდის მაღალი ხარისხის, კულტურულად სპეციფიკუ

ლონდონური სტარტაპი Mirai AI მოდელებს მოწყობილობებზე მუშაობისთვის აუმჯობესებს
Mirai, $10 მილიონიანი საწყისი დაფინანსებით, მუშაობს ხელოვნური ინტელექტის მოდელების ოპტიმიზაციაზე ტელეფონებსა და ლეპტოპებზე. კომპანია, რომლის დამფუძნებლებსაც წარსულში წარმატებული სამომხმარებლო აპლიკაციების შექმნის გამოცდილება აქვთ, მიზნად ისახავს ღრუბლოვანი სერვისებზე დამოკიდებულების შემცირებას და დეველოპერებისთვის მარტივი SDK-ის შეთავაზებას, რაც ხელს შეუწყობს AI-ის ეფექტურ ინტეგრაციას მოწყობილობებში, და ასევე გეგმავს Android-ის მხარდაჭერასა და მოწყობილობაშიდა ბენჩმარკების გამოშვებას.

AI კოდირების გავლენა ღია კოდის პროგრამულ უზრუნველყოფაზე: ხარისხის კრიზისი თუ პროდუქტიულობის ზრდა?
AI კოდირების ინსტრუმენტები, რომლებიც პროგრამული უზრუნველყოფის შექმნის გამარტივებასა და გაიაფებას ჰპირდებოდნენ, ღია კოდის პროექტებში არაერთგვაროვან შედეგებს იწვევს. მიუხედავად იმისა, რომ მათ შეუძლიათ ახალი მოდულების შექმნა გააადვილონ გამოცდილი დეველოპერებისთვის, ისინი ასევე ხელს უწყობენ დაბალი ხარისხის კოდის მოზღვავებას, რაც ართულებს პროექტების მართვას, ზრდის რევიუერების დატვირთვას და საფრთხეს უქმნის ეკოსისტემების ფრაგმენტაციას. ეს იწვევს დებატებს AI-ის გავლენის შესახებ პროგრამული უზრუნველყოფის ხ

Google-ის ხედვა AI-ზე Android დეველოპმენტში: პროდუქტიულობის ზრდა და დეველოპერების კონტროლი
Google აქტიურად აფართოებს ხელოვნური ინტელექტის (AI) შესაძლებლობებს Android დეველოპერებისთვის, Gemini გენერაციული AI-ის Android Studio-ში ინტეგრაციით. სტატიაში ხაზგასმულია Google-ის ინოვაციური მიდგომა, რომელიც დეველოპერებს საშუალებას აძლევს, აირჩიონ სასურველი დიდი ენობრივი მოდელი. Google Play-ის ვიცე-პრეზიდენტი, სემ ბრაითი, საუბრობს AI-ის როლზე რუტინული ამოცანების ავტომატიზაციაში, რათა დეველოპერებმა ფოკუსირება მოახდინონ პროექტის არსზე. მიუხედავად ამისა, ხაზგასმულია ადამიანის ჩართულობის მნიშვნელობ

Cohere-მ მრავალენოვანი ხელოვნური ინტელექტის მოდელები „Tiny Aya“ გამოუშვა, რომლებიც ოფლაინ რეჟიმში იმუშავებს
საწარმოო ხელოვნური ინტელექტის კომპანია Cohere-მ, ინდოეთის ხელოვნური ინტელექტის სამიტის ფარგლებში, მრავალენოვანი მოდელების ახალი ოჯახი, სახელწოდებით „Tiny Aya“ წარადგინა. ეს ღია წონის მოდელები 70-ზე მეტ ენას უჭერს მხარს, შეუძლიათ ყოველდღიურ მოწყობილობებზე ინტერნეტის გარეშე მუშაობა და განკუთვნილია მკვლევრებისა და დეველოპერებისთვის, რათა შექმნან აპლიკაციები მშობლიურ ენაზე მოსაუბრე აუდიტორიისთვის, განსაკუთრებით ინდოეთის მსგავს მრავალენოვან რეგიონებში.
Hugging Face და FriendliAI AI მოდელების განთავსების გასაუმჯობესებლად პარტნიორობენ
Hugging Face და FriendliAI აცხადებენ სტრატეგიული პარტნიორობის შესახებ, რომელიც მიზნად ისახავს დეველოპერებისთვის AI მოდელების განთავსებისა და მართვის პროცესის გამარტივებას. ინტეგრაცია FriendliAI Endpoints-ს Hugging Face Hub-ში აერთიანებს, რაც უზრუნველყოფს მაღალეფექტურ, ეკონომიურ ინფერენციის ინფრასტრუქტურას. ეს ნაბიჯი AI ინოვაციებს უფრო ხელმისაწვდომსა და ეფექტურს გახდის მსოფლიოს მასშტაბით, ოპტიმიზებული GPU გამოყენებით და ინფრასტრუქტურის მართვის სირთულეების შემცირებით.
LLM-ების ინტეგრაცია Swift აპლიკაციებში Core ML-ის გამოყენებით: დეველოპერების სახელმძღვანელო
მანქანური სწავლება (ML) პროგრამული უზრუნველყოფის შექმნის ახალ გზებს ხსნის, განსაკუთრებით Swift დეველოპერებისთვის, რომლებსაც სურთ ხელოვნური ინტელექტის ფუნქციების ინტეგრირება თავიანთ აპლიკაციებში. ეს სტატია წარმოგიდგენთ Core ML-ზე დაფუძნებულ ინსტრუმენტებსა და დეტალურ სახელმძღვანელოს, თუ როგორ უნდა გაუშვათ დიდი ენობრივი მოდელები (LLM), როგორიცაა Llama 2, Mac-ზე. პროექტი მოუწოდებს დეველოპერებს, შეერთდნენ და წვლილი შეიტანონ ამ ინიციატივის ერთობლივ გაუმჯობესებაში, რათა დააჩქარონ ხელოვნური ინტელექტის შ
Hugging Face-ის Xet გუნდის ინოვაციური მიდგომა მონაცემთა გადაცემის დაჩქარებისთვის
Hugging Face-ის Xet გუნდი მონაცემთა დედუპლიკაციას თეორიიდან პრაქტიკაში ნერგავს, რათა მნიშვნელოვნად დააჩქაროს AI დეველოპერებისთვის Hub-ზე მონაცემების ატვირთვა და ჩამოტვირთვა. იმის ნაცვლად, რომ მხოლოდ დედუპლიკაციის მაქსიმიზაციაზე გაამახვილონ ყურადღება, რამაც შეიძლება დიდი დამატებითი ხარჯები გამოიწვიოს, მათი მიდგომა მიზნად ისახავს სწრაფი ექსპერიმენტებისა და თანამშრომლობის ხელშეწყობას. ეს გულისხმობს მონაცემთა გადაადგილების, შენახვისა და განვითარების მთლიანი პროცესის ოპტიმიზაციას ჩანკებზე დაფუძნებული
Hugging Face-ის გაფართოებული ეკოსისტემა: ახალი პარტნიორები და AI მოდელები ინფერენსისთვის
Hugging Face წარმოგიდგენთ ახალ პარტნიორებსა და ინფერენსის მოდელებს, მათ შორის DeepSeek-R1-სა და Flux.1-ს, რითაც მნიშვნელოვნად აფართოებს ხელმისაწვდომ შესაძლებლობებს AI დეველოპერებისთვის. გაუმჯობესებული ბილინგის სტრუქტურა და PRO მომხმარებლებისთვის განკუთვნილი ყოველთვიური კრედიტები პლატფორმას კიდევ უფრო მიმზიდველს ხდის. სტატიაში მოცემულია მაგალითები და დეტალები მომხმარებლის გამოცდილების შესახებ.

Google-მა PaliGemma 2 Mix გამოუშვა: ახალი ვიზუალური ენის მოდელები გაუმჯობესებული შესაძლებლობებით
Google-მა წარადგინა PaliGemma 2 Mix, წინასწარ გაწვრთნილი PaliGemma 2 ვიზუალური ენის მოდელების (VLMs) ახალი ოჯახი, რომელიც დაზუსტებულია სხვადასხვა ვიზუალური ენის ამოცანებისთვის, მათ შორის OCR-ისთვის, მოკლე და გრძელი აღწერისთვის, ობიექტის ამოცნობისა და გამოსახულების სეგმენტაციისთვის. ეს მოდელები, რომლებიც Gemma 2-სა და SigLIP-ზეა დაფუძნებული, შექმნილია შემდგომ ამოცანებზე უკეთესი სწავლისთვის და ხელმისაწვდომია სხვადასხვა ზომისა და რეზოლუციის ვარიანტებში, რაც აჩქარებს დეველოპერებისთვის პროტოტიპების შ

Hugging Face-ის Xet გუნდი: დიდი ნაბიჯი AI მოდელებისა და მონაცემთა საცავების მიგრაციაში
Hugging Face-ის Xet გუნდმა წარმატებით განახორციელა მოდელებისა და მონაცემთა ნაკრებების პირველი საცავების მიგრაცია LFS-დან Xet საცავში. ეს ნაბიჯი, რომელიც Hugging Face-ის Hub-ის ხედვის ნაწილია, მიზნად ისახავს ხელოვნური ინტელექტის დეველოპერებისთვის მასიურ მოდელებსა და მონაცემთა ნაკრებებზე მუშაობის გამარტივებას, უფრო ეფექტურ თანამშრომლობასა და განმეორებითი იტერაციების განხორციელებას. მიგრაციამ Hub-ის ჩამოტვირთვის ტრაფიკის დაახლოებით 6% Xet ინფრასტრუქტურაზე გადაიტანა, რაც ამტკიცებს ახალი სისტემის ეფე
Hugging Face: კონფიდენციალური მონაცემების ცენტრალიზებული მართვა Infisical-ით
Hugging Face-ის ინფრასტრუქტურის მრავალღრუბლოვან გარემოში განვითარებასთან ერთად, საინჟინრო გუნდმა მოითხოვა კონფიდენციალური მონაცემების მართვის უფრო მოქნილი, უსაფრთხო და ცენტრალიზებული მეთოდი. HashiCorp Vault-ის მსგავსი გადაწყვეტილებების შეფასების შემდეგ, მათ აირჩიეს Infisical მისი დეველოპერებისთვის მოსახერხებელი სამუშაო პროცესების, მრავალღრუბლოვანი აბსტრაქციისა და უსაფრთხოების მძლავრი შესაძლებლობების გამო. ამ მიგრაციამ მნიშვნელოვნად გააუმჯობესა უსაფრთხოების პოზიცია Kubernetes Operator-თან, CI/CD

NVIDIA Isaac GR00T N1.5: ინტელექტუალური რობოტების შექმნის ახალი ეტაპი
NVIDIA-მ გამოაცხადა Isaac GR00T N1.5-ის გამოშვება, რომელიც წარმოადგენს მსოფლიოში პირველი ღია ფუნდამენტური მოდელის, Isaac GR00T N1-ის, უმნიშვნელოვანეს განახლებას განზოგადებული ჰუმანოიდური რობოტების მსჯელობისა და უნარებისთვის. ეს პლატფორმა შექმნილია ინტელექტუალური, ადაპტირებადი რობოტების შექმნის დასაჩქარებლად, მრავალმხრივი შეყვანის (ენა, გამოსახულებები) დამუშავებით და მრავალფეროვან გარემოში მანიპულაციური ამოცანების შესასრულებლად. GR00T N1.5 ახლა ხელმისაწვდომია დეველოპერებისთვის, რაც მათ საშუალებას
Graphcore და Hugging Face 10 ტრანსფორმერული მოდელის ხელმისაწვდომობას აფართოებენ AI ამოცანებისთვის
სტატია დეტალურად აღწერს, თუ როგორ გააფართოვეს Graphcore-მა და Hugging Face-მა, მათი პარტნიორობის მეშვეობით, 10 ტრანსფორმერულ მოდელზე წვდომა დეველოპერებისთვის, რომლებიც მოიცავს ბუნებრივი ენის დამუშავებას (NLP), მეტყველებასა და კომპიუტერულ ხედვას. ხაზგასმულია ძირითადი მოდელები, როგორიცაა BERT, ViT, GPT-2, RoBERTa, DeBERTa, BART, LXMERT, T5, HuBERT და Wav2Vec2, მათი უნიკალური ფუნქციონალური შესაძლებლობებისა და გამოყენების სფეროების ახსნით, რაც ამარტივებს ხელოვნური ინტელექტის განვითარებას IPU-ებზე.

Gemma 3n: მულტიმოდალური AI მოდელი საბოლოოდ ღია კოდის ბიბლიოთეკებში
Google-ის უახლესი მულტიმოდალური AI მოდელი, Gemma 3n, საბოლოოდ ხელმისაწვდომია ყველაზე პოპულარულ ღია კოდის ბიბლიოთეკებში, მათ შორის transformers & timm, MLX, llama.cpp და სხვებში. ეს გამოშვება მოიცავს ორ ზომას (E2B და E4B), რომლებიც გამოირჩევიან მაღალი ეფექტურობით VRAM-ის გამოყენების მხრივ და უზრუნველყოფენ შესანიშნავ ხარისხს. Gemma 3n არა მხოლოდ ენობრივ დეკოდერს, არამედ აუდიო და ვიზუალურ ენკოდერებსაც მოიცავს, რაც მას სრულყოფილ მულტიმოდალურ ინსტრუმენტად აქცევს დეველოპერებისთვის. სტატია დეტალურად აღ

SmolLM3: ოპტიმალური ეფექტურობის 3B მოდელი სრული საინჟინრო პროექტით
SmolLM3-ის 3 მილიარდი პარამეტრის მოდელი აღემატება Llama-3.2-3B და Qwen2.5-3B მოდელებს, ამავდროულად ინარჩუნებს კონკურენტუნარიანობას უფრო დიდ 4B ალტერნატივებთან (Qwen3 და Gemma3). მისი უნიკალურობა მდგომარეობს იმაში, რომ დეველოპერები სრულად აქვეყნებენ მოდელის შექმნის მეთოდოლოგიას – არქიტექტურის დეტალებს, მონაცემთა შერევის მეთოდებსა და სამეტაპიან წინასწარ ვარჯიშის მიდგომას, რაც ჩვეულებრივ თვეების უკუინჟინერიას მოითხოვდა. არქიტექტურული ინოვაციები მოიცავს Grouped Query Attention (GQA), NoPE პოზიციური

Hugging Face-ისა და AMD-ის გარღვევა AI მოდელების ოპტიმიზაციაში MI300X-ზე
Hugging Face-მა და AMD-მ ითანამშრომლეს, რათა მნიშვნელოვნად გაეუმჯობესებინათ ხელოვნური ინტელექტის მოდელების, კერძოდ Llama 3.1 405B-ის ინფერენსის შესრულება AMD MI300X GPU-ებზე. პროექტი ფოკუსირებულია დაბალი დონის კერნელების ოპტიმიზაციაზე, რაც გადამწყვეტია მილიარდობით პარამეტრის მქონე მოდელებისთვის. ამ თანამშრომლობის შედეგად შეიქმნა ღია კოდის მორგებული კერნელები, რომლებმაც მნიშვნელოვანი სიჩქარის ზრდა აჩვენეს, განსაკუთრებით AMD-ის აპარატურისთვის, რომელიც ხშირად იგნორირებულია კერნელის დეველოპერების მი
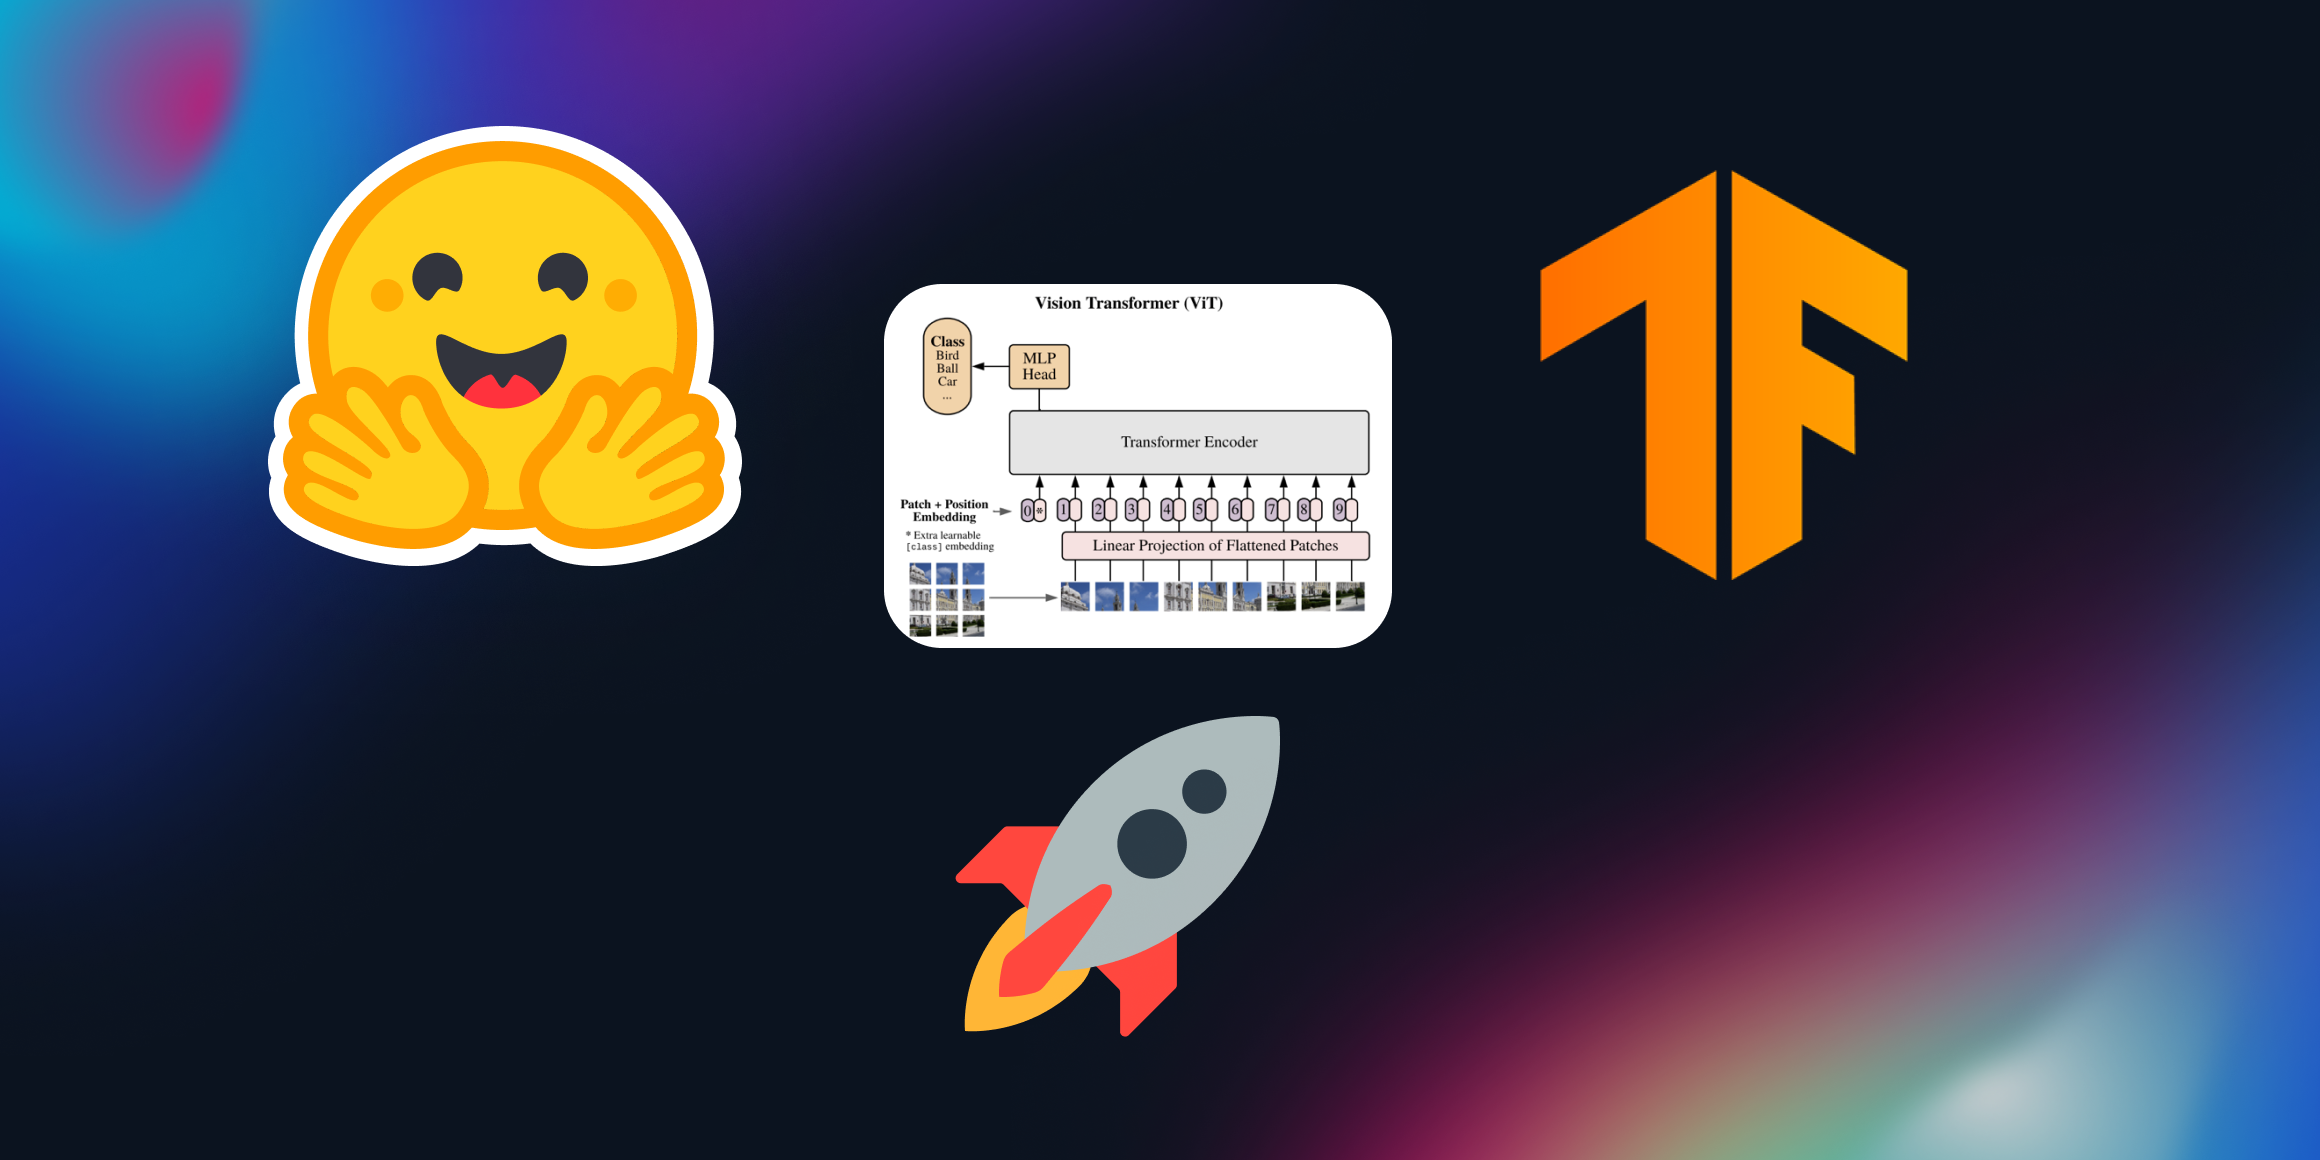
Vision Transformer მოდელის ლოკალურად განთავსება TensorFlow Serving-ის გამოყენებით
ეს პოსტი დეტალურად აღწერს, თუ როგორ უნდა მოხდეს Vision Transformer (ViT) მოდელის (გამოსახულების კლასიფიკაციისთვის) ლოკალურად განთავსება TensorFlow Serving-ის (TF Serving) მეშვეობით. ის განმარტავს მოდელის შენახვას SavedModel ფორმატში, წინასწარი და შემდგომი დამუშავების ნაბიჯების ინტეგრირებას გამოთვლით გრაფში და საბოლოოდ, მოდელის გაშვებას REST ან gRPC ენდპოინტებად TF Serving-ის გამოყენებით, რითაც შემცირდება დეველოპერების კოგნიტური დატვირთვა და გაუმჯობესდება სისტემის ეფექტურობა.