
NVIDIA-მ იაპონური ენის მოდელი Nemotron-Nano-9B-v2-Japanese წარადგინა, Nejumi Leaderboard 4-ზე უახლესი მიღწევით
NVIDIA-მ გამოუშვა Nemotron-Nano-9B-v2-Japanese, მსუბუქი და ეფექტური მოდელი 10 მილიარდზე ნაკლები პარამეტრით, რომელიც იაპონური ენის ღრმა გაგებასა და ძლიერ აგენტურ შესაძლებლობებს გვთავაზობს. მან Nejumi Leaderboard 4-ზე 10B-ზე ნაკლები პარამეტრის მქონე მოდელებს შორის უახლეს მიღწევას მიაღწია, რაც იაპონური კორპორატიული ხელოვნური ინტელექტის განვითარებაში მნიშვნელოვანი ეტაპია. მოდელი ეფუძნება Nemotron-Nano-9B-v2-ის არქიტექტურასა და Nemotron-Personas-Japan-ის მაღალი ხარისხის სინთეზურ მონაცემებს.
Habana Gaudi2-ის რეკორდული სისწრაფე BridgeTower-ის დახვეწისას: A100-ზე 2.5-ჯერ, H100-ზე 1.4-ჯერ სწრაფი
უახლესი კვლევის მიხედვით, Habana Gaudi2-ზე Optimum Habana v1.7-ის გამოყენებით, შესაძლებელია BridgeTower ხედვა-ენის მოდელის დახვეწის პროცესის მნიშვნელოვნად დაჩქარება. ეს მიღწევა, რომელიც A100-თან შედარებით 2.5-ჯერ, ხოლო H100-თან შედარებით 1.4-ჯერ ზრდის სისწრაფეს, ეფუძნება აპარატურულად აჩქარებულ მონაცემთა ჩატვირთვას. ეს ტექნიკები ნებისმიერ სხვა სამუშაო დატვირთვასაც ესადაგება, სადაც მონაცემთა ჩატვირთვა წარმოადგენს შეფერხებას, რაც ხედვის მოდელებისთვის ხშირია.

SmolVLM-256M და SmolVLM-500M: მსოფლიოს ყველაზე პატარა ხედვის ენის მოდელები
კომპანიამ SmolVLM ოჯახის ორი ახალი წევრი, SmolVLM-256M და SmolVLM-500M, წარადგინა. 256 მილიონი პარამეტრის მქონე მოდელი მსოფლიოში ყველაზე პატარა ხედვის ენის მოდელია. ახალი მოდელები ეფუძნება SmolVLM 2B-დან მიღებულ გამოცდილებას, აქცენტი კეთდება ეფექტურობაზე, მონაცემთა ნარევებზე და დიზაინის ახალ კომპრომისებზე. ისინი ინარჩუნებენ მძლავრ მულტიმოდალურ მუშაობას გაცილებით მცირე ზომებში და მარტივად ინტეგრირდება არსებულ სისტემებში. ეს მოდელები განკუთვნილია როგორც შეზღუდული მოწყობილობებისთვის, ასევე დიდი მოც
DeDLOC: რევოლუციური მეთოდი ხელოვნური ინტელექტის კოლაბორაციული წვრთნისთვის
წარმოგიდგენთ DeDLOC-ს — ახალ მეთოდს კოლაბორაციული განაწილებული სწავლებისთვის, რომელსაც შეუძლია მოერგოს მონაწილეთა ქსელურ და აპარატურულ შეზღუდვებს. ჩვენ ვაჩვენებთ, რომ ის წარმატებით გამოიყენება რეალურ სცენარებში: 40 მოხალისის დახმარებით წინასწარ გაიწრთვნა sahajBERT, ბენგალური ენის მოდელი, რომელმაც მიაღწია თითქმის უახლეს ხარისხს, გაცილებით დიდ მოდელებთან შედარებით, რომლებიც ასობით მაღალი კლასის ამაჩქარებელს იყენებენ. ეს მეთოდი გვთავაზობს გამოსავალს ხელოვნური ინტელექტის მოდელების წვრთნის მაღალი ღირ
BERT: ხელოვნური ინტელექტის ინოვაცია, რომელმაც ენის დამუშავება შეცვალა
BERT, Google AI-ის მიერ 2018 წელს შექმნილი მანქანური სწავლების მოდელი, რევოლუციური ინოვაციაა ბუნებრივი ენის დამუშავების (NLP) სფეროში. იგი წარმოადგენს მრავალფუნქციურ გადაწყვეტას 11-ზე მეტი ენობრივი ამოცანისთვის, მათ შორის სენტიმენტების ანალიზისა და დასახელებული ერთეულების ამოცნობისთვის. სტატია განმარტავს, თუ როგორ ეხმარება BERT კომპიუტერებს ადამიანის ენის გაგებაში, რა ტექნიკებს (როგორიცაა ნიღბიანი ენის მოდელი და შემდეგი წინადადების პროგნოზირება) იყენებს ამისთვის და რა გავლენა მოახდინა მან Google

Falcon-Arabic: ტექნოლოგიური ინსტიტუტის ახალი ენის მოდელი არაბული ხელოვნური ინტელექტის საზღვრებს ცვლის
არაბთა გაერთიანებული საამიროების ტექნოლოგიური ინოვაციების ინსტიტუტმა (TII) წარმოადგინა Falcon-Arabic, 7 მილიარდი პარამეტრის მრავალენოვანი ენის მოდელი, რომელიც ახალ სტანდარტებს ადგენს არაბული ბუნებრივი ენის დამუშავებისთვის (NLP). Falcon 3 არქიტექტურაზე აგებული, Falcon-Arabic მნიშვნელოვნად აღემატება არსებულ არაბულ LLM-ებს ეფექტურობითა და შესაძლებლობებით, რაც ხელს უწყობს არაბულენოვანი საზოგადოებების სრულ ინტეგრაციას ხელოვნური ინტელექტის რევოლუციაში და უზრუნველყოფს უფრო ბუნებრივ, ინტელექტუალურ და ინ

NVIDIA-ს Llama Nemotron Nano VL: რევოლუცია ინტელექტუალური დოკუმენტების დამუშავებაში
NVIDIA-მ წარმოადგინა Llama Nemotron Nano VL, 8 მილიარდპარამეტრიანი ხედვითი ენის მოდელი (VLM), რომელიც განკუთვნილია ინტელექტუალური დოკუმენტების დამუშავებისთვის (IDP). მოდელი გამოირჩევა მაღალი სიზუსტით და მულტიმოდალური გაგებით, რაც საშუალებას აძლევს მას ეფექტურად მოიპოვოს და გაიგოს ინფორმაცია კომპლექსური დოკუმენტებიდან, როგორიცაა ინვოისები, ქვითრები, კონტრაქტები, PDF ფაილები, სურათები და დიაგრამები. Llama Nemotron Nano VL აჩვენებს ინდუსტრიაში წამყვან შედეგებს OCRBench v2 ბენჩმარკზე, რაც უზრუნველყო

ეტინი: უახლესი ენკოდერ-დეკოდერ მოდელები, რომლებიც Llama 3.2 1B-ს და SmolLM2-ს აღემატებიან
რა მოხდებოდა, ModernBERT-ის რეცეპტი მხოლოდ დეკოდერის მოდელზე რომ გამოგვეყენებინა? აღმოჩნდა, რომ შეიქმნებოდა უახლესი დეკოდერული ენის მოდელი, რომელიც Llama 3.2 1B-სა და SmolLM2-ს ჯობნის. ჩვენ წარმოგიდგენთ Ettin-ს, უახლესი, დაწყვილებული მხოლოდ-ენკოდერისა და მხოლოდ-დეკოდერის მოდელების პირველ სერიას (17M-1B პარამეტრი), რომლებიც გაწვრთნილია იდენტური მონაცემებით (2T ტოკენი), არქიტექტურითა და წვრთნის რეცეპტებით. Ettin შესაძლებელს ხდის არქიტექტურებს შორის სამართლიან შედარებებს და უზრუნველყოფს უმაღლეს შეს
კონტრასტული ძიება: ინოვაციური მიდგომა ბუნებრივი და თანმიმდევრული ტექსტის გენერაციაში
ტექსტის გენერაციის არსებული მეთოდები ხშირად აწყდებიან პრობლემებს, როგორიცაა გამეორებები და სემანტიკური შეუსაბამობა. კონტრასტული ძიება (Contrastive Search) წარმოადგენს ახალ დეკოდირების მეთოდს, რომელიც აბალანსებს ენის მოდელის ნდობასა და კონტექსტთან მსგავსებას, რათა შექმნას მაღალი ხარისხის, გრამატიკულად გამართული და სემანტიკურად თანმიმდევრული ტექსტი.
ProtST-ის განლაგება და დამატებითი წვრთნა Intel Gaudi 2 აქსელერატორებზე: უმაღლესი სიჩქარე ცილის მოდელირებისთვის
ცილოვანი ენის მოდელები (PLM-ები), კერძოდ ProtST, ცილის სტრუქტურისა და ფუნქციის პროგნოზირების მძლავრი საშუალებაა. Intel-მა და MILA-მ ProtST, მულტიმოდალური ენის მოდელი, ICML 2023-ზე წარადგინეს, რომელმაც სწრაფად მოიპოვა აღიარება. ამ სტატიაში განხილულია, თუ როგორ ხდება ProtST-ის ეფექტური ინფერენსი და დამატებითი წვრთნა Intel Gaudi 2 აქსელერატორებზე. შედეგები აჩვენებს 1.76-ჯერ დაჩქარებას ინფერენსისთვის და 2.92-ჯერ დაჩქარებას დამატებითი წვრთნისთვის NVIDIA A100-თან შედარებით, გაუმჯობესებული ხელმისაწვდომ
MIT-ის ახალი მიდგომა: მცირე ენის მოდელები ერთობლივი მუშაობით დიდებს ჯობნიან
მიუხედავად იმისა, რომ ენის მოდელები (LMs) უმჯობესდებიან სხვადასხვა ამოცანებში, მათ მაინც უჭირთ რთული და მკაცრი წესების მქონე მოთხოვნების შესრულება. ამ პრობლემის გადასაჭრელად, MIT-ის მკვლევრებმა შეიმუშავეს „DisCIPL“ – თანამშრომლობითი მიდგომა, სადაც დიდი ენის მოდელი (LLM) გეგმავს ამოცანას, შემდეგ კი მის შესრულებას მცირე მოდელებს ანაწილებს. ეს მეთოდი მცირე ენის მოდელებს საშუალებას აძლევს, მიაწოდონ უფრო ზუსტი და ეფექტური პასუხები, ვიდრე წამყვან LLM-ებს, როგორიცაა GPT-4o, და მიუახლოვდნენ მაღალი დონის
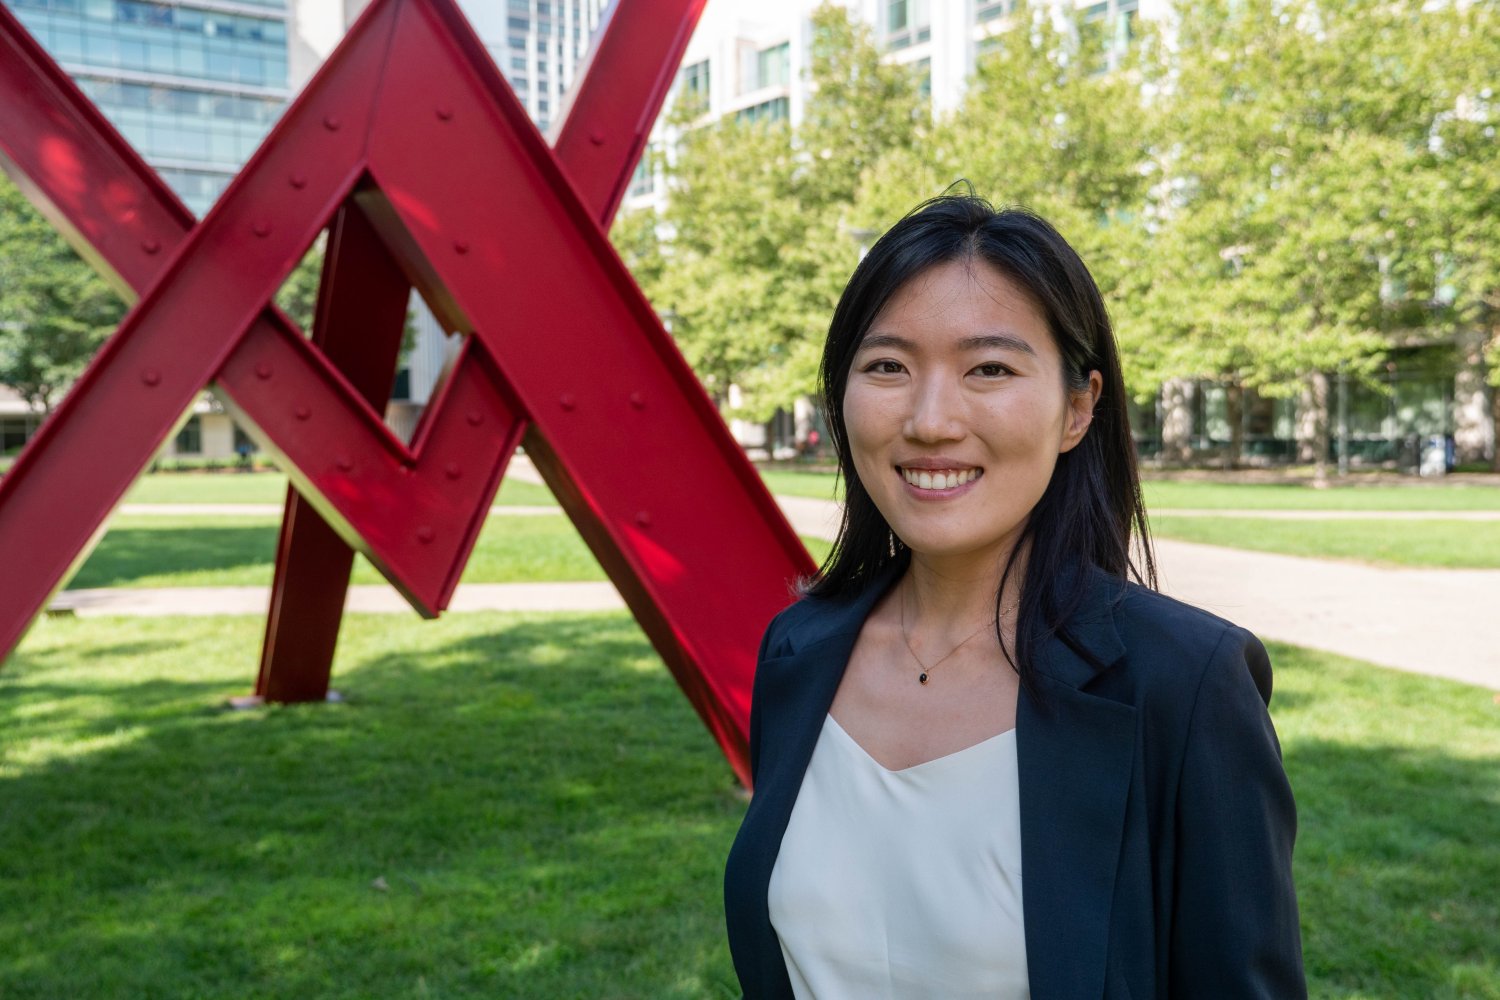
MIT-ის ახალი პროფესორი იუნჰა ჰვანგი: გამოთვლითი მიდგომები მიკრობული სიცოცხლის საიდუმლოებების ამოსახსნელად
დედამიწაზე არსებული სიცოცხლის უდიდესი ნაწილი მიკრობულია, თუმცა მათი მრავალფეროვნების მცირე ნაწილია მხოლოდ შესწავლილი. MIT-ის ახალი პროფესორი იუნჰა ჰვანგი, ბიოლოგიისა და კომპიუტერული მეცნიერების მიმართულებების კვეთაზე მუშაობს, რათა გამოიყენოს გენომური ენის მოდელირება – ხელოვნური ინტელექტის ფორმა, რომელიც დნმ-ის „ენას“ სწავლობს – ექსტრემალურ გარემოში მცხოვრები მიკრობების ფუნქციებისა და ევოლუციური კავშირების გასაგებად, რომელთა კულტივირება ლაბორატორიულ პირობებში შეუძლებელია.
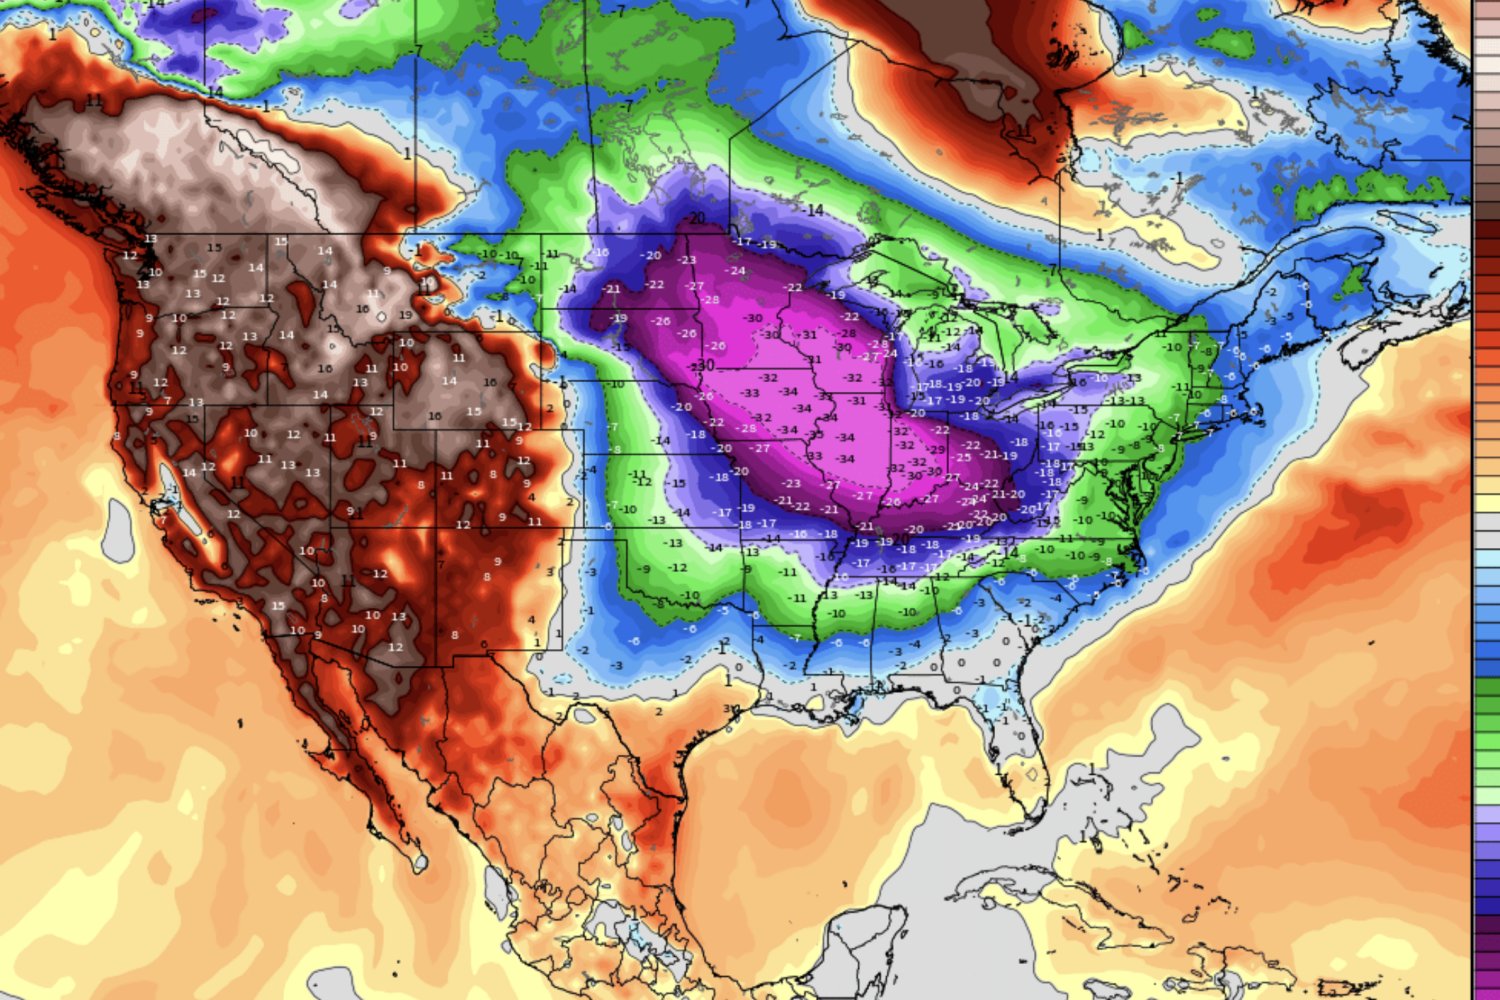
არქტიკის ინდიკატორები და ხელოვნური ინტელექტი ზამთრის ამინდის პროგნოზირებისთვის
სტატია ეხება ჯუდა კოენის კვლევას არქტიკული პირობების (ციმბირის თოვლის საფარი, პოლარული მორევა და სხვ.) გამოყენების შესახებ, როგორც ზამთრის ამინდის პროგნოზირების ძირითად ინდიკატორებს ევროპაში, აზიაში და ჩრდილოეთ ამერიკაში. აღწერილია, თუ როგორ ხდება ხელოვნური ინტელექტის ინტეგრირება, რამაც მნიშვნელოვანი წინსვლა აჩვენა სუბსეზონურ პროგნოზირებაში (2-6 კვირა) და შესაძლოა გაზარდოს ექსტრემალური ამინდის მოვლენების პროგნოზირების დრო. კოენის მოდელი მიანიშნებს ევრაზიისა და ცენტრალური ჩრდილოეთ ამერიკის ნაწილე