სოციალური მედიის სტატისტიკა: ტენდენციები, ფაქტები და პროგნოზები 2025 წლისთვის
ბოლო ათწლეულში სოციალურმა მედიამ რევოლუცია მოახდინა კომუნიკაციაში, ვაჭრობაში და ზოგადად ცხოვრებაში, ხელოვნური ინტელექტი კი მოხმარებასა და წარმოებაზე ახდენს გავლენას. ეს სტატია განხილავს 2015-2025 წლების სტატისტიკას, რომელიც გვიჩვენებს სოციალური მედიის მომხმარებელთა გლობალურ ზრდას 2.078 მილიარდიდან (2015) სავარაუდო 5.239 მილიარდამდე (2025), რაც 9.7%-იან წლიურ კუმულაციურ ზრდას (CAGR) ნიშნავს. მიუხედავად იმისა, რომ ზრდა COVID-19 პანდემიის დროს დაჩქარდა, ახლა ის ერთნიშნა მაჩვენებელზეა. 2025 წლისთვის
LLM-ების კონფიდენციალურობისა და ინტელექტუალური საკუთრების დაცვა: Zama-ს გადაწყვეტა ჰომომორფული დაშიფვრით
დიდი ენობრივი მოდელების (LLM) ფართო გამოყენების მიუხედავად, მომხმარებლის მონაცემთა კონფიდენციალურობის საკითხი კვლავ გადაუჭრელ პრობლემად რჩება, რადგან არსებობს სენსიტიური ინფორმაციის LLM სერვისის მიმწოდებელთან გაჟონვის რისკი. Zama გვთავაზობს ინოვაციურ გადაწყვეტას სრულად ჰომომორფული დაშიფვრის (FHE) გამოყენებით, რომელიც საშუალებას აძლევს LLM-ებს, იმუშაონ დაშიფრულ მონაცემებზე. ეს მეთოდი იცავს როგორც მომხმარებლის კონფიდენციალურობას, ასევე მოდელის ინტელექტუალურ საკუთრებას, პროგნოზების ხარისხის შენარჩუ

„Few-Shot“ სწავლება: GPT-Neo, ბუნებრივი ენის დამუშავება და ეთიკური გამოწვევები
„Few-Shot“ სწავლება მანქანური სწავლების მოდელებს საშუალებას აძლევს, პროგნოზები გააკეთონ ძალიან მცირე რაოდენობის სავარჯიშო მონაცემების გამოყენებით, ტრადიციული „fine-tuning“ მეთოდებისგან განსხვავებით. ის, ძირითადად, კომპიუტერულ მხედველობაში გამოიყენებოდა, თუმცა ახლა უკვე ეფექტურია ბუნებრივი ენის დამუშავებაში (ბედ) დიდ ენობრივ მოდელებთან (მაგ. GPT-Neo), რაც მათ საშუალებას აძლევს, განაზოგადონ ახალი ამოცანები სულ რამდენიმე მაგალითით. თუმცა, ეფექტური „few-shot“ მაგალითების შექმნა და ჰიპერპარამეტრების
Renumics Spotlight: ინტერაქტიული ვიზუალიზაცია და მონაცემთა ინსპექცია Hugging Face-ის მონაცემთა ნაკრებებისთვის
Renumics Spotlight გთავაზობთ ინტერაქტიულ ვიზუალიზაციებს Hugging Face-ის მონაცემთა ნაკრებებში კრიტიკული კლასტერების იდენტიფიცირებისთვის. ის იყენებს მოდელის შედეგებს (პროგნოზები, ემბედინგები) მონაცემთა სეგმენტებისა და მოდელის შეცდომების ღრმა გაგებისთვის, რაც აადვილებს მონაცემთა ინსპექციას და ხდის მას მასშტაბირებადს. ხელსაწყო პირდაპირ ინტეგრირდება `datasets` ბიბლიოთეკასთან და მხარს უჭერს სხვადასხვა ტიპის მონაცემებსა და ML ამოცანებს, მათ შორის NLP, აუდიო და კომპიუტერული ხედვა.
Renumics Spotlight: გაამარტივეთ მონაცემთა ინსპექტირება Hugging Face ეკოსისტემაში
Renumics Spotlight გთავაზობთ ინტერაქტიულ ვიზუალიზაციებს, რომლებიც ეხმარება მომხმარებლებს კრიტიკული კლასტერების იდენტიფიცირებაში Hugging Face მონაცემთა ნაკრებებში. ინსტრუმენტი უპრობლემოდ ინტეგრირდება Hugging Face-ის ეკოსისტემასთან, საშუალებას გაძლევთ გამოიყენოთ მოდელის შედეგები, როგორიცაა პროგნოზები და ემბედინგები, რათა ღრმად შეისწავლოთ მონაცემთა სეგმენტები და მოდელის ხარვეზები. Spotlight მნიშვნელოვნად ზრდის მონაცემთა ინსპექტირების მასშტაბურობას, ამარტივებს სამუშაო პროცესებს და ამცირებს დროის ხარ
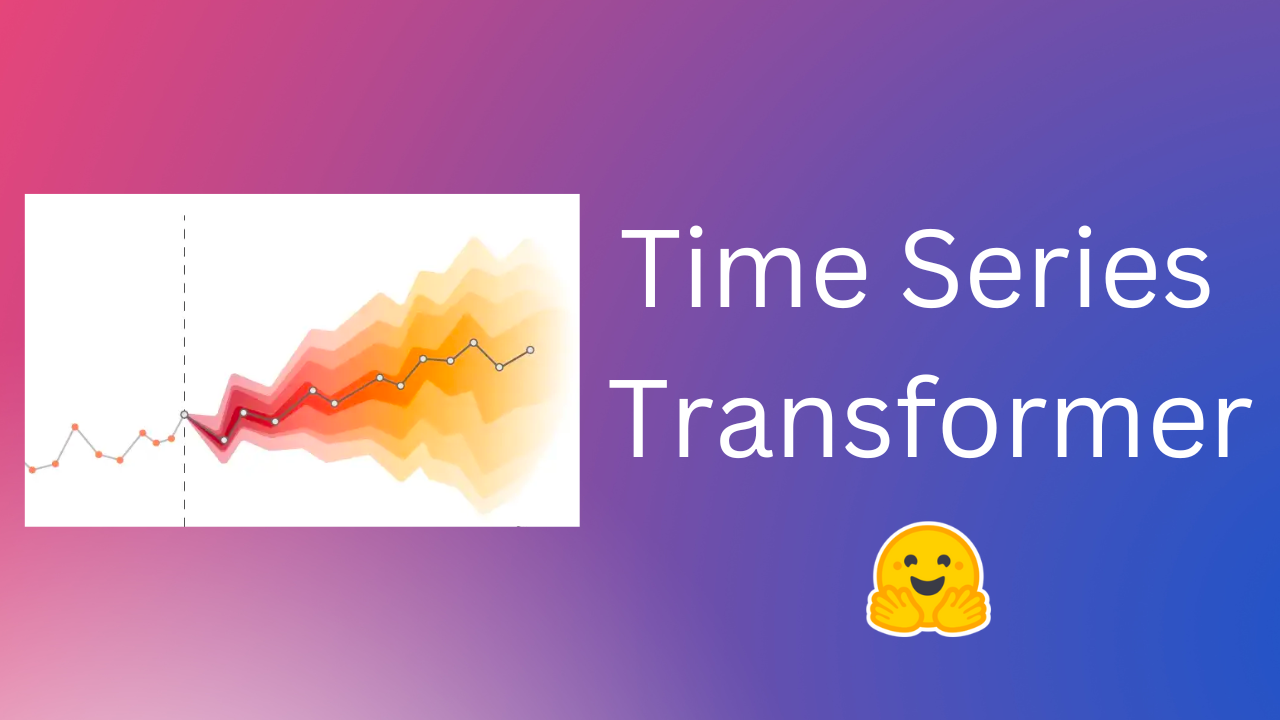
ღრმა სწავლა და ტრანსფორმერები: ინოვაციები დროითი რიგების პროგნოზირებაში
დროითი რიგების პროგნოზირება, რომელიც ტრადიციულად კლასიკურ მეთოდებს ეყრდნობოდა, დღეს ღრმა სწავლის მოდელების ინტენსიურ გამოყენებას განიცდის. სტატია მიმოიხილავს განსხვავებას ინდივიდუალურ (ლოკალურ) კლასიკურ მეთოდებსა და გლობალურ, ალბათობით ღრმა სწავლის მოდელებს შორის, რომლებიც საშუალებას აძლევენ მოდელებს ისწავლონ მრავალი წყაროდან და წარმოადგინონ პროგნოზების გაურკვევლობები. განსაკუთრებული ყურადღება ეთმობა Transformer-ის არქიტექტურას, როგორც ეფექტურ ინსტრუმენტს უნივარიატული ალბათობითი პროგნოზირებისთვი
Hugging Face-ი ხელოვნურ ინტელექტში პერსონალური მონაცემების დაცვას აძლიერებს: Presidio-ს ინტეგრაცია Dataset Hub-ში
Hugging Face-მა Dataset Hub-ზე ახალი ფუნქცია დანერგა, რომელიც Presidio-ს, ღია კოდის PII (პერსონალური საიდენტიფიკაციო ინფორმაციის) გამოვლენის ინსტრუმენტს იყენებს. ეს ფუნქცია მომხმარებლებს საშუალებას აძლევს, შეაფასონ PII-ის არსებობა მონაცემთა ნაკრებებში, რაც ეხმარება მათ მიიღონ ინფორმირებული გადაწყვეტილებები, თავიდან აიცილონ მიკერძოებული პროგნოზები და შექმნან უფრო ეთიკური ML მოდელები. ინიციატივა მიზნად ისახავს PII-ის გამოწვევების მოგვარებას მანქანურ სწავლებაში.