
Sophia Space 10 მილიონ დოლარს იზიდავს კოსმოსური კომპიუტერების გაგრილების რევოლუციური მეთოდისთვის
სტატიაში განხილულია კოსმოსში მაღალეფექტური პროცესორების გაგრილების გამოწვევა ჰაერის ნაკადის არარსებობის გამო. Sophia Space-მა 10 მილიონი დოლარი მოიზიდა, რათა განავითაროს და გამოსცადოს პასიური გაგრილების ახალი მეთოდი, რომელიც იყენებს მოდულურ სერვერის თაროებს, სახელწოდებით TILES. ეს ტექნოლოგია, რომელიც თავდაპირველად Caltech-ში მზის ენერგიის პროგრამის ფარგლებში შეიქმნა, მიზნად ისახავს ორბიტაზე გამოთვლითი სიმძლავრის ეფექტურობის მნიშვნელოვან გაუმჯობესებას სხვადასხვა სატელიტური აპლიკაციებისთვის, 2030-

ZDNET-ის რეკომენდაცია: როგორ შევცვალოთ DNS პარამეტრები Windows-სა და Mac-ზე
ZDNET განმარტავს თავისი რეკომენდაციების მნიშვნელობას, ხაზს უსვამს ტესტირებას, კვლევასა და დამოუკიდებელ სარედაქციო პროცესს, რომელიც უზრუნველყოფს მიუკერძოებელ ინფორმაციას. სტატია დეტალურად აღწერს DNS-ის ფუნქციას ინტერნეტში და იმ მიზეზებს, თუ რატომ შეიძლება დაგჭირდეთ მისი შეცვლა უსაფრთხოების, სიჩქარის ან კონფიდენციალურობის გასაუმჯობესებლად. მოცემულია კონკრეტული ნაბიჯ-ნაბიჯ ინსტრუქციები DNS სერვერის პარამეტრების შესაცვლელად Windows 11, Windows 10 და Mac ოპერაციულ სისტემებზე, სხვადასხვა ალტერნატიული

ZDNET-ის რეკომენდაციები: რას ნიშნავს ეს?
ZDNET-ის რეკომენდაციები ეფუძნება საათობით ტესტირებას, კვლევასა და შედარებით შოპინგს, რაც უზრუნველყოფს სარედაქციო შინაარსის დამოუკიდებლობას რეკლამისგან. სტატია განმარტავს VPN-ის სარგებელს iOS მოწყობილობებისთვის, როგორიცაა მონაცემთა დაშიფრვა, კონფიდენციალურობის დაცვა და გეოგრაფიულად შეზღუდული კონტენტის განბლოკვა. ZDNET-ის ექსპერტები iPhone-ისთვის საუკეთესო VPN-ად NordVPN-ს ასახელებენ, რომელიც გამოირჩევა სწრაფი სიჩქარით, მყარი კავშირით და ფართო სერვერის ქსელით. ბიუჯეტური ალტერნატივისთვის წარმოდგენი

რომელი Linux სერვერის დისტრიბუცია აირჩიოთ? ექსპერტის რჩევები
სტატიაში განხილულია ავტორის მრავალწლიანი გამოცდილება სახლის ლაბორატორიის სერვერებთან მუშაობისას, შიშველი აპარატურიდან ვირტუალურ მანქანებზე გადასვლა. შემოთავაზებულია Linux სერვერის დისტრიბუციების რეკომენდაციები, მათ შორის Ubuntu Server სიმარტივისთვის, Debian სტაბილურობისთვის, Rocky Linux (როგორც CentOS-ის მემკვიდრე) საწარმოს დონის სტაბილურობისთვის და Fedora Server კონტეინერიზაციისა და სწრაფი განახლებებისთვის.
DeepFloyd IF-ის ინტეგრაცია BentoML-თან პროდუქტიული განთავსებისთვის
სტატია მიმოიხილავს, თუ როგორ ხდება BentoML-ის, ღია კოდის პლატფორმის, გამოყენება DeepFloyd IF-ის, თანამედროვე ტექსტიდან გამოსახულების გენერირების მოდელის, განთავსებისთვის. აღწერილია DeepFloyd IF-ის უნიკალური არქიტექტურა (პიქსელურ სივრცეში მუშაობა, კასკადური დიფუზია, LLM-ის გამოყენება მოთხოვნებისთვის) და BentoML-ის მეშვეობით რესურსების ოპტიმალური მართვა, მათ შორის GPU-ს განაწილება. მოცემულია ინსტრუქციები პროექტის ლოკალურად გაშვებისთვის, მოდელების ჩამოტვირთვისთვის, სერვერის Gradio-სთან ერთად გაშვებ

AI მოდელების მასშტაბური ინფერენციის ოპტიმიზაცია: ხარჯი და შეყოვნება
ეს სტატია დეტალურად აღწერს მეთოდოლოგიას ენკოდერული მოდელების გამოყენებით მასშტაბური კლასიფიკაციისა და ემბედინგის ამოცანებისთვის ხარჯებისა და შეყოვნების გამოსათვლელად და ოპტიმიზაციისთვის. განხილულია მოდელების არქიტექტურები, აპარატურული ხარჯების ბენჩმარკინგი და ოპტიმიზაციის ჩარჩო. გამოყენებულია ისეთი ინსტრუმენტები, როგორიცაა Inference Endpoints აპარატურის შერჩევისთვის, Hugging Face Hub განთავსებისთვის, Infinity ინფერენციის სერვერისთვის და Grafana-ს k6 დატვირთვის ტესტირებისთვის. მოცემულია პრაქტიკულ

Fireworks.ai და Hugging Face: ელვისებურად სწრაფი სერვერის გარეშე AI დასკვნა ახლა ხელმისაწვდომია
Fireworks.ai ინტეგრირდა Hugging Face-ის ეკოსისტემაში, რაც მომხმარებლებს საშუალებას აძლევს, ელვისებურად სწრაფად გაუშვან სერვერის გარეშე დასკვნები (serverless inference) საყვარელ AI მოდელებზე. ეს თანამშრომლობა ამარტივებს პროცესს, გთავაზობთ მოქნილ ბილინგის ვარიანტებს და PRO მომხმარებლებისთვის განკუთვნილ უპირატესობებს, მათ შორის ყოველთვიურ კრედიტებს.
Gradio-lite: Gradio აპლიკაციების გაშვება პირდაპირ ბრაუზერში Pyodide-ით
Gradio-lite არის JavaScript ბიბლიოთეკა, რომელიც საშუალებას გაძლევთ გაუშვათ Gradio აპლიკაციები პირდაპირ ვებ ბრაუზერში, Pyodide-ის გამოყენებით (Python runtime WebAssembly-ისთვის). ეს გამორიცხავს სერვერის ინფრასტრუქტურის საჭიროებას, ამარტივებს დეპლოიმენტს, ამცირებს ხარჯებს და უზრუნველყოფს სწრაფ ინტერაქციასა და მონაცემთა დაცვას. სტატიაში აღწერილია Gradio-lite-ის ძირითადი ფუნქციები, აპლიკაციის შექმნა, მრავალფაილიანი პროექტებისა და დამატებითი მოთხოვნების მართვა. განხილულია მისი უპირატესობები, როგორიცა
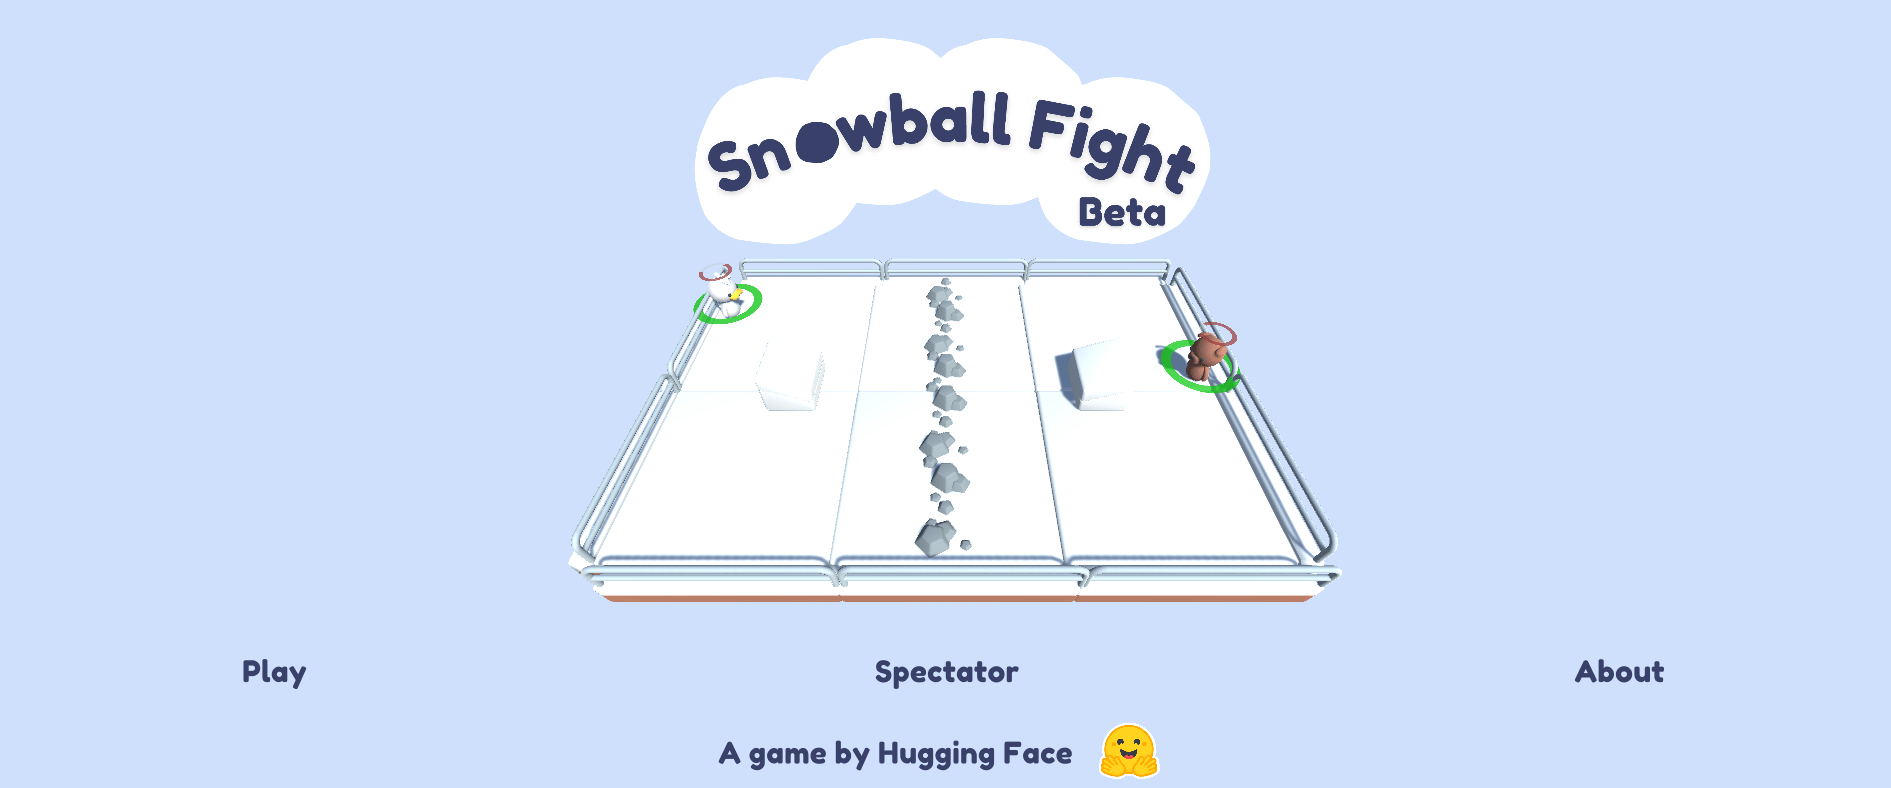
Hugging Face-ი აფართოებს Deep Reinforcement Learning-ის ეკოსისტემას Unity ML-Agents-ით: ახალი თამაში და საზოგადოება
Hugging Face-ი, Unity ML-Agents-ის გამოყენებით, ღრმა გაძლიერებითი სწავლების მკვლევრებისა და ენთუზიასტებისთვის ეკოსისტემას აფართოებს. ამ ინიციატივის ფარგლებში წარმოდგენილია თამაში „Snowball Fight“ და ახალი Discord სერვერი საზოგადოების ჩართულობისთვის.

LLM ინფერენციის სამართლიანი დაგეგმვა: გამოწვევები და გადაწყვეტები
სტატია მიმოიხილავს LLM ინფერენციის ძრავებში (მაგ. vLLM, HuggingFace TGI) სამართლიანი დაგეგმვის გამოწვევებს, სადაც GPU-ზე ჯგუფური დამუშავება ეფექტურია, თუმცა ერთი მომხმარებელი ხშირად მონოპოლიზებს ბექენდის რიგს. TNG-ის მიერ შემოთავაზებული გადაწყვეტა მოიცავს ცალკე API სერვერს ("LLM-სერვერს"), რომელიც მართავს მოთხოვნებს ინფერენციის ძრავამდე. ეს სერვერი იყენებს თითოეული მომხმარებლისთვის ცალკეულ რიგებს და "მრგვალი მაგიდის" (round-robin) პრინციპით დაგეგმვას სამართლიანობისთვის. ის ასევე ითვალისწინებს მო

Gradio-ს რევოლუციური განახლება: MCP სერვერები LLM-ებისთვის
Gradio, პოპულარული Python ბიბლიოთეკა, რომელიც გამოიყენება მანქანური სწავლების მოდელებისთვის ინტერფეისების შესაქმნელად, ახლა დეველოპერებს საშუალებას აძლევს, გაუშვან Gradio აპლიკაციები Model Context Protocol (MCP) სერვერებად დიდი ენობრივი მოდელებისთვის (LLMs). ეს ინოვაცია Gradio აპებს აქცევს მძლავრ ხელსაწყოებად, რომელთა გამოყენება LLM-ებს შეუძლიათ სხვადასხვა ამოცანებისთვის – გამოსახულების გენერირებიდან დაწყებული, კონკრეტული გამოთვლებით დამთავრებული. სტატია აღწერს MCP სერვერის აგებას რამდენიმე ხაზი

TRL და vLLM-ის კოლოკაცია: ხელოვნური ინტელექტის მოდელების წვრთნის რევოლუცია GPU-ების ოპტიმიზაციით
ტრადიციულად, დიდი ენობრივი მოდელების (LLM) GRPO ალგორითმით წვრთნა, vLLM-ის სერვერის რეჟიმში გამოყენებისას, გრაფიკული პროცესორების (GPU) არაეფექტურ გამოყენებას იწვევდა. TRL-ის v0.18.0 ვერსიიდან, vLLM-თან ერთობლივი მუშაობის (კოლოკაციის) მხარდაჭერა საშუალებას იძლევა, წვრთნა და ინფერენცია ერთსა და იმავე GPU-ებზე განხორციელდეს. ეს მიდგომა მნიშვნელოვნად ამცირებს უქმ დროს, აუმჯობესებს გამტარუნარიანობას და ამარტივებს განლაგებას, რაც LLM-ების წვრთნას უფრო სწრაფს, ეკონომიურს და მასშტაბირებადს ხდის.
TRL და vLLM: GPU-ის ეფექტურობის ახალი ერა კოლოკაციის წყალობით
TRL-ის ბიბლიოთეკამ მნიშვნელოვანი სიახლე დანერგა, რაც LLM-ების (დიდი ენობრივი მოდელების) წვრთნის პროცესს vLLM-თან GRPO ალგორითმის გამოყენებით უფრო ეფექტურს ხდის. ადრე vLLM სერვერის რეჟიმში მუშაობდა, რაც GPU-ის რესურსების არაეფექტურ გამოყენებასა და უმოქმედო დროს იწვევდა. ახალი „კოლოკაციის“ რეჟიმი წვრთნისა და ინფერენციის ერთსა და იმავე GPU-ებზე, ერთსა და იმავე პროცესთა ჯგუფში გაშვების საშუალებას იძლევა, რაც მნიშვნელოვნად ზრდის შესრულებას, ამცირებს აპარატურულ დანახარჯებს და ამარტივებს დეპლოირებას.

Hugging Face-ის MCP სერვერის შექმნა: AI ასისტენტების დაკავშირების გამოცდილება და პროტოკოლის ევოლუცია
Hugging Face-ის გუნდი დეტალურად აღწერს Model Context Protocol (MCP) სერვერის შექმნის პროცესს, რომელიც ხელოვნური ინტელექტის ასისტენტებს გარე სამყაროსთან აკავშირებს. სტატია აანალიზებს პროტოკოლის სწრაფ ევოლუციას, ტრანსპორტის სხვადასხვა ვარიანტს (STDIO, HTTP SSE-ით, ნაკადოვანი HTTP) და იმ ტექნიკურ გადაწყვეტილებებს, რომლებიც Hugging Face-მა მიიღო ოპტიმალური, დინამიური და ადვილად ხელმისაწვდომი hf.co/mcp სერვერის შესაქმნელად. ყურადღება ექცევა უსტატუსო, პირდაპირი პასუხის კონფიგურაციის არჩევანს წარმოების
Gradio-ს გადატვირთვის რეჟიმი: ხელოვნური ინტელექტის აპლიკაციების სწრაფი შექმნა
ეს სტატია განმარტავს Gradio-ს გადატვირთვის რეჟიმის (reload mode) მუშაობის პრინციპს, რაც დეველოპერებს საშუალებას აძლევს, ავტომატურად განაახლონ კოდის ცვლილებები სერვერის გადატვირთვის გარეშე. აღწერილია, თუ როგორ შეიძლება ამ რეჟიმის გამოყენება ხელოვნური ინტელექტის აპლიკაციის სწრაფად შესაქმნელად Hugging Face Inference API-სა და LLM-ების მეშვეობით, რომელიც დოკუმენტების სურათებიდან შეკითხვებზე პასუხებს ბუნებრივ ენაზე გასცემს.

LLM ინფერენსის ოპტიმიზაცია: Hugging Face TGI ბენჩმარკინგი
ეს სტატია განმარტავს, თუ როგორ ხდება დიდი ენობრივი მოდელების (LLM) ინფერენსის ოპტიმიზაცია Hugging Face-ის მაღალეფექტური ტექსტის გენერაციის ინფერენსის (TGI) სერვერის გამოყენებით. დეტალურად განიხილება LLM-ების თანდაყოლილი არაეფექტურობა, ინდუსტრიის მიერ მიღწეული გაუმჯობესებები მუშაობის ოპტიმიზაციაში, ასევე ბენჩმარკინგის მნიშვნელობა სხვადასხვა გამოყენების შემთხვევებისთვის, როგორიცაა RAG და ჩატი. სახელმძღვანელო განმარტავს ძირითად მეტრიკებს, როგორიცაა ლატენტურობა და გამტარუნარიანობა, და გვიჩვენებს, თუ