
Embedding მოდელების ოპტიმალური განთავსება Hugging Face Inference Endpoints-ზე: მაღალი წარმადობა და ხარჯთეფექტურობა
ამ სტატიაში განხილულია, თუ როგორ განვათავსოთ ღია კოდის Embedding მოდელები Hugging Face Inference Endpoints-ზე Text Embedding Inference (TEI) გადაწყვეტის გამოყენებით. ხაზგასმულია Embedding მოდელების უპირატესობა დიდი ენობრივი მოდელების (LLM-ების) მიმართ ზომისა და ინფერენსის სიჩქარის კუთხით. სტატია დეტალურად აღწერს Inference Endpoints-ის მახასიათებლებს, როგორიცაა ავტომატური მასშტაბირება და ნულამდე მასშტაბირება, და წარმოადგენს TEI-ს, როგორც მაღალი წარმადობისა და ხარჯთეფექტურობის გარანტს. ნაჩვენებია,
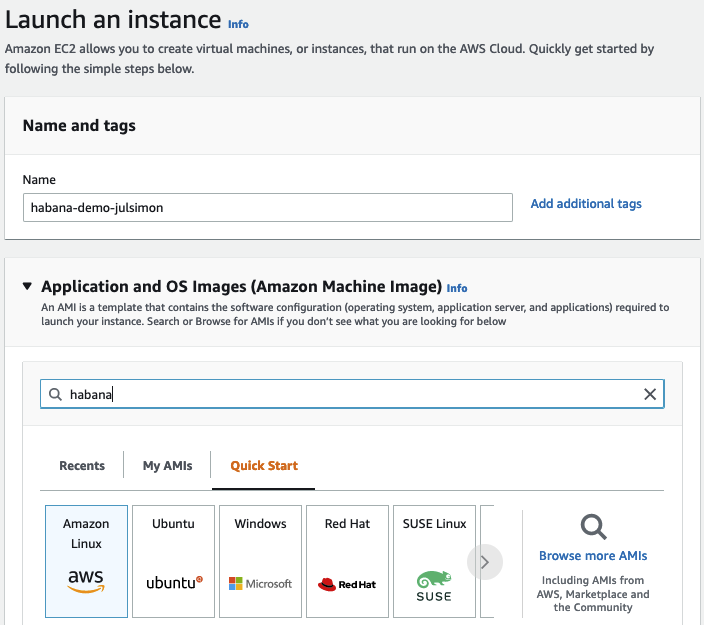
Habana Gaudi-ის ამაჩქარებლები და Transformer-ები: მაღალი წარმადობა და ხარჯთეფექტურობა AWS-ზე
Habana Gaudi-ის ახალი ამაჩქარებლები Amazon EC2 ინსტანციებზე უზრუნველყოფენ 40%-მდე უკეთეს ფასი-წარმადობას მანქანური სწავლის მოდელების, განსაკუთრებით Transformer-ების, წვრთნისთვის, უახლეს GPU-ებთან შედარებით. ეს პოსტი აღწერს, თუ როგორ სწრაფად დავაყენოთ Habana Gaudi ინსტანცია AWS-ზე და დავხვეწოთ BERT მოდელი ტექსტის კლასიფიკაციისთვის, რაც დემონსტრირებას უკეთებს ამ ტექნოლოგიის სიმარტივესა და ხარჯთეფექტურობას.
AWS Inferentia2 აფართოებს ხელოვნური ინტელექტის შესაძლებლობებს Hugging Face-ის მომხმარებლებისთვის
Amazon Web Services (AWS) აცხადებს, რომ მისი უახლესი მანქანური სწავლების ჩიპი, Inferentia2, სრულად ხელმისაწვდომია Hugging Face Hub-ის მომხმარებლებისთვის. ეს ინტეგრაცია მნიშვნელოვნად ამარტივებს დიდი ენობრივი მოდელების (LLMs) და სხვა AI მოდელების განთავსებასა და გამოყენებას AWS SageMaker-ზე და Hugging Face Inference Endpoints-ის მეშვეობით. Inferentia2 ინსტანციები გვთავაზობს მაღალ წარმადობას, ხარჯთეფექტურობას და მხარდაჭერას 100,000-ზე მეტი მოდელისა და ამოცანისთვის, მათ შორის Llama 3-ისთვის, რაც ხელ

ხელოვნური ინტელექტი დოკუმენტების დამუშავებაში: ხედვა-ენის მოდელების აღზევება და სწორი არჩევანის გზამკვლევი
მძლავრი ხედვა-ენის მოდელების (VLM) განვითარებამ დოკუმენტების ხელოვნური ინტელექტის სფერო (Document AI) გარდაქმნა. თითოეულ მოდელს უნიკალური შესაძლებლობები აქვს, რაც მათ შორის არჩევანს ართულებს. ღია წონის მოდელები უკეთეს ხარჯთეფექტურობასა და კონფიდენციალურობას გვთავაზობს. ეს გზამკვლევი დაგეხმარებათ გაიგოთ, როგორ შეარჩიოთ სწორი ოპტიკური სიმბოლოების ამოცნობის (OCR) მოდელი, დაიწყოთ მისი გამოყენება და მიიღოთ ღრმა ცოდნა დოკუმენტების ხელოვნური ინტელექტის შესახებ. სტატია მიმოიხილავს OCR-ის განვითარებას, თ
სახელმძღვანელო ღია წონის OCR მოდელებისთვის: როგორ ავირჩიოთ და გამოვიყენოთ ისინი დოკუმენტების AI-ში
მძლავრი ვიზუალური-ლინგვალური მოდელების (VLM) გაჩენამ რევოლუცია მოახდინა დოკუმენტების ხელოვნური ინტელექტის (AI) სფეროში, თუმცა სწორი მოდელის არჩევა რთულია. ღია წონის მოდელები გვთავაზობს ხარჯთეფექტურობასა და კონფიდენციალურობას. ეს სახელმძღვანელო დაგეხმარებათ გაიგოთ, როგორ ფუნქციონირებს OCR, როგორ ამუშავებს თანამედროვე VLM-ები რთულ დოკუმენტებს, მათ შორის ცხრილებსა და დიაგრამებს, რა გამომავალ ფორმატებს იყენებენ და როგორ ირჩევა შესაფერისი მოდელი თქვენი საჭიროებებისთვის. სტატია გთავაზობთ რჩევებს მოდელ