
DeepSeek-R1 მოდელების გამოშვება და განთავსება AWS-სა და Hugging Face-ზე: ახალი შესაძლებლობები ხელოვნურ ინტელექტში
DeepSeek-მა გამოუშვა თავისი DeepSeek-R1 მოდელი, რომელიც მნიშვნელოვნად აუმჯობესებს მსჯელობითი ამოცანების გადაჭრას, როგორიცაა მათემატიკა და კოდირება, OpenAI-ის მსგავსად. Hugging Face, Amazon Web Services-თან თანამშრომლობით, დეველოპერებს სთავაზობს ამ მოდელების მარტივად განთავსებასა და დახვეწას AWS სერვისებზე, მათ შორის Inference Endpoints-სა და Amazon SageMaker-ზე. სტატია დეტალურად აღწერს განთავსების პროცესს Python SageMaker SDK-ისა და Jumpstart-ის გამოყენებით, ასევე Neuron ინსტანციებზე, რაც ხელს უ
Hugging Face-ისა და Amazon-ის სტრატეგიული პარტნიორობა: უახლესი ML მოდელების გამოყენების გამარტივება SageMaker-ში
Hugging Face-მა და Amazon-მა სტრატეგიული პარტნიორობა გამოაცხადეს, რათა კომპანიებისთვის უახლესი მანქანური სწავლების (ML) მოდელების გამოყენება და NLP ფუნქციების სწრაფად დანერგვა გაამარტივონ. Hugging Face Amazon Web Services-ს (AWS) სასურველ ღრუბლოვან პროვაიდერად ირჩევს. ამ თანამშრომლობის პირველი ნაბიჯი Hugging Face-ის ახალი ღრმა სწავლების კონტეინერების (DLCs) შეთავაზებაა, რაც Amazon SageMaker-ში Transformer მოდელების გაწვრთნას უპრეცედენტოდ ამარტივებს.
Fetch-მა ქვითრების სკანირების სიზუსტე 200%-ით გაზარდა AWS-ის მანქანური სწავლისა და Hugging Face-ის გამოყენებით
Fetch-მა, მომხმარებლის ჩართულობისა და ჯილდოების კომპანიამ, მნიშვნელოვნად გააუმჯობესა ქვითრების სკანირების აპლიკაციის სიჩქარე და სიზუსტე, Amazon Web Services-ზე (AWS) მანქანური სწავლების პაიპლაინის ოპტიმიზაციით, Hugging Face-ისა და Amazon SageMaker-ის გამოყენებით. ამ ცვლილებამ დოკუმენტის აღქმის მოდელის სიზუსტე 200%-ით გაზარდა და ნელი სკანირებისთვის დაყოვნება 50%-ით შეამცირა, რამაც დააჩქარა ჯილდოების დამუშავება და გაზარდა პარტნიორების ნდობა.
Amazon SageMaker ამარტივებს Hugging Face Transformers-ის დეპლოირებას ახალი Inference DLC-ებითა და ხელსაწყოებით
Amazon SageMaker-მა გამოუშვა Hugging Face Inference DLC-ები და ახალი Inference Toolkit, რაც მნიშვნელოვნად ამარტივებს Hugging Face Transformers მოდელების დეპლოირებას. ეს სიახლე საშუალებას აძლევს მომხმარებლებს, მარტივად განათავსონ როგორც საკუთარი გაწვრთნილი მოდელები, ისე Hugging Face Model Hub-დან 10,000-ზე მეტი საჯაროდ ხელმისაწვდომი მოდელი, სულ ერთი დამატებითი კოდის ხაზით. SageMaker უზრუნველყოფს საპროდუქციო გარემოსთვის მზა ენდპოინტებს ჩაშენებული მონიტორინგითა და მასშტაბირებადი შესაძლებლობებით.
ახალი ბენჩმარკი: Llama 2-ის განლაგების ოპტიმალური სტრატეგიები Amazon SageMaker-ზე
დიდი ენობრივი მოდელების (დემ) განლაგება გამოწვევებთან არის დაკავშირებული მათი გამოთვლითი მოთხოვნებისა და დაყოვნების საჭიროებების გამო. ამ პრობლემის გადასაჭრელად, შემუშავდა ყოვლისმომცველი ბენჩმარკი, რომელმაც შეაფასა Llama 2-ის 60-ზე მეტი განლაგების კონფიგურაცია Amazon SageMaker-ზე Hugging Face-ის დემ დასკვნის კონტეინერის გამოყენებით. კვლევამ მიზნად დაისახა ოპტიმალური სტრატეგიების მოძიება კომპანიებისთვის, რათა დააბალანსონ ხარჯები, გამტარუნარიანობა და დაყოვნება Llama 2-ის სხვადასხვა ზომისა და Amazo
Llama 2-ის განლაგების ბენჩმარკინგი Amazon SageMaker-ზე: ოპტიმალური სტრატეგიები წარმადობისა და ხარჯთეფექტურობისთვის
დიდი ენობრივი მოდელების (LLM) განლაგება, როგორიცაა Llama 2, კომპლექსური გამოწვევაა. Amazon Web Services-მა ჩაატარა მასშტაბური ბენჩმარკინგი, შეაფასა Llama 2-ის 60-ზე მეტი კონფიგურაცია Amazon SageMaker-ზე, Hugging Face LLM დასკვნის კონტეინერის გამოყენებით. კვლევამ გააანალიზა შეყოვნება და გამტარობა Llama 2-ის სხვადასხვა ზომისა და EC2 ინსტანციების მიხედვით, რათა შეემუშავებინა ოპტიმალური რეკომენდაციები ხარჯთეფექტურობის, მაქსიმალური გამტარობისა და მინიმალური შეყოვნებისთვის. ძირითადი აღმოჩენები მოიცავს
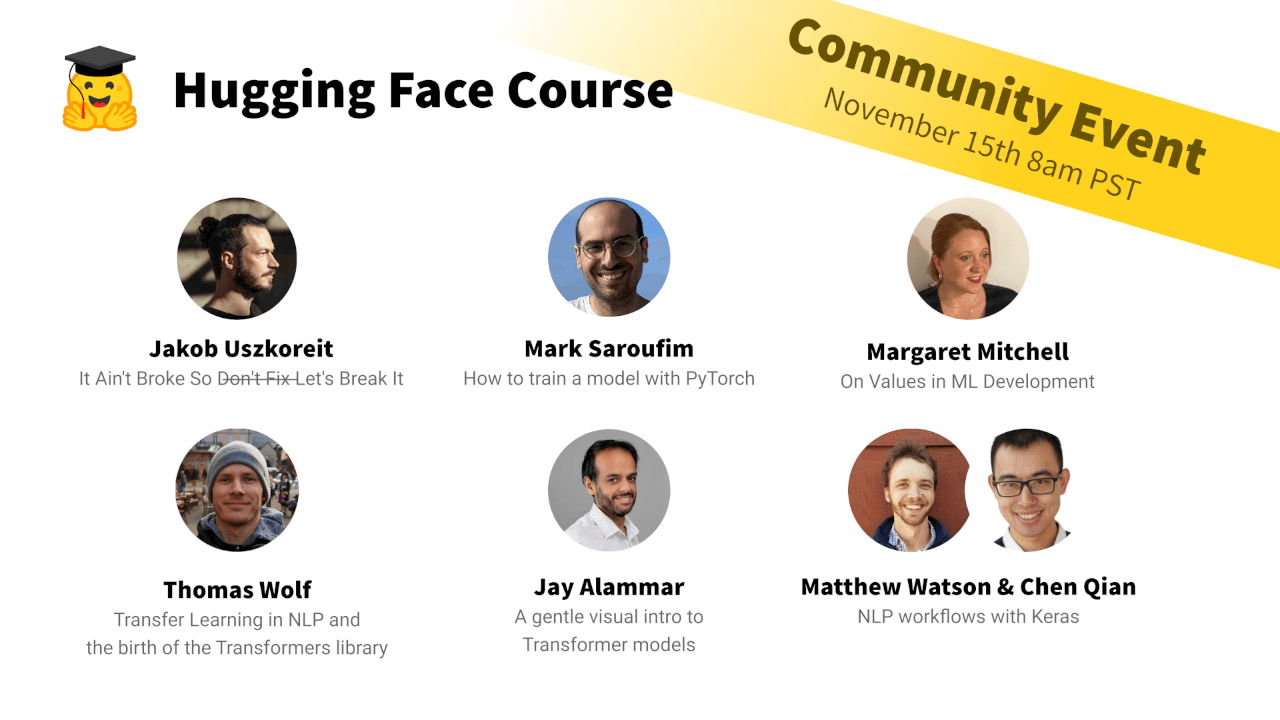
გეპატიჟებით ხელოვნური ინტელექტის საზოგადოებრივ ღონისძიებაზე: წამყვანი ექსპერტების მოხსენებები და პრაქტიკული პროექტები
ამ მასშტაბურ ღონისძიებაზე მონაწილეებს შესაძლებლობა ექნებათ მოუსმინონ ხელოვნური ინტელექტისა და ბუნებრივი ენის დამუშავების (NLP) სფეროს წამყვან ექსპერტებს, მათ შორის HuggingFace-ის თანადამფუძნებელ თომას ვოლფს და ეთიკური AI-ის მკვლევარ მარგარეტ მიტჩელს. ორდღიანი მოხსენებების შემდეგ გაიმართება გუნდური პროექტები მოდელების „დაფაინთუნებაზე“ (fine-tuning), რომელიც დასრულდება ცოცხალი დემონსტრაციებით. AWS აფინანსებს ღონისძიებას Amazon SageMaker-ის მეშვეობით უფასო გამოთვლითი რესურსებით, ხოლო წარმატებული მო
GPT-J-ის ეფექტური დეპლოირება Amazon SageMaker-ისა და Hugging Face-ის გამოყენებით
სტატია განიხილავს EleutherAI-ის GPT-J მოდელის წარმოებაში ინტეგრაციის გამოწვევებს, განსაკუთრებით მეხსიერების მოხმარებისა და ჩატვირთვის ხანგრძლივი დროის თვალსაზრისით. ის წარმოადგენს გადაწყვეტას Amazon SageMaker-ისა და Hugging Face Inference Toolkit-ის გამოყენებით, PyTorch-ის მოდელების შენახვის ოპტიმიზებული მეთოდის მეშვეობით, რაც მნიშვნელოვნად ამცირებს ჩატვირთვის დროს (1 წუთი და 23 წამიდან 7.7 წამამდე) და GPT-J-ს საწარმოო სცენარებისთვის თავსებადს ხდის.
Llama 2-ის ეფექტური განთავსება AWS Inferentia2-ზე Hugging Face Optimum Neuron-ის მეშვეობით
Hugging Face-ის ბლოგზე ადრე წარდგენილი AWS Inferentia2-ის გაფართოების შედეგად, ახლა შესაძლებელია დიდი ენობრივი მოდელების (LLM) განთავსება ტექსტის გენერაციისთვის AWS Inferentia2 ინსტანციებზე Optimum Neuron-ის გამოყენებით. სტატია დეტალურად აღწერს Llama 2-ის განთავსების პროცესს, გთავაზობთ რეკომენდაციებს Hugging Face Neuron Deep Learning AMI-ზე ან Amazon SageMaker-ზე განთავსების შესახებ და განმარტავს მოდელების კომპილაციასა და ექსპორტს. ასევე, მოცემულია Inferentia2-ზე ტექსტის გენერაციის ეფექტურობის ა

BERT-ისა და ტრანსფორმერების დაჩქარება AWS Inferentia-ს მეშვეობით: სრულფასოვანი გზამკვლევი
ტრანსფორმერებზე დაფუძნებული მოდელები ხელოვნურ ინტელექტში სულ უფრო ფართოდ გამოიყენება, თუმცა მათი ზომა და სირთულე დიდმასშტაბიანი ამოცანებისთვის გამოწვევას წარმოადგენს. AWS ამ პრობლემას Inferentia ჩიპით აგვარებს, რომელიც სპეციალურად ოპტიმიზირებულია ინფერენციისთვის, უზრუნველყოფს ხარჯების 80%-მდე შემცირებას და 2.3-ჯერ მეტ გამტარუნარიანობას. ეს სტატია განმარტავს, თუ როგორ შეიძლება Hugging Face Transformers-ის, Amazon SageMaker-ისა და AWS Inferentia-ს კომბინაციით BERT-ის ინფერენციის დაჩქარება ტექსტის
დიდი ენობრივი მოდელების (LLMs) მაღალეფექტური განთავსება: TGI და AWS Inferentia2 Amazon SageMaker-ში
ტექსტის გენერირების ინფერენცია (TGI) წარმოადგენს სპეციალურად შექმნილ გადაწყვეტას დიდი ენობრივი მოდელების (LLMs) მასშტაბური განთავსებისა და სერვისისთვის. TGI უზრუნველყოფს მაღალეფექტურ ტექსტის გენერაციას Tensor Parallelism-ისა და უწყვეტი დაჯგუფების გამოყენებით Llama-ს, Mistral-ის და სხვა პოპულარული ღია LLM-ებისთვის. AWS Inferentia2-თან ინტეგრაცია Amazon SageMaker-ში TGI-ს აქცევს მძლავრ ალტერნატივად GPU-ებისთვის LLM აპლიკაციების შესაქმნელად. ეს ინტეგრაცია ამარტივებს მოდელების განთავსებას და შენარჩუ
ღია Embedding მოდელების განთავსება Amazon SageMaker-ზე Hugging Face Embedding კონტეინერის გამოყენებით
ეს ბლოგი დეტალურად აღწერს, თუ როგორ უნდა განათავსოთ ღია Embedding მოდელები, როგორიცაა Snowflake Arctic Embed, Amazon SageMaker-ზე ინფერენციისთვის, ახალი Hugging Face Embedding კონტეინერის გამოყენებით. სტატია მოიცავს განვითარების გარემოს დაყენებას, კონტეინერის მოძიებას, მოდელის განთავსებას და მისი მუშაობის შეფასებას როგორც CPU, ასევე GPU ინსტანციებზე, ხაზს უსვამს Text Embedding Inference (TEI)-ის ეფექტურობას და ხარჯ-ეფექტურობას.