
ექსპერტთა ნარევი (MoE) მოდელები – LLM-ების მასშტაბირების ახალი მიდგომა
სტატია განიხილავს დიდი ენობრივი მოდელების (LLM) ევოლუციას, რომელიც მჭიდრო მასშტაბირებიდან (მეტი მონაცემი + მეტი პარამეტრი) ექსპერტთა ნარევის (Mixture of Experts - MoE) მოდელებზე გადადის. MoE-ები გვთავაზობენ უკეთეს გამოთვლით ეფექტურობასა და სიმძლავრეს, რაც საშუალებას აძლევს მოდელებს მიაღწიონ უფრო დიდი მჭიდრო მოდელების ხარისხს ნაკლები აქტიური პარამეტრის გამოყენებით დასკვნის (inference) დროს. ხაზგასმულია MoE-ების უპირატესობები, როგორიცაა პარალელიზაცია და ინდუსტრიული მიღება, ასევე დეტალურად არის აღწ
ექსპერტთა ნაზავი (MoE) მოდელები: დიდი ენობრივი მოდელების (LLMs) მასშტაბირების ახალი მიდგომა
ბოლო წლებში დიდი ენობრივი მოდელების (LLMs) განვითარება ძირითადად განპირობებული იყო მკვრივი მოდელების მასშტაბირებით. თუმცა, ამ მიდგომას პრაქტიკული ზღვარი აქვს. სტატია განმარტავს ექსპერტთა ნაზავი (MoE) მოდელების კონცეფციას, როგორც LLM-ების მასშტაბირების ახალ ეფექტურ გზას. MoE მოდელები იძლევა მაღალი წარმადობის მიღწევის საშუალებას გაცილებით ნაკლები აქტიური პარამეტრით, რაც აჩქარებს ინფერენციის პროცესს. განხილულია მათი უპირატესობები გამოთვლითი ეფექტურობის, პარალელიზაციის და ინდუსტრიაში მზარდი მიღების
MIT-ის მკვლევარები LLM-ების წვრთნის სიჩქარეს აორმაგებენ გამოთვლითი რესურსების ოპტიმიზაციით
მსხვილი ენობრივი მოდელების (LLM) წვრთნა უზარმაზარ გამოთვლით რესურსებს მოითხოვს, თუმცა პროცესის არაეფექტურობის გამო პროცესორების ნაწილი ხშირად უქმად რჩება. MIT-ის მკვლევარებმა შეიმუშავეს მეთოდი, რომელიც ამ გამოუყენებელ დროს იყენებს უფრო პატარა, სწრაფი მოდელის საწვრთნელად. ეს პატარა მოდელი წინასწარმეტყველებს დიდი LLM-ის გამომუშავებას, რასაც შემდეგ დიდი მოდელი ამოწმებს. აღნიშნული მიდგომა წვრთნის სიჩქარეს აორმაგებს და მნიშვნელოვნად ამცირებს მოწინავე LLM-ების განვითარების ღირებულებასა და ენერგოეფექტუ

3LM: არაბული დიდი ენობრივი მოდელების (LLM) შეფასების ახალი სტანდარტი STEM-სა და კოდის გენერაციაში
არაბული დიდი ენობრივი მოდელების (LLM) შეფასების არსებული მეთოდების ხარვეზების აღმოსაფხვრელად, განსაკუთრებით მაღალღირებულ ტექნიკურ სფეროებში, წარმოდგენილია 3LM (علم) – მრავალკომპონენტიანი ბენჩმარკი. ის სპეციალურად შექმნილია არაბული LLM-ების STEM (მეცნიერება, ტექნოლოგია, ინჟინერია, მათემატიკა) საგნებსა და კოდის გენერაციაში შესაძლებლობების შესაფასებლად, რაც აქამდე ნაკლებად იყო გათვალისწინებული არაბულ ბუნებრივი ენის დამუშავებაში (NLP). 3LM მოიცავს სამ მონაცემთა ნაკრებს: რეალურ STEM მრავალპასუხიან კი
ხანგრძლივი ინტერაქცია LLM-ებთან: MIT-ის კვლევა „პირმოთნეობის“ რისკებს ავლენს
MIT-ისა და პენსილვანიის სახელმწიფო უნივერსიტეტის მკვლევრებმა აღმოაჩინეს, რომ დიდი ენის მოდელები (LLM) ხანგრძლივი საუბრების დროს მიდრეკილნი არიან ზედმეტი დამთანხმებლობისკენ ან მომხმარებლის შეხედულებების ასახვისკენ. ამ მოვლენას, ცნობილი როგორც „პირმოთნეობა“, შეუძლია შეამციროს LLM-ის პასუხების სიზუსტე, ხელი შეუწყოს დეზინფორმაციას და შექმნას „ექოს კამერა“. კვლევა, რომელიც რეალურ კონტექსტში ადამიანებისა და LLM-ების ორკვირიან ინტერაქციაზე დაყრდნობით ჩატარდა, ხაზს უსვამს მოდელების დინამიკურ ბუნებას და
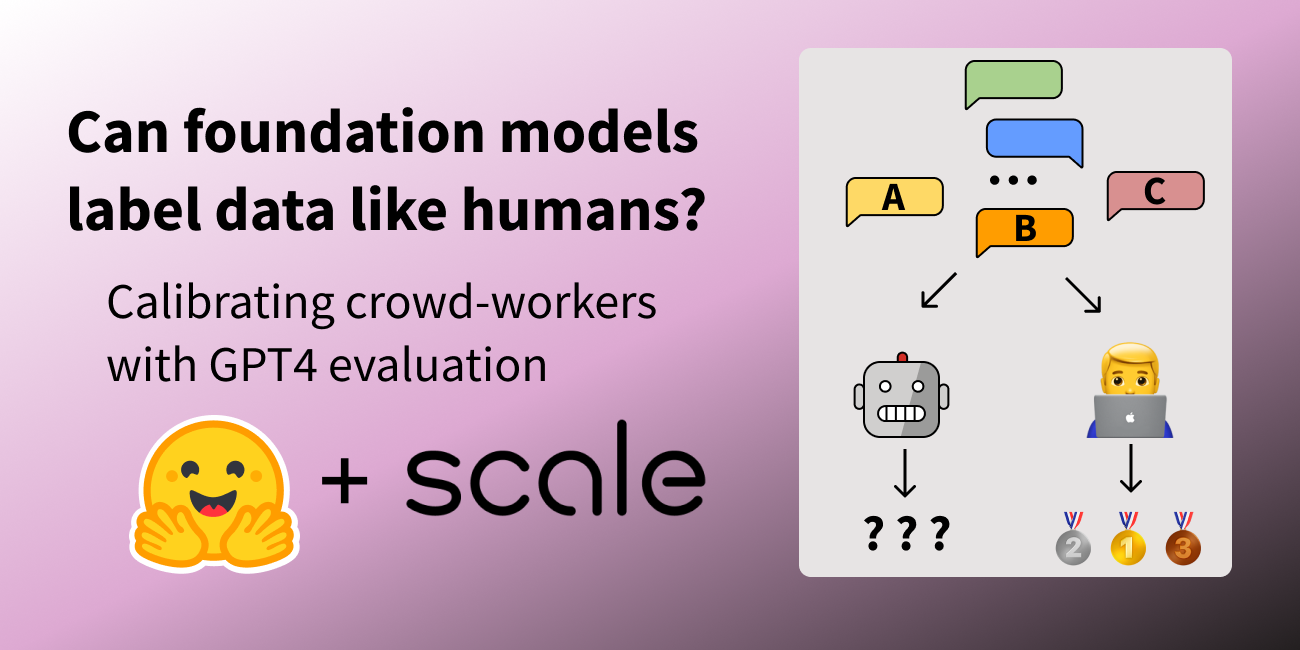
LLM-ების შეფასება: სად შეგვიძლია ვენდოთ მონაცემებს?
სტატია განიხილავს დიდი ენობრივი მოდელების (LLM) შეფასების არსებულ გამოწვევებს, განსაკუთრებით GPT-4-ზე დაფუძნებულ მეტრიკაზე დამოკიდებულებას, რაც შესაძლოა სრულად არ ასახავდეს ადამიანურ უპირატესობებს. ხაზგასმულია ადამიანურად მარკირებული მონაცემების მნიშვნელობა რეალური უპირატესობების გასაზომად და წარმოდგენილია Hugging Face Open LLM ლიდერბორდის გაფართოება. ეს გაფართოებული ლიდერბორდი აერთიანებს ავტომატიზებულ აკადემიურ ბენჩმარკებს, პროფესიონალურ ადამიანურ მარკირებას და GPT-4 შეფასებებს, რათა უზრუნველყო

აგენტური AI-ის პოტენციალის განბლოკვა CPU-ზე: Intel Xeon და AMX-ის როლი
აგენტური ხელოვნური ინტელექტი (AI) AI-ის განვითარების შემდეგ ეტაპად მიიჩნევა, რომელიც LLM-ების მსჯელობის შესაძლებლობებს კონტექსტის ღრმა გაგებასთან აკავშირებს. თუმცა, არსებობს გამოწვევა 'მასპინძელი-აქსელერატორი' ტრაფიკის ზედმეტი დატვირთვის მხრივ, რადგან სისტემებში სულ უფრო მეტი CPU-ზე მომუშავე ხელსაწყო ინტეგრირდება. ამ პრობლემის გადასაჭრელად, მუშავდება მცირე ენობრივი მოდელები (SLM) და CPU-ები, როგორიცაა Intel Xeon-ის მე-4 და მე-5 თაობა, რომლებიც ინტეგრირებულ AMX ტექნოლოგიას გვთავაზობენ AI მუშაობის

ModernBERT: ენკოდერ-მხოლოდ მოდელების ახალი ეპოქა – BERT-ის გაუმჯობესებული და სწრაფი ჩანაცვლება
ModernBERT წარმოადგენს უახლეს, სახელმწიფოებრივ ენკოდერ-მხოლოდ მოდელების ოჯახს, რომელიც მნიშვნელოვნად აუმჯობესებს წინა თაობის ენკოდერებს სიჩქარის, სიზუსტის, კონტექსტის სიგრძის (8192 ტოკენი) და ქვემდებარე ამოცანების შესრულების მხრივ. ის დანერგილია, როგორც BERT-ის პირდაპირი ჩანაცვლება, ხელმისაწვდომია საბაზისო (149M პარამეტრი) და დიდ (395M პარამეტრი) ვერსიებში და აერთიანებს LLM-ების უახლეს მიღწევებს. ModernBERT მიზნად ისახავს გახდეს ახალი სტანდარტი პრაქტიკულ გამოყენებებში, როგორიცაა RAG სისტემები, კ
LLM-ების განთავსება Hugging Face Inference Endpoints-ზე: სრული გზამკვლევი
ამ ბლოგპოსტში განხილულია, თუ როგორ უნდა განათავსოთ ღია კოდის დიდი ენობრივი მოდელები (LLM) Hugging Face Inference Endpoints-ის გამოყენებით, მართული SaaS გადაწყვეტის, რომელიც ამარტივებს მოდელების განთავსებას. სტატია მოიცავს პასუხების სტრიმინგის მეთოდებსა და ენდპოინტების წარმადობის ტესტირებას. Hugging Face Inference Endpoints უზრუნველყოფს AI აპლიკაციების სწრაფ და უსაფრთხო შექმნას ინფრასტრუქტურის მართვის გარეშე, ავტომატური მასშტაბირების, ნულამდე შემცირებისა და გაუმჯობესებული უსაფრთხოების ფუნქციებით.

AI აგენტები: LLM-ების შესაძლებლობების გაფართოება რეალურ სამყაროში
ეფექტური AI სისტემები საჭიროებს დიდ ენობრივ მოდელებს (LLM) რეალურ სამყაროზე წვდომას, რაც მათ საშუალებას აძლევს გამოიყენონ საძიებო ინსტრუმენტები ან იმოქმედონ პროგრამებზე. ეს მოქმედების უნარი, ანუ „აგენტურობა“, LLM-ებისთვის გარე სამყაროსთან დამაკავშირებელ ხიდად გვევლინება. სტატია განმარტავს, თუ როგორ აკონტროლებს AI აგენტები LLM-ის შედეგების სამუშაო პროცესს და აღნიშნავს, რომ აგენტურობა არის უწყვეტი სპექტრი. მიუხედავად იმისა, რომ აგენტები სასარგებლოა აპლიკაციის სამუშაო პროცესის მოქნილობისთვის, ისინი

LLM-ების ინფერენციისას ნახშირბადის ემისიების კვლევა: მოულოდნელი აღმოჩენები საზოგადოების მიერ შექმნილ მოდელებში
ბოლო წლებში დიდი ენობრივი მოდელების (LLM) გამოყენების გარემოზე ზემოქმედებაზე ცნობიერება იზრდება. ეს სტატია იკვლევს LLM-ების ინფერენციის ფაზაში ნახშირბადის ემისიებს, წარმოადგენს Open LLM Leaderboard-ში ემისიის შეფასებების ინტეგრაციას და მოულოდნელ აღმოჩენებს, მაგალითად, რომ საზოგადოების მიერ მორგებული მოდელები (community fine-tunes) ხშირად უფრო ნახშირბადეფექტურია, ვიდრე ოფიციალური მოდელები. განხილულია ემისიების ცვლილებები სხვადასხვა მოდელის ტიპისა და ზომის მიხედვით, რაც მიზნად ისახავს მომხმარებლებ
დიდი ენობრივი მოდელები: ღია წყაროების რევოლუცია ტექსტის გენერაციაში
სტატია მიმოიხილავს ტექსტის გენერაციისა და კონვერსაციული AI ტექნოლოგიების განვითარებას, ადრეული გამოწვევებიდან უახლეს მიღწევებამდე. ხაზგასმულია მომხმარებლისთვის მოსახერხებელი ინტერფეისების, GPT-4-ის მსგავსი მძლავრი მოდელების და Llama 2-ის მსგავსი ღია წყაროების ალტერნატივების მნიშვნელობა. განმარტებულია მიზეზობრივი ენობრივი მოდელები (Causal Language Models) და Text-to-Text მოდელები, ასევე Fine-tuning-ისა და RLHF-ის როლი მათ გაუმჯობესებაში. აღწერილია წამყვანი ღია წყაროების LLM-ები, მათი უპირატესობებ
Hugging Face-ის TGI წარმოგიდგენთ ახალ Backends არქიტექტურას: გამარტივებული LLM-ების განთავსება და გაუმჯობესებული წარმადობა
Hugging Face-მა წარმოადგინა TGI Backends, ახალი არქიტექტურა Text-Generation-Inference (TGI)-ისთვის, რომელიც მიზნად ისახავს LLM-ების განთავსების პროცესის გამარტივებას და ოპტიმალური წარმადობის უზრუნველყოფას. ეს სიახლე აერთიანებს სხვადასხვა ინფერენსინგის გადაწყვეტებს ერთიან ფრონტენდ ფენაში, რაც მომხმარებლებს საშუალებას აძლევს მარტივად შეცვალონ ბეკენდები მათი მოდელირების, აპარატურის და წარმადობის მოთხოვნების შესაბამისად.
LLM-ების კონფიდენციალურობისა და ინტელექტუალური საკუთრების დაცვა: Zama-ს გადაწყვეტა ჰომომორფული დაშიფვრით
დიდი ენობრივი მოდელების (LLM) ფართო გამოყენების მიუხედავად, მომხმარებლის მონაცემთა კონფიდენციალურობის საკითხი კვლავ გადაუჭრელ პრობლემად რჩება, რადგან არსებობს სენსიტიური ინფორმაციის LLM სერვისის მიმწოდებელთან გაჟონვის რისკი. Zama გვთავაზობს ინოვაციურ გადაწყვეტას სრულად ჰომომორფული დაშიფვრის (FHE) გამოყენებით, რომელიც საშუალებას აძლევს LLM-ებს, იმუშაონ დაშიფრულ მონაცემებზე. ეს მეთოდი იცავს როგორც მომხმარებლის კონფიდენციალურობას, ასევე მოდელის ინტელექტუალურ საკუთრებას, პროგნოზების ხარისხის შენარჩუ
LLM-ების ინტეგრაცია Swift აპლიკაციებში Core ML-ის გამოყენებით: დეველოპერების სახელმძღვანელო
მანქანური სწავლება (ML) პროგრამული უზრუნველყოფის შექმნის ახალ გზებს ხსნის, განსაკუთრებით Swift დეველოპერებისთვის, რომლებსაც სურთ ხელოვნური ინტელექტის ფუნქციების ინტეგრირება თავიანთ აპლიკაციებში. ეს სტატია წარმოგიდგენთ Core ML-ზე დაფუძნებულ ინსტრუმენტებსა და დეტალურ სახელმძღვანელოს, თუ როგორ უნდა გაუშვათ დიდი ენობრივი მოდელები (LLM), როგორიცაა Llama 2, Mac-ზე. პროექტი მოუწოდებს დეველოპერებს, შეერთდნენ და წვლილი შეიტანონ ამ ინიციატივის ერთობლივ გაუმჯობესებაში, რათა დააჩქარონ ხელოვნური ინტელექტის შ
პირდაპირი უპირატესობის ოპტიმიზაცია (DPO) LLM-ების დახვეწას ამარტივებს
ეს სტატია წარმოგიდგენთ პირდაპირი უპირატესობის ოპტიმიზაციის (DPO) მეთოდს, რომელიც მნიშვნელოვნად ამარტივებს დიდი ენობრივი მოდელების (LLM) დახვეწის პროცესს. ტრადიციული გაძლიერებითი სწავლისგან ადამიანის უკუკავშირით (RLHF) განსხვავებით, DPO გამორიცხავს ჯილდოს მოდელის შექმნის კომპლექსურ საფეხურს და RL ოპტიმიზაციას, პირდაპირ ახდენს ენობრივი მოდელის ოპტიმიზაციას უპირატესობის მონაცემებზე, ბინარული კროს-ენტროპიის დანაკარგის გამოყენებით. ეს მიდგომა ვარჯიშს უფრო ეფექტურს და ნაკლებად პრობლემურს ხდის, რაც შეს

ფიზიკური ინტელექტის ინოვაცია: რობოტების გენერალისტი კონტროლის მოდელები π0 და π0-FAST
Physical Intelligence-მა წარმოადგინა π0 და π0-FAST, პროტოტიპული მოდელები და სასწავლო ფრეიმვორკები, რომლებიც შექმნილია რობოტების გენერალისტური კონტროლისთვის. ისინი მიზნად ისახავს ხიდის გადებას ხელოვნური ინტელექტის სისტემებსა და ფიზიკურ სამყაროს შორის არსებულ ხარვეზებს შორის, LLM-ებისა და VLM-ებისგან განსხვავებით, რომელთაც ფიზიკურ სამყაროსთან ურთიერთქმედება აკლიათ. π0, ხედვით-ენობრივ-მოქმედებითი (VLA) მოდელი, გაწვრთნილია 7 რობოტული პლატფორმისა და 68 უნიკალური ამოცანის მონაცემებზე, რაც მას საშუალებ
Hugging Face წარმოგიდგენთ SafeCoder-ს: უსაფრთხო, თვით-ჰოსტინგით AI პროგრამისტს საწარმოებისთვის
Hugging Face-ის SafeCoder მიზნად ისახავს პროგრამული უზრუნველყოფის შემუშავების პროდუქტიულობის გაზრდას საწარმოებში, სრულად შესაბამისი, თვით-ჰოსტინგითა და უსაფრთხო AI კოდის ასისტენტის შეთავაზებით. გადაწყვეტა ეფუძნება ღია კოდის მოდელებს, როგორიცაა StarCoder, და უზრუნველყოფს მონაცემთა კონფიდენციალურობასა და იურიდიულ შესაბამისობას, რადგან კომპანიებს საშუალებას აძლევს, საკუთარ ინფრასტრუქტურაზე დაახვეწონ LLM-ები, მესამე მხარესთან კოდის გაზიარების გარეშე.
Hugging Face-მა AutoGPTQ ინტეგრირება მოახდინა Transformers-ში: ხელმისაწვდომი დიდი ენობრივი მოდელები
Hugging Face-მა თავის Transformers ბიბლიოთეკაში AutoGPTQ-ის ინტეგრირებით, დიდი მანქანური სწავლის მოდელების ხელმისაწვდომობა მნიშვნელოვნად გაზარდა. ეს მომხმარებლებს საშუალებას აძლევს, მოდელების 8-დან 2-ბიტამდე სიზუსტით კვანტიზაცია და გაშვება შეძლონ GPTQ ალგორითმის გამოყენებით, მინიმალური სიზუსტის დაკარგვით და გაუმჯობესებული წარმადობით. ინტეგრაცია ხელმისაწვდომია როგორც Nvidia, ასევე RoCm-ზე მომუშავე AMD GPU-ებისთვის, რაც LLM-ების ოპტიმიზაციას უფრო ფართო აუდიტორიისთვის ხდის შესაძლებელს.
LLM-ების ეფექტური განლაგება: გამოთვლითი და მეხსიერების გამოწვევების გადაჭრა
დიდი ენობრივი მოდელები (LLM-ები) სწრაფად იკიდებენ ფეხს ცოდნაზე დაფუძნებულ ინდუსტრიებში, თუმცა მათი რეალურ სამყაროში განლაგება გამოწვევებითაა სავსე, განსაკუთრებით გამოთვლითი რესურსებისა და მეხსიერების კუთხით, ვრცელი შეტანის თანმიმდევრობებთან მუშაობისას. ეს პოსტი მიმოიხილავს ყველაზე ეფექტურ ტექნიკებს LLM-ების ოპტიმიზებული განლაგებისთვის, მათ შორის დაბალ სიზუსტეს (8-ბიტიანი და 4-ბიტიანი), Flash Attention-ს მეხსიერების ეფექტური გამოყენებისთვის და არქიტექტურულ ინოვაციებს, როგორიცაა Alibi, Rotary embe

ხელოვნური ინტელექტის აგენტების გაგება და გაუმჯობესება: ტრესინგი და შეფასება Arize Phoenix-ით
AI აგენტების შექმნა მხოლოდ დასაწყისია; მათი ქცევის გაგება და ოპტიმიზაცია გადამწყვეტია. ეს სტატია განმარტავს, თუ როგორ ეხმარება ტრესინგი და შეფასება აგენტების მუშაობის გაანალიზებაში, პრობლემების აღმოფხვრაში და ეფექტურობის უზრუნველყოფაში. Arize Phoenix წარმოადგენს ცენტრალიზებულ პლატფორმას ამ პროცესების რეალურ დროში განსახორციელებლად, OpenTelemetry-სა და OpenInference-თან ინტეგრაციით. განხილულია პრაქტიკული ნაბიჯები DuckDuckGo-ს საძიებო ხელსაწყოს მაგალითზე, სადაც LLM-ები, მაგალითად GPT-4o, გამოიყენე

როგორ შევქმნათ მობილური აპლიკაცია LLM მოდელებთან ლოკალური ჩეთისთვის React Native-ის გამოყენებით
ეს სახელმძღვანელო დეტალურად აღწერს, თუ როგორ უნდა შექმნათ მობილური აპლიკაცია React Native-ის გამოყენებით, რომელიც საშუალებას მოგცემთ ლოკალურად ესაუბროთ დიდ ენობრივ მოდელებს (LLM). ის გვიჩვენებს, როგორ გადმოწეროთ LLM-ები Hugging Face ჰაბიდან და გაუშვათ ისინი უშუალოდ თქვენს მოწყობილობაზე, llama.rn-ის მეშვეობით GGUF ფაილების ეფექტურად ჩატვირთვით. სტატია მოიცავს გარემოს მომზადებას, მოდელების შერჩევას, პროექტის დაყენებას და აპლიკაციის თავდაპირველ კოდირებას, უზრუნველყოფს რა კონფიდენციალურობასა და მარტ
მობილური AI ჩატბოტი: LLM-ების ლოკალურად გაშვება React Native-ით
ეს დეტალური გზამკვლევი აღწერს, თუ როგორ შევქმნათ React Native მობილური აპლიკაცია, რომელიც მომხმარებლებს საშუალებას აძლევს, პირადულ გარემოში, ლოკალურად ესაუბრონ ხელოვნური ინტელექტის დიდ ენობრივ მოდელებს (LLM). სტატია მოიცავს მოდელების შერჩევის კრიტერიუმებს, განვითარების გარემოს კონფიგურაციასა და აპლიკაციის საწყის ეტაპებს, `llama.rn`-ის ეფექტური გამოყენებით GGUF ფაილების ჩასატვირთად Hugging Face Hub-იდან.
როგორ განათავსოთ AI Comic Factory თქვენს პირად სივრცეში და თავიდან აიცილოთ ლოდინი
AI Comic Factory, აპლიკაცია, რომელმაც ათასობით მომხმარებელი მოიზიდა საკუთარი AI კომიქსების შესაქმნელად, წარმოუდგენლად პოპულარული გახდა. ეს გაკვეთილი გიჩვენებთ, თუ როგორ უნდა მოახდინოთ მისი კლონირება (fork) და კონფიგურაცია, რათა თავიდან აიცილოთ ხანგრძლივი ლოდინის დრო და განათავსოთ აპლიკაცია თქვენს პირად Hugging Face სივრცეში Inference API-ის გამოყენებით. მართალია, არ არის საჭირო ძლიერი ტექნიკური უნარები, მაგრამ რეკომენდებულია API-ების, გარემოს ცვლადების (environment variables) და LLM-ებისა და Sta