Hugging Face-ი აფართოებს Deep Reinforcement Learning-ის ეკოსისტემას Unity ML-Agents-ით: ახალი თამაში და საზოგადოება
Hugging Face-ი, Unity ML-Agents-ის გამოყენებით, ღრმა გაძლიერებითი სწავლების მკვლევრებისა და ენთუზიასტებისთვის ეკოსისტემას აფართოებს. ამ ინიციატივის ფარგლებში წარმოდგენილია თამაში „Snowball Fight“ და ახალი Discord სერვერი საზოგადოების ჩართულობისთვის.
OpenAI-ის RLHF შედეგების რეპროდუცირება: ტექნიკური დეტალების სიღრმისეული ანალიზი
მოცემული ნაშრომი მიზნად ისახავს OpenAI-ის (OAI) სტილისტური ამოცანების (როგორიცაა სენტიმენტი და აღწერილობითობა) RLHF (Reinforcement Learning from Human Feedback) შედეგების რეპროდუცირებას. ჩვენი კოდების ბაზა OAI-ის კოდების ბაზის თითქმის იდენტურ სწავლის მრუდებს აჩვენებს. სტატია დეტალურად განიხილავს იმპლემენტაციის ტექნიკურ ნიუანსებს, მათ შორის, როგორ გენერირდება ჯილდოები/მნიშვნელობები და პასუხები, შევსების (padding) მექანიზმებს, ლოგიტების გამოთვლას და პასუხების გენერაციის დროს შერჩევის პროცესს. ასევ
Hugging Face-ის ბიბლიოთეკა Decision Transformer-ს აერთიანებს: ახალი ეტაპი ღრმა გაძლიერებულ სწავლაში
Hugging Face-მა სიხარულით განაცხადა, რომ Decision Transformer, ოფლაინ გაძლიერებული სწავლის (Offline Reinforcement Learning) მეთოდი, ინტეგრირებულია მათ 🤗 ტრანსფორმერების ბიბლიოთეკაში და Hugging Face ჰაბში. ეს ნაბიჯი ღრმა გაძლიერებული სწავლის (Deep RL) სფეროში ხელმისაწვდომობის გაუმჯობესების გეგმის ნაწილია. სტატია განმარტავს RL-ის საფუძვლებს, განასხვავებს ონლაინ და ოფლაინ გაძლიერებულ სწავლებას და დეტალურად აღწერს Decision Transformer-ის მოდელს, რომელიც წარმოადგენს პარადიგმის ცვლილებას, რადგან ტრადი
Hugging Face-ი Decision Transformer-ს აინტეგრირებს: ახალი მიდგომა გაძლიერებით სწავლებაში
Hugging Face-მა Decision Transformer, ოფლაინ გაძლიერებითი სწავლის (Offline Reinforcement Learning) მეთოდი, თავის 🤗 transformers ბიბლიოთეკასა და Hugging Face Hub-ში ინტეგრირება მოახდინა. ეს ინტეგრაცია მნიშვნელოვან ნაბიჯს წარმოადგენს Deep Reinforcement Learning-ის (Deep RL) სფეროში ხელმისაწვდომობის გასაუმჯობესებლად. Decision Transformer წარმოადგენს პარადიგმის ცვლას, სადაც ტრადიციული RL მეთოდების ნაცვლად გამოიყენება მიმდევრობის მოდელირების ალგორითმი სასურველი შედეგის მისაღწევად მომავალი მოქმედებები
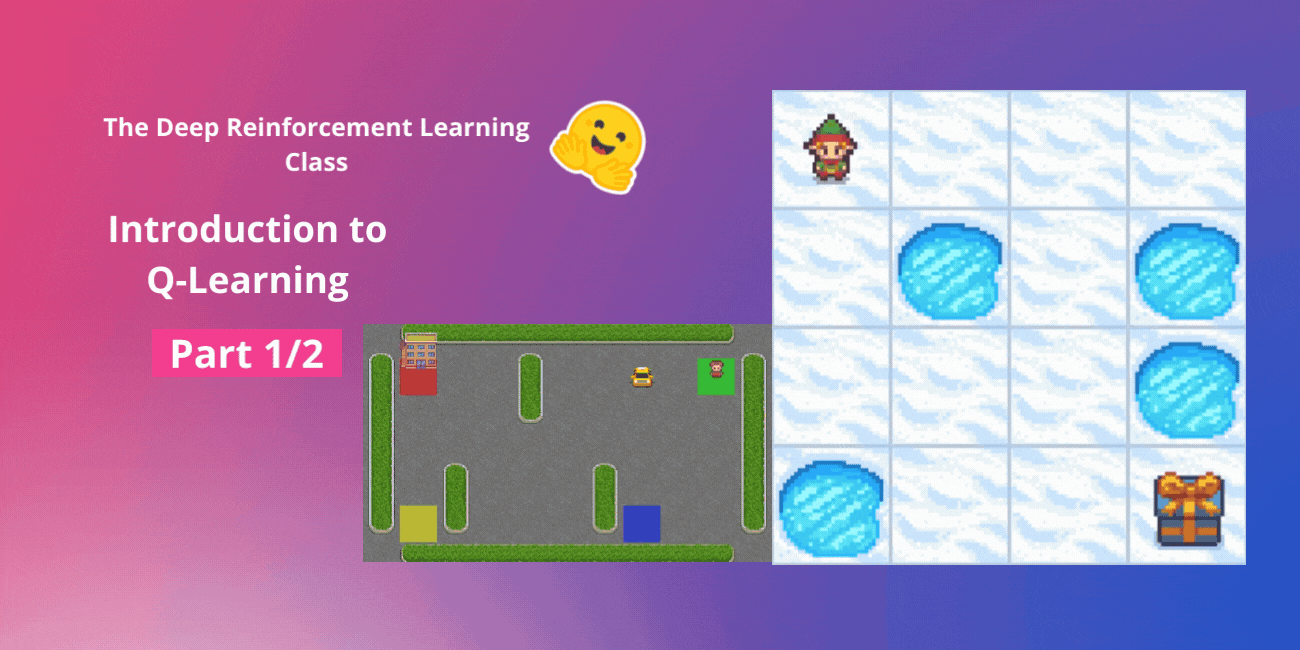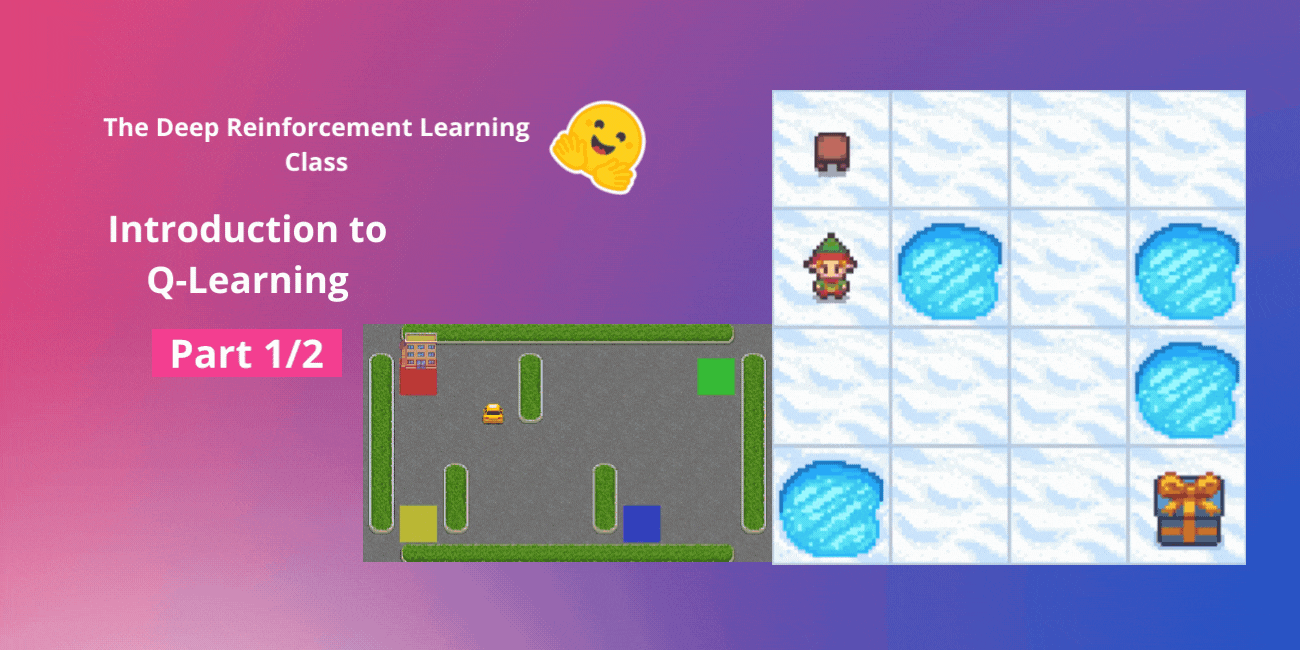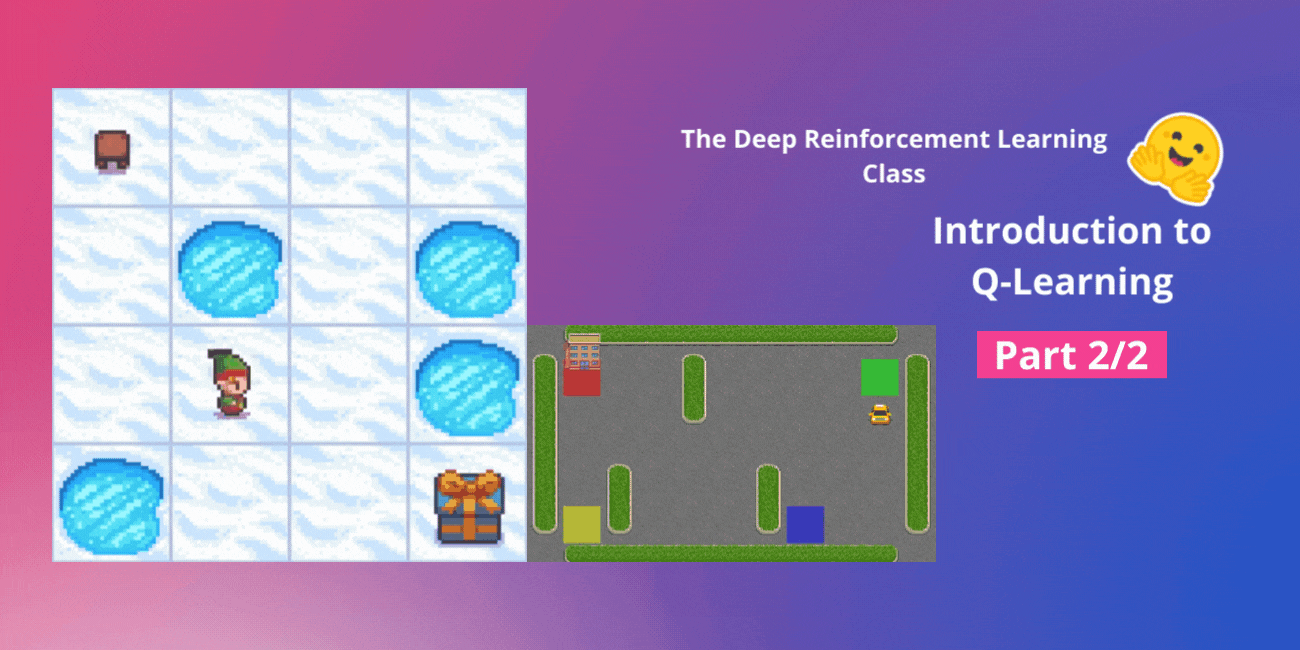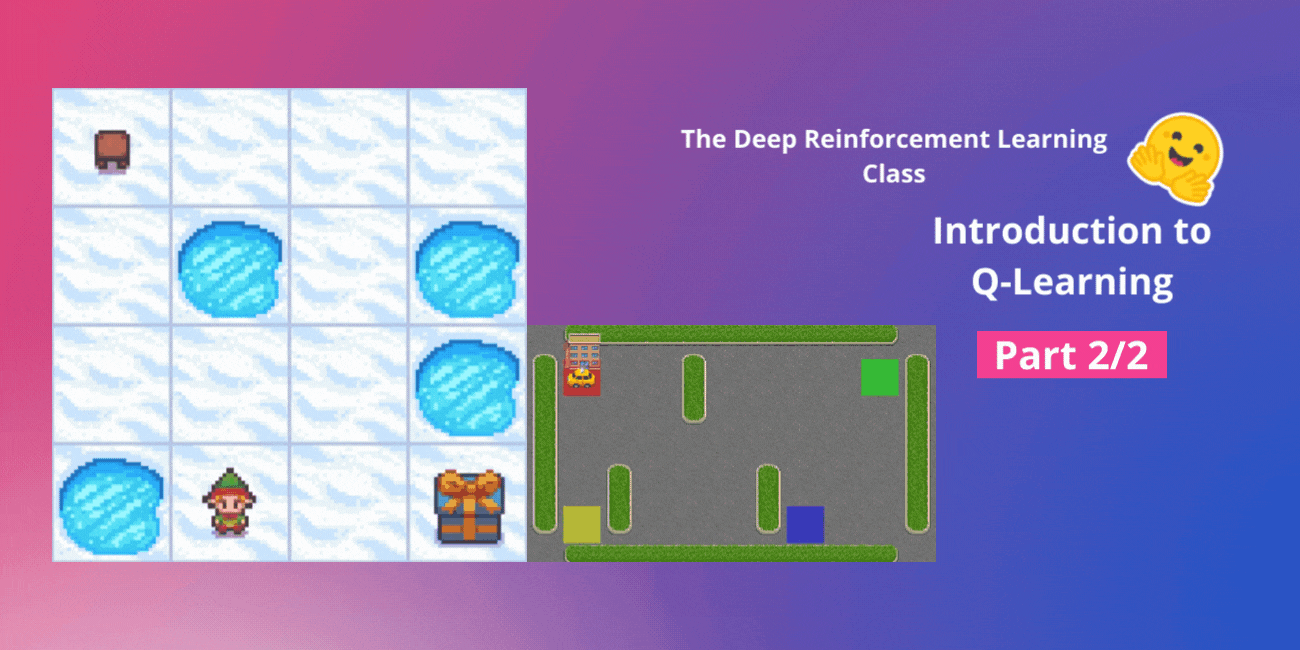
ღრმა გაძლიერებითი სწავლის კურსი: ღირებულებაზე დაფუძნებული მეთოდები და Q-სწავლება
ეს სტატია ღრმა გაძლიერებითი სწავლის (Deep Reinforcement Learning) კურსის ნაწილია, რომელიც დამწყებიდან ექსპერტამდე დონისთვის არის განკუთვნილი. ის დეტალურად განიხილავს ღირებულებაზე დაფუძნებულ მეთოდებსა და Q-სწავლებას, განმარტავს, თუ როგორ იღებენ RL აგენტები ჭკვიან გადაწყვეტილებებს გარემოსთან ცდისა და შეცდომის გზით ურთიერთქმედებით და ჯილდოების მაქსიმიზაციით. სტატია ასევე ეხება მდგომარეობისა და მოქმედების ღირებულების ფუნქციებს შორის განსხვავებას, პოლიტიკისა და ღირებულების ფუნქციის წვრთნის ნიუანსებს,
ღრმა გაძლიერებითი სწავლება: პოლიტიკაზე დაფუძნებული მეთოდები და Reinforce
სტატია მიმოიხილავს პოლიტიკაზე დაფუძნებულ მეთოდებს ღრმა გაძლიერებით სწავლებაში, უპირისპირებს რა მათ ღირებულებაზე დაფუძნებულ მიდგომებს. განმარტებულია, რომ პოლიტიკაზე დაფუძნებული მეთოდები უშუალოდ ოპტიმიზაციას უკეთებენ პოლიტიკას შუალედური ღირებულების ფუნქციის გარეშე, კონკრეტულად კი ალგორითმ Reinforce-ის მაგალითზე. ხაზგასმულია ძირითადი უპირატესობები, როგორიცაა ინტეგრაციის სიმარტივე, სტოქასტური პოლიტიკის სწავლის უნარი და ისეთი პრობლემების გადაჭრა, როგორიცაა აღქმითი ალიასინგი, ასევე უწყვეტი მოქმედებები
აქტორ-კრიტიკოსის მეთოდები ღრმა განმტკიცებით სწავლაში
სტატია განიხილავს აქტორ-კრიტიკოსის მეთოდებს, ჰიბრიდულ მიდგომას ღრმა განმტკიცებით სწავლაში, რომელიც აერთიანებს პოლიტიკაზე დაფუძნებულ და ღირებულებაზე დაფუძნებულ მეთოდებს. ეს მიდგომა მიზნად ისახავს ისეთი პოლიტიკის გრადიენტული ალგორითმების, როგორიცაა Reinforce, მაღალი დისპერსიის პრობლემის გადაჭრას, რაც ხელს უწყობს სწავლის სტაბილიზაციასა და დაჩქარებას. სტატია მოიცავს Advantage Actor Critic (A2C) მეთოდს და მის გამოყენებას რობოტულ გარემოში Stable-Baselines3-ის მეშვეობით.
RLOO ტრენერი TRL-ში: RLHF სწავლების გამარტივებული მიდგომა
RLOO (REINFORCE Leave One-Out) არის ახალი ონლაინ RLHF ვარჯიშის ალგორითმი TRL-ში, რომელიც შექმნილია PPO-ს ალტერნატივად. ის გამოირჩევა უფრო მარტივი იმპლემენტაციით, GPU მეხსიერების ნაკლები მოთხოვნილებით და უფრო სწრაფი კონვერგენციით. RLOO ამარტივებს გაძლიერებითი სწავლების ონლაინ მეთოდების კვლევას RLHF კონტექსტში, რაც მას მიმზიდველ გადაწყვეტად აქცევს მაღალი ხარისხის მოდელების ეფექტურად ვარჯიშისთვის.