BigBird: ტრანსფორმატორების ახალი ეფექტური მიდგომა გრძელი თანმიმდევრობებისთვის
ტრანსფორმატორული მოდელები ფართოდ გამოიყენება NLP ამოცანებში, თუმცა მათი O(n^2) დროითი და მეხსიერების სირთულე ზღუდავს მათ გამოყენებას გრძელ თანმიმდევრობებზე (n > 512). BigBird, ახალი მოდელი, ამ პრობლემას ბლოკ-სპარსული ყურადღების (block sparse attention) გამოყენებით აგვარებს, რაც საშუალებას აძლევს მას დაამუშაოს თანმიმდევრობები 4096 სიგრძემდე, მნიშვნელოვნად დაბალი გამოთვლითი დანახარჯით, ვიდრე BERT. BigBird-მა მიაღწია საუკეთესო შედეგებს (SOTA) გრძელ დოკუმენტებთან დაკავშირებულ ამოცანებში, როგორიცაა შ
ტრანსფორმატორული მოდელები ძალიან სასარგებლო აღმოჩნდა NLP-ის (ბუნებრივი ენის დამუშავების) მრავალი ამოცანისთვის. თუმცა, ტრანსფორმატორული მოდელების ერთ-ერთი მთავარი შეზღუდვა არის მათი O(n^2) დროითი და მეხსიერების სირთულე (სადაც n არის თანმიმდევრობის სიგრძე). აქედან გამომდინარე, გამოთვლითად ძალიან ძვირია ტრანსფორმატორული მოდელების გამოყენება გრძელ თანმიმდევრობებზე (n > 512). რამდენიმე ბოლოდროინდელი ნაშრომი, მაგალითად, Longformer, Performer, Reformer, Clustered attention, ცდილობს ამ პრობლემის გამოსწორებას სრული ყურადღების მატრიცის აპროქსიმაციით. თუ არ იცნობთ ამ მოდელებს, შეგიძლიათ იხილოთ 🤗-ის ბოლოდროინდელი ბლოგ-პოსტი. BigBird (წარმოდგენილი ნაშრომში) არის ერთ-ერთი ასეთი ბოლოდროინდელი მოდელი ამ საკითხის გადასაჭრელად. BigBird ეყრდნობა ბლოკ-სპარსულ ყურადღებას (block sparse attention) ნორმალური ყურადღების ნაცვლად (ანუ BERT-ის ყურადღება) და შეუძლია გაუმკლავდეს თანმიმდევრობებს 4096 სიგრძემდე, BERT-თან შედარებით ბევრად დაბალი გამოთვლითი ღირებულებით. მან მიაღწია SOTA (თანამედროვე ხელოვნების დონეს) სხვადასხვა ამოცანებში, რომლებიც მოიცავს ძალიან გრძელ თანმიმდევრობებს, როგორიცაა გრძელი დოკუმენტების შეჯამება, კითხვა-პასუხი გრძელი კონტექსტებით. BigBird RoBERTa-ს მსგავსი მოდელი ახლა ხელმისაწვდომია 🤗Transformers-ში. ამ პოსტის მიზანია მკითხველს მისცეს BigBird-ის იმპლემენტაციის სიღრმისეული გაგება და გაუადვილოს მისი გამოყენება 🤗Transformers-თან ერთად. მაგრამ, სანამ უფრო ღრმად ჩავუღრმავდებით, მნიშვნელოვანია გვახსოვდეს, რომ BigBird-ის ყურადღება არის BERT-ის სრული ყურადღების აპროქსიმაცია და, შესაბამისად, ის არ ცდილობს იყოს უკეთესი ვიდრე BERT-ის სრული ყურადღება, არამედ იყოს უფრო ეფექტური. ის უბრალოდ საშუალებას აძლევს ტრანსფორმატორულ მოდელებს გამოიყენონ ბევრად უფრო გრძელ თანმიმდევრობებზე, რადგან BERT-ის კვადრატული მეხსიერების მოთხოვნა სწრაფად ხდება აუტანელი. მარტივად რომ ვთქვათ, თუ გვექნებოდა უსასრულო გამოთვლითი რესურსი და უსასრულო დრო, BERT-ის ყურადღება უფრო სასურველი იქნებოდა ვიდრე ბლოკ-სპარსული ყურადღება (რომელზეც ამ პოსტში ვისაუბრებთ). თუ გაინტერესებთ, რატომ გვჭირდება მეტი გამოთვლითი რესურსი გრძელ თანმიმდევრობებთან მუშაობისას, ეს ბლოგ-პოსტი სწორედ თქვენთვისაა! ზოგიერთი ძირითადი კითხვა, რომელიც შეიძლება გაჩნდეს სტანდარტულ BERT-ის მსგავს ყურადღებასთან მუშაობისას, მოიცავს: ამ ბლოგ-პოსტში, ჩვენ ვეცდებით ვუპასუხოთ ამ კითხვებს. ჩვენ მოვიყვანთ პრაქტიკულ მაგალითს, თუ როგორ მუშაობს ყურადღება წინადადების გათვალისწინებით: „BigBird is now available in HuggingFace for extractive question answering“.
BERT-ის მსგავს ყურადღებაში, ყოველი სიტყვა უბრალოდ მიაქცევდა ყურადღებას ყველა სხვა ტოკენს. მათემატიკურად რომ ვთქვათ, ეს ნიშნავს, რომ ყოველი მოთხოვნის ტოკენი (query-token ∈ {BigBird, is, now, available, in, HuggingFace, for, extractive, question, answering}) მიაქცევდა ყურადღებას საკვანძო ტოკენების სრულ სიას (key-tokens = [BigBird, is, now, available, in, HuggingFace, for, extractive, question, answering]). მოდით ვიფიქროთ საკვანძო ტოკენების გონივრულ არჩევანზე, რომელზეც საძიებო ტოკენმა რეალურად მხოლოდ უნდა მიაქციოს ყურადღება, ფსევდო-კოდის დაწერით.
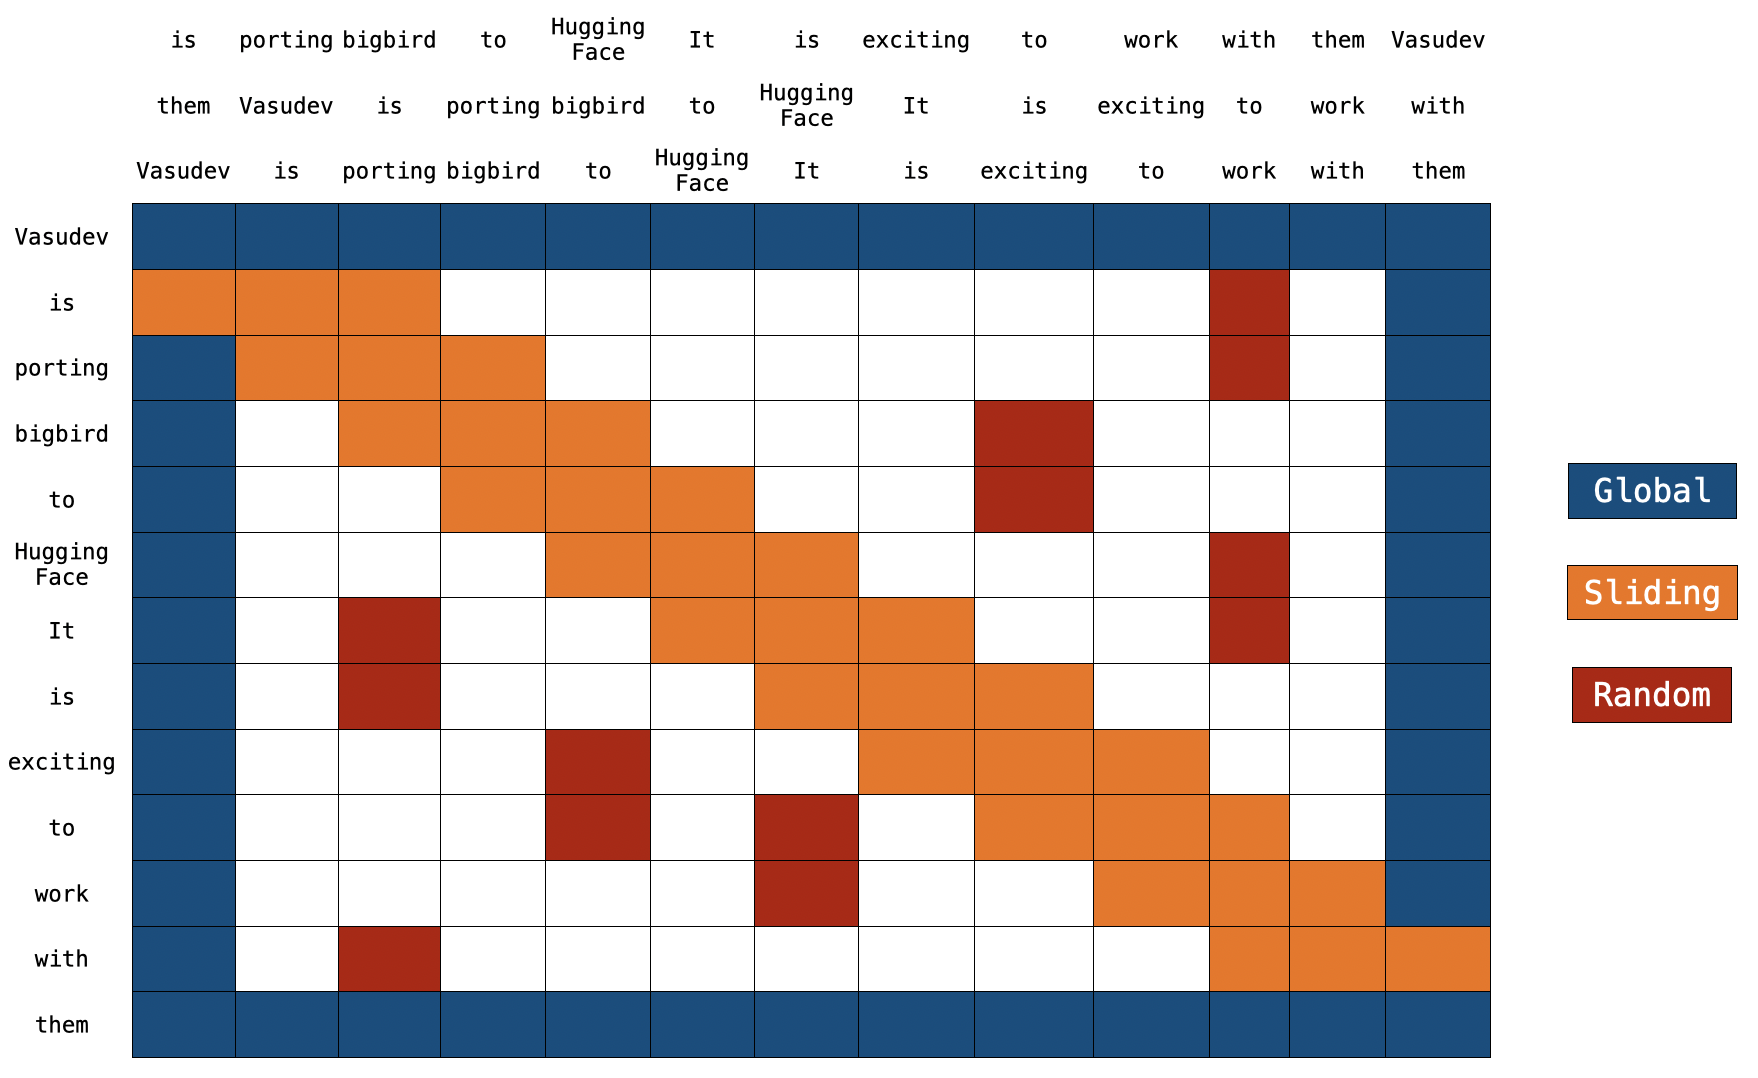
ჩვენ ვივარაუდებთ, რომ ტოკენი „available“ არის საძიებო და შევქმნით საკვანძო ტოკენების გონივრულ სიას, რომლებზეც ყურადღება უნდა გამახვილდეს. ახლომდებარე ტოკენები მნიშვნელოვანი უნდა იყოს, რადგან წინადადებაში (სიტყვათა თანმიმდევრობაში) მიმდინარე სიტყვა დიდად არის დამოკიდებული მეზობელ წარსულსა და მომავალ ტოკენებზე. ეს ინტუიცია დგას მოძრავი ყურადღების (sliding attention) კონცეფციის უკან. შორეული დამოკიდებულებები: ზოგიერთი ამოცანისთვის გადამწყვეტია ტოკენებს შორის შორეული ურთიერთობების დაჭერა. მაგალითად, კითხვა-პასუხში, მოდელმა უნდა შეადაროს კონტექსტის ყოველი ტოკენი მთელ კითხვას, რათა გაარკვიოს, კონტექსტის რომელი ნაწილია სასარგებლო სწორი პასუხისთვის. თუ კონტექსტის ტოკენების უმეტესობა მხოლოდ სხვა კონტექსტის ტოკენებს მიაქცევს ყურადღებას და არა კითხვას, მოდელისთვის გაცილებით რთული ხდება მნიშვნელოვანი კონტექსტის ტოკენების გაფილტვრა ნაკლებად მნიშვნელოვანისგან. BigBird გთავაზობთ ორ გზას, რათა დაუშვას გრძელვადიანი ყურადღების დამოკიდებულებები გამოთვლითად ეფექტურობის შენარჩუნებისას. ამ გზით, საძიებო ტოკენი ყურადღებას აქცევს მხოლოდ ყველა შესაძლო ტოკენის ქვესიმრავლეს, სრული ყურადღების კარგ აპროქსიმაციასთან ერთად. იგივე მიდგომა გამოიყენება ყველა სხვა საძიებო ტოკენისთვის. მაგრამ გახსოვდეთ, აქ მთელი აზრი არის BERT-ის სრული ყურადღების მაქსიმალურად ეფექტურად აპროქსიმაცია. უბრალოდ, ყოველი მოთხოვნის ტოკენის მიერ ყველა საკვანძო ტოკენისთვის ყურადღების მიქცევა, როგორც ეს BERT-ისთვის კეთდება, ძალიან ეფექტურად შეიძლება გამოითვალოს როგორც მატრიცული გამრავლებების თანმიმდევრობა თანამედროვე აპარატურაზე, როგორიცაა GPU. თუმცა, მოძრავი, გლობალური და შემთხვევითი ყურადღების კომბინაცია, როგორც ჩანს, გულისხმობს სპარსულ მატრიცულ გამრავლებას, რაც უფრო რთული განსახორციელებელია ეფექტურად თანამედროვე აპარატურაზე.
BigBird-ის ერთ-ერთი მთავარი წვლილი არის ბლოკ-სპარსული ყურადღების მექანიზმის შეთავაზება, რომელიც საშუალებას იძლევა ეფექტურად გამოითვალოს მოძრავი, გლობალური და შემთხვევითი ყურადღება. მოდით, ჩავუღრმავდეთ მას! პირველ რიგში, უკეთ გავიგოთ...
თეგები:
#ხელოვნური ინტელექტი
#მანქანური სწავლება
#ეფექტურობა
#nlp
#ტრანსფორმატორები
#huggingface
#ყურადღების მექანიზმი
#bigbird
#გრძელი თანმიმდევრობები
წყარო: huggingface.co
AI-ით გადამუშავებული


