
ექსპერტთა ნარევი (MoE) მოდელები – LLM-ების მასშტაბირების ახალი მიდგომა
სტატია განიხილავს დიდი ენობრივი მოდელების (LLM) ევოლუციას, რომელიც მჭიდრო მასშტაბირებიდან (მეტი მონაცემი + მეტი პარამეტრი) ექსპერტთა ნარევის (Mixture of Experts - MoE) მოდელებზე გადადის. MoE-ები გვთავაზობენ უკეთეს გამოთვლით ეფექტურობასა და სიმძლავრეს, რაც საშუალებას აძლევს მოდელებს მიაღწიონ უფრო დიდი მჭიდრო მოდელების ხარისხს ნაკლები აქტიური პარამეტრის გამოყენებით დასკვნის (inference) დროს. ხაზგასმულია MoE-ების უპირატესობები, როგორიცაა პარალელიზაცია და ინდუსტრიული მიღება, ასევე დეტალურად არის აღწ

როგორ დავაჩქაროთ თქვენი Fire TV ან Fire TV Stick: ZDNET-ის რჩევები
ZDNET განმარტავს თავისი რეკომენდაციების გამჭვირვალობასა და დამოუკიდებლობას, ხაზს უსვამს მკითხველის ინტერესების დაცვას სარეკლამო გავლენის გარეშე. სტატია დეტალურად აღწერს, თუ როგორ უნდა გაუმჯობესდეს Fire TV ან Fire TV Stick-ის მუშაობა. მოცემულია პრაქტიკული ნაბიჯები, როგორიცაა მოწყობილობის გადატვირთვა, პროგრამული უზრუნველყოფის განახლება, გამოუყენებელი აპლიკაციების წაშლა და ქეშის გასუფთავება, რაც მოწყობილობის სიჩქარესა და ეფექტურობას მნიშვნელოვნად ზრდის.

NVIDIA Cosmos Reasoning 2B მოდელის განთავსება Jetson მოწყობილობებზე vLLM-ის გამოყენებით
ხელოვნური ინტელექტის მოდელების სწრაფმა ევოლუციამ, რაც ზრდის მათ სიზუსტესა და ეფექტურობას, ისინი იდეალურს ხდის პერიფერიული მოწყობილობებისთვის. NVIDIA Jetson-ის ოჯახი, მაღალპროდუქტიული AGX Thor-დან და AGX Orin-დან დაწყებული კომპაქტური Orin Nano Super-ით დამთავრებული, შექმნილია ფიზიკური ხელოვნური ინტელექტისა და რობოტიკისთვის განკუთვნილი აპლიკაციების დასაჩქარებლად, რაც უზრუნველყოფს ოპტიმიზებულ შესრულებას ღია კოდის წამყვანი მოდელებისთვის. ეს სახელმძღვანელო დეტალურად აღწერს, თუ როგორ უნდა განათავსოთ N

Google Cloud-ის ვიცე-პრეზიდენტი ხელოვნური ინტელექტის მოდელების სამ საზღვარზე
მაიკლ გერსტენჰაბერი, Google Cloud-ის პროდუქტის ვიცე-პრეზიდენტი, რომელიც მუშაობს Vertex AI-ზე, გვთავაზობს შეხედულებებს, თუ როგორ იყენებენ კომპანიები ხელოვნურ ინტელექტს და რა არის საჭირო აგენტური AI-ს პოტენციალის სრულად გასახსნელად. მისი თქმით, AI მოდელები სამ ძირითად ზღვარს უბიძგებენ: ნედლი ინტელექტი, რეაგირების დრო და ღირებულება-ეფექტურობა მასშტაბური განლაგებისთვის. გერსტენჰაბერი ხაზს უსვამს Google-ის უნიკალურ ვერტიკალურ ინტეგრაციას, როგორც სიძლიერეს, და განიხილავს აგენტური AI სისტემების დანერგვ

გაზარდეთ პროდუქტიულობა: Windows-ის კლავიატურის მალსახმობების სრული გზამკვლევი
ZDNET-ის მიერ ჩატარებული მრავალსაათიანი ტესტირებისა და კვლევის საფუძველზე, ეს სტატია განმარტავს Windows-ის კლავიატურის მალსახმობების მნიშვნელობას და ეფექტურობას. ის გვიჩვენებს, თუ როგორ შეუძლიათ ამ მალსახმობებს მნიშვნელოვნად გაზარდონ პროდუქტიულობა, გააუმჯობესონ წვდომა, გაამარტივონ ნავიგაცია და დოკუმენტების მართვა. სტატია გთავაზობთ 50-ზე მეტი სასარგებლო მალსახმობის ჩამონათვალს, რაც მომხმარებლებს ჭკვიანური მუშაობის საშუალებას მისცემს.

Google-ის Gemini 3.1 Pro: ხელოვნური ინტელექტის რბოლა ინტენსიურდება
Google-მა წარმოადგინა Gemini 3.1 Pro, ხელოვნური ინტელექტის ახალი მოდელი, რომელიც ორიენტირებულია კომპლექსურ, მრავალსაფეხურიან ამოცანებზე, როგორიცაა მსჯელობა, კოდირება და კვლევა, რითაც ის დიფერენცირდება ჩვეულებრივი ჩეთბოტებისგან. ეს გაშვება Google-ის AI სტრატეგიის ნაწილია, რომელიც მიზნად ისახავს ხელოვნური ინტელექტის ინტეგრირებას ძირითად ინფრასტრუქტურასა და სერვისებში (Workspace, Cloud). სტატიაში განიხილება მოდელის რეალური გამოყენების ეფექტურობა, მზარდი კონკურენცია (OpenAI, Anthropic) და მაღალი რის

ZDNET-ის მიმოხილვა: Amazfit T-Rex Ultra 2 – სრულყოფილი ჭკვიანი საათი ექსტრემალური თავგადასავლებისთვის
ZDNET განმარტავს თავის სარედაქციო მიდგომას, რომელიც ეფუძნება საფუძვლიან ტესტირებასა და კვლევას, რათა მკითხველს მიაწოდოს ზუსტი რეკომენდაციები ტექნიკის შესახებ. ამ კონტექსტში, სტატია წარმოგიდგენთ Amazfit T-Rex Ultra 2 ჭკვიანი საათის დეტალურ მიმოხილვას. მოწყობილობა გამოირჩევა გამძლეობით, მრავალფუნქციურობითა და გარე აქტივობებისთვის იდეალური მახასიათებლებით, როგორიცაა საფირონის ეკრანი, ტიტანის კორპუსი, 10 ATM წყალგამძლეობა და ინტეგრირებული LED ფანარი. მიმოხილვა აღწერს მის ეფექტურობას თოვლში, წვიმაში

ZDNET-ის რეკომენდაციები და Casely Power Pod – MagSafe დამტენი, რომელიც სტილსა და ფუნქციურობას აერთიანებს
ZDNET-ი მკითხველს სთავაზობს საფუძვლიან, ტესტირებასა და კვლევაზე დაფუძნებულ რეკომენდაციებს ტექნიკის შესახებ, რედაქტორთა დამოუკიდებლობის მკაცრი პრინციპების დაცვით. ამ კონტექსტში, სტატია მიმოიხილავს Casely Power Pod-ს, MagSafe დამტენ მოწყობილობას, რომელიც გამოირჩევა თავისი ერგონომიული დიზაინით, 50-ზე მეტი ფერისა და პრინტის ვარიანტით, 5,000 mAh სიმძლავრითა და მრავალფუნქციური დატენვის შესაძლებლობებით (MagSafe, Qi, USB-C). ის იდეალურია მათთვის, ვისაც სურს როგორც სტილი, ასევე ეფექტურობა.
MyLovely AI: ხელოვნური ინტელექტი ვიდეოების შექმნისთვის შეზღუდვების გარეშე
MyLovely AI წარმოგიდგენთ რევოლუციურ პლატფორმას, რომელიც მომხმარებლებს საშუალებას აძლევს, შექმნან მაღალი ხარისხის ვიდეოები ხელოვნური ინტელექტის მეშვეობით, სხვა AI სისტემებისთვის დამახასიათებელი ცენზურისა და შეზღუდვების გარეშე. სტატია დეტალურად აღწერს პლატფორმის გამოყენების პროცესს – მოთხოვნების (prompts) შედგენიდან ვიდეოს გენერირებამდე, ხაზს უსვამს დეტალური აღწერის მნიშვნელობას და იტერაციული მიდგომის ეფექტურობას სასურველი შედეგის მისაღებად. ასევე მოცემულია რჩევები ეფექტური მოთხოვნების შესაქმნელად

როგორ მივიღოთ საუკეთესო გამოსახულება და მუშაობის ეფექტურობა TCL ტელევიზორიდან: აუცილებელი პარამეტრები, რომლებიც უნდა შეცვალოთ
TCL ტელევიზორები ბაზარზე ფასისა და ხარისხის საუკეთესო შეფარდებით გამოირჩევა, თუმცა მათი ნაგულისხმევი პარამეტრები ხშირად არ იძლევა გამოსახულების საუკეთესო ხარისხს, ოპტიმალურ მუშაობას ან კონფიდენციალურობის სათანადო დაცვას. ეს გზამკვლევი გიჩვენებთ, თუ როგორ მარტივად შეცვალოთ ძირითადი პარამეტრები, რათა მნიშვნელოვნად გააუმჯობესოთ თქვენი ტელევიზორის ყურების გამოცდილება სახლში.
SQL მოთხოვნების მხარდაჭერა DuckDB-ით ჰაბზე არსებული მონაცემთა ნაკრებებისთვის
ჰაბზე დაემატა ახალი ფუნქცია, რომელიც მომხმარებლებს საშუალებას აძლევს, გაუშვან SQL მოთხოვნები DuckDB-ის გამოყენებით ნებისმიერ მონაცემთა ნაკრებზე. ეს ინტეგრაცია აუმჯობესებს დიდ მონაცემთა ნაკრებებთან მუშაობის ეფექტურობას Parquet ფაილების ფორმატის და დისტანციური წვდომის შესაძლებლობების მეშვეობით, რაც ხელს უწყობს ღია წვდომას და ანალიზს, განსაკუთრებით დიდი ენობრივი მოდელების (LLM) ეპოქაში.
ტრანსფორმერები დროითი სერიების პროგნოზირებაში: Autoformer-ის ინოვაცია და ეფექტურობის დადასტურება
ამ პოსტში განხილულია Transformer მოდელების ეფექტურობა დროითი სერიების პროგნოზირებისთვის. წარმოდგენილია Informer მოდელი, რომელმაც 2021 წლის AAAI-ის საუკეთესო ნაშრომის ჯილდო მოიპოვა. მიუხედავად იმისა, რომ ზოგიერთი კვლევა, მათ შორის DLinear-ის, ეჭვქვეშ აყენებს მათ ეფექტურობას, ემპირიული მონაცემები ადასტურებს, რომ ტრანსფორმერები, განსაკუთრებით Autoformer მოდელი, საგრძნობლად აჭარბებენ მარტივ ხაზოვან მოდელებს. სტატია დეტალურად განიხილავს Autoformer-ის საკვანძო ინოვაციებს: დაშლის ფენას (Decomposition L
Bamba-9B: ახალი ჰიბრიდული Mamba2 მოდელი გაუმჯობესებული ეფექტურობით და ღია წყაროს ხელმისაწვდომობით
წარმოგიდგენთ Bamba-9B-ს, დასკვნის ეფექტურობაზე ორიენტირებულ ჰიბრიდულ Mamba2 მოდელს, რომელიც შემუშავებულია IBM-ის, პრინსტონის, CMU-სა და UIUC-ის მიერ, სრულად ღია მონაცემებზე. მოდელი უზრუნველყოფს 2.5-ჯერ გამტარუნარიანობის გაუმჯობესებას და 2-ჯერ შეყოვნების შემცირებას სტანდარტულ ტრანსფორმერებთან შედარებით და დაუყოვნებლივ ხელმისაწვდომია საზოგადოებისთვის ექსპერიმენტებისთვის სხვადასხვა პოპულარულ ბიბლიოთეკაში. მისი მიზანია KV-ქეშის შეზღუდვების დაძლევა და Mamba არქიტექტურების ფართოდ დანერგვა.

SmolVLM-256M და SmolVLM-500M: მსოფლიოს ყველაზე პატარა ხედვის ენის მოდელები
კომპანიამ SmolVLM ოჯახის ორი ახალი წევრი, SmolVLM-256M და SmolVLM-500M, წარადგინა. 256 მილიონი პარამეტრის მქონე მოდელი მსოფლიოში ყველაზე პატარა ხედვის ენის მოდელია. ახალი მოდელები ეფუძნება SmolVLM 2B-დან მიღებულ გამოცდილებას, აქცენტი კეთდება ეფექტურობაზე, მონაცემთა ნარევებზე და დიზაინის ახალ კომპრომისებზე. ისინი ინარჩუნებენ მძლავრ მულტიმოდალურ მუშაობას გაცილებით მცირე ზომებში და მარტივად ინტეგრირდება არსებულ სისტემებში. ეს მოდელები განკუთვნილია როგორც შეზღუდული მოწყობილობებისთვის, ასევე დიდი მოც
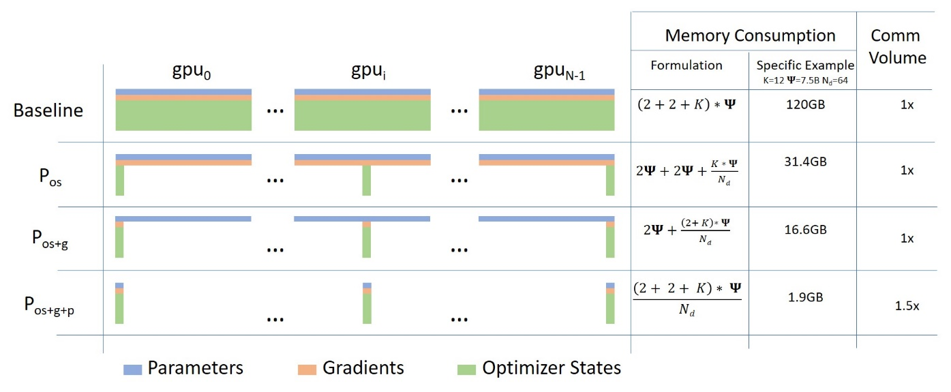
ZeRO, DeepSpeed და FairScale: ხელოვნური ინტელექტის მოდელების ვარჯიშის მეხსიერების ოპტიმიზაცია
სტატია მიმოიხილავს ხელოვნური ინტელექტის მოდელების ზრდასთან დაკავშირებულ მეხსიერების პრობლემებს და წარმოგიდგენთ ZeRO-ს, DeepSpeed-სა და FairScale-ს, როგორც ამ პრობლემის გადაჭრის საშუალებებს. განხილულია ამ ტექნოლოგიების ინტეგრაცია და ეფექტურობა მოდელების ვარჯიშის პროცესში, როგორც მრავალი, ისე ერთი GPU-ს გამოყენებისას, ხაზგასმულია მნიშვნელოვანი გაუმჯობესებები მუშაობის სიჩქარესა და მეხსიერების გამოყენებაში.

VAE დეკოდირების დელეგირება დისტანციურ ენდპოინტზე: მეხსიერების ეფექტურობა მაღალი რეზოლუციის სურათებისა და ვიდეოების სინთეზისთვის
მაღალი რეზოლუციის სურათებისა და ვიდეოების გენერირებისთვის, VAE დეკოდერები ხშირად დიდ მეხსიერებას მოიხმარენ, რაც ართულებს მათ გაშვებას სამომხმარებლო GPU-ებზე. არსებული გადაწყვეტილებები, როგორიცაა offloading ან tiling, იწვევს შეფერხებებს ან ხარისხის გაუარესებას. ამ პრობლემის გადასაჭრელად, Diffusers-მა შეიმუშავა ექსპერიმენტული ფუნქცია VAE დეკოდირების დისტანციურ ენდპოინტზე დელეგირებისთვის. ეს მიდგომა ზოგავს მეხსიერებას, აუმჯობესებს პარალელურ დამუშავებას, ღია კოდის პრინციპებზეა დაფუძნებული და Hugging
Intel Xeon Ice Lake: AI ამოცანების ოპტიმიზაცია პროგრამული გაუმჯობესებებით
Intel-ის უახლესი Ice Lake თაობის Xeon პროცესორები მნიშვნელოვან გაუმჯობესებას გვთავაზობს ხელოვნური ინტელექტის (AI) ამოცანებისთვის, განსაკუთრებით პროგრამული ოპტიმიზაციების დახმარებით. სტატია დეტალურად განიხილავს, თუ როგორ უზრუნველყოფს Intel-ი მაღალ ეფექტურობას AVX512, VNNI და oneAPI კომპონენტების, როგორიცაა oneMKL და oneDNN, მეშვეობით, ასევე სპეციალიზებული ფრეიმვორკებით, როგორიცაა Intel TensorFlow და PyTorch Extension. მიმოხილულია აპარატურული და პროგრამული ინოვაციების კომბინაცია, რამაც Ice Lake-ს

ONNX Runtime Hugging Face-ის მოდელების მუშაობას აუმჯობესებს
ONNX Runtime არის კროს-პლატფორმული ინსტრუმენტი, რომელიც აჩქარებს მანქანური სწავლების მოდელებს, განსაკუთრებით ONNX-ის მხარდაჭერით. Hugging Face-ზე, ღია კოდის პლატფორმაზე, 130 000-ზე მეტი ასეთი მოდელია, მათ შორის დიდი ენობრივი (LLM) და ღრუბლოვანი მოდელები, რომლებსაც შეუძლიათ მნიშვნელოვნად გააუმჯობესონ მუშაობა ONNX Runtime-ის მეშვეობით. მაგალითად, whisper-tiny მოდელის დაჩქარება PyTorch-თან შედარებით 74.30%-მდე ეფექტურობას იძლევა. ONNX Runtime მჭიდროდ თანამშრომლობს Hugging Face-თან 90-ზე მეტი არქიტე

Embedding მოდელების ოპტიმალური განთავსება Hugging Face Inference Endpoints-ზე: მაღალი წარმადობა და ხარჯთეფექტურობა
ამ სტატიაში განხილულია, თუ როგორ განვათავსოთ ღია კოდის Embedding მოდელები Hugging Face Inference Endpoints-ზე Text Embedding Inference (TEI) გადაწყვეტის გამოყენებით. ხაზგასმულია Embedding მოდელების უპირატესობა დიდი ენობრივი მოდელების (LLM-ების) მიმართ ზომისა და ინფერენსის სიჩქარის კუთხით. სტატია დეტალურად აღწერს Inference Endpoints-ის მახასიათებლებს, როგორიცაა ავტომატური მასშტაბირება და ნულამდე მასშტაბირება, და წარმოადგენს TEI-ს, როგორც მაღალი წარმადობისა და ხარჯთეფექტურობის გარანტს. ნაჩვენებია,
Hugging Face: როგორ გააუმჯობესეს საიდუმლოებების მართვა Infisical-ით და გაზარდეს უსაფრთხოება
Hugging Face-ის საინჟინრო გუნდმა, მრავალღრუბლოვანი ინფრასტრუქტურის პირობებში, საიდუმლოებების მართვის გაუმჯობესების მიზნით, Infisical აირჩია. ამ ქეის-სტადიაში დეტალურად არის აღწერილი მიგრაციის პროცესი, Infisical-ის ისეთი ფუნქციების ინტეგრაცია, როგორიცაა Kubernetes ოპერატორი, CI/CD ინტეგრაცია და დეტალური RBAC სისტემა. აღნიშნული გადაწყვეტილებით Hugging Face-მა მნიშვნელოვნად გააუმჯობესა უსაფრთხოება, გაამარტივა სამუშაო პროცესები და გაზარდა ინჟინრების ეფექტურობა საიდუმლოებების ცენტრალიზებული და უსაფრთ
Hugging Face Infinity: ტრანსფორმერული მოდელების ოპტიმალური განთავსება Intel Xeon CPU-ებზე
Hugging Face Infinity არის კონტეინერიზებული გადაწყვეტა, რომელიც საშუალებას აძლევს კომპანიებს ეფექტურად განათავსონ ტრანსფორმერული მოდელები წარმოებაში დაბალი ლატენტურობითა და მაღალი გამტარუნარიანობით. ეს ბლოგ პოსტი წარმოადგენს დეტალურ წარმადობის შედეგებს Infinity-ის უახლესი თაობის Intel Xeon CPU-ებზე გაშვებისას (კერძოდ, Ice Lake-ზე დაფუძნებული EC2 C6i ინსტანსებზე), რაც უზრუნველყოფს ოპტიმალურ ღირებულებას, ეფექტურობასა და ლატენტურობას თქვენი Transformer-ის განთავსებისთვის.
LoRA მოდელების ინფერენსის ოპტიმიზაცია ხელოვნურ ინტელექტში: სიჩქარე და ეფექტურობა
ამ ბლოგში დეტალურად განვიხილავთ, თუ როგორ შევძელით საჯარო Diffusion მოდელებზე დაფუძნებული საჯარო LoRA-ებისთვის ინფერენსის სიჩქარის მკვეთრი გაზრდა. ამან მოგვცა რესურსების დაზოგვისა და მომხმარებლისთვის უფრო სწრაფი და უკეთესი გამოცდილების შეთავაზების საშუალება. ჩვენ შევამცირეთ გაშვების საწყისი დრო 25 წამიდან 3 წამამდე, ხოლო მომხმარებლის მოთხოვნებზე პასუხის დრო 35 წამიდან 13 წამამდე. ამჟამად, ასობით განსხვავებული LoRA-ს ინფერენსს ვუზრუნველყოფთ 5-ზე ნაკლები A10G GPU-ით. განვიხილავთ LoRA ტექნიკის არსს

AutoRound: Intel-ის ინოვაციური მეთოდი ხელოვნური ინტელექტის მოდელების ოპტიმიზაციისთვის
AutoRound, Intel-ის მიერ შემუშავებული პოსტ-საწვრთნელი კვანტიზაციის (PTQ) მეთოდი, მნიშვნელოვნად აუმჯობესებს ხელოვნური ინტელექტის მოდელების ეფექტურობას მინიმალური სიზუსტის დაკარგვით. ის იყენებს ხელმოწერილ გრადიენტულ დაშვებას წონის დამრგვალებისა და ამოჭრის დიაპაზონების ოპტიმიზაციისთვის, რაც უზრუნველყოფს ზუსტ დაბალბიტიან კვანტიზაციას (INT2-INT8) და აღწევს 2.1-ჯერ მეტ ფარდობით სიზუსტეს INT2-ზე პოპულარულ ბაზისებთან შედარებით. მეთოდი სწრაფია, მსუბუქი და თავსებადია მრავალ LLM/VLM არქიტექტურასთან, რაც მა
მომხმარებელთა მხარდაჭერის ავტომატიზაცია NLP-ის გამოყენებით: უკმაყოფილო კლიენტების იდენტიფიკაცია
წინამდებარე სტატია განმარტავს, თუ როგორ შეიძლება ბუნებრივი ენის დამუშავების (NLP) მოდელების გამოყენება მომხმარებელთა მხარდაჭერის პროცესების ნაწილობრივი ავტომატიზაციისთვის. განხილულია ჰიპოთეტური შემთხვევა, სადაც NLP გამოიყენება განსაკუთრებით უკმაყოფილო მომხმარებლების შეტყობინებების იდენტიფიცირებისა და პრიორიტეტულობისთვის, რაც ზრდის პასუხის ეფექტურობასა და კლიენტების კმაყოფილებას. მოცემულია ნაბიჯები გამოყენების შემთხვევის განსაზღვიდან მონაცემთა ნაკრებებისა და მოდელების შერჩევამდე Hugging Face-ის პ