ZeRO, DeepSpeed და FairScale: ხელოვნური ინტელექტის მოდელების ვარჯიშის მეხსიერების ოპტიმიზაცია
სტატია მიმოიხილავს ხელოვნური ინტელექტის მოდელების ზრდასთან დაკავშირებულ მეხსიერების პრობლემებს და წარმოგიდგენთ ZeRO-ს, DeepSpeed-სა და FairScale-ს, როგორც ამ პრობლემის გადაჭრის საშუალებებს. განხილულია ამ ტექნოლოგიების ინტეგრაცია და ეფექტურობა მოდელების ვარჯიშის პროცესში, როგორც მრავალი, ისე ერთი GPU-ს გამოყენებისას, ხაზგასმულია მნიშვნელოვანი გაუმჯობესებები მუშაობის სიჩქარესა და მეხსიერების გამოყენებაში.
რამდენადაც ბოლო პერიოდის მანქანური სწავლების მოდელები (Machine Learning models) გაცილებით სწრაფად იზრდება, ვიდრე ახალ გამოშვებულ ვიდეობარათებს GPU მეხსიერება ემატება, ბევრი მომხმარებელი ვერ ახერხებს ამ უზარმაზარი მოდელების გაწვრთნას ან თუნდაც უბრალოდ ჩატვირთვას საკუთარ აპარატურაზე. მიუხედავად იმისა, რომ მიმდინარეობს მცდელობა, მოხდეს ამ დიდი მოდელების ზომის შემცირება უფრო მართვადი ზომებამდე – ეს ძალისხმევა საკმარისად მცირე მოდელებს საკმარისად მალე არ ქმნის.
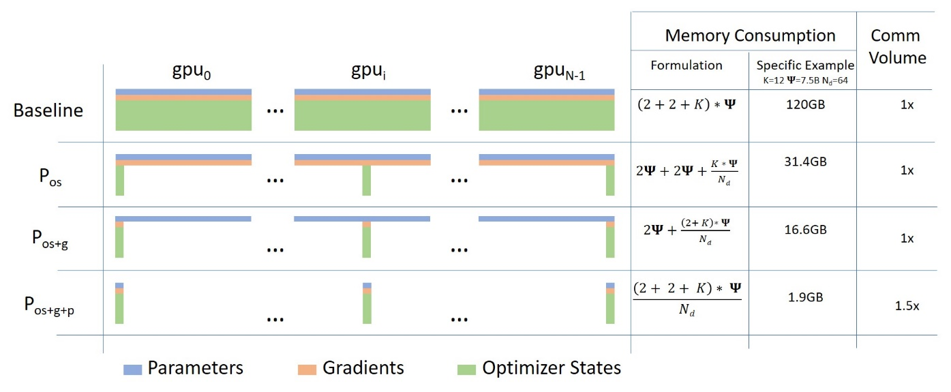
2019 წლის შემოდგომაზე სემიამ რაჯბანდარმა (Samyam Rajbhandari), ჯეფ რასლიმ (Jeff Rasley), ოლატუნჯი რუვასემ (Olatunji Ruwase) და იუქსიონგ ჰემ (Yuxiong He) გამოაქვეყნეს ნაშრომი: ZeRO: Memory Optimizations Toward Training Trillion Parameter Models, რომელიც შეიცავს უამრავ გენიალურ ახალ იდეას იმის შესახებ, თუ როგორ შეიძლება აპარატურამ ბევრად მეტი შეძლოს, ვიდრე ადრე იყო მიჩნეული. მცირე ხნის შემდეგ გამოვიდა DeepSpeed, რომელმაც მსოფლიოს შესთავაზა ამ ნაშრომში მოცემული იდეების უმეტესობის (რამდენიმე იდეა ჯერ კიდევ მუშავდება) ღია კოდის იმპლემენტაცია, პარალელურად კი Facebook-ის გუნდმა გამოუშვა FairScale, რომელმაც ასევე განახორციელა ZeRO ნაშრომის ზოგიერთი ძირითადი იდეა.
თუ იყენებთ Hugging Face Trainer-ს, transformers v4.2.0 ვერსიიდან გაქვთ DeepSpeed-ისა და FairScale-ის ZeRO ფუნქციების ექსპერიმენტული მხარდაჭერა. ახალი --sharded_ddp და --deepspeed ბრძანების ხაზის (command line) Trainer არგუმენტები უზრუნველყოფენ FairScale-ისა და DeepSpeed-ის ინტეგრაციას შესაბამისად. სრული დოკუმენტაცია შეგიძლიათ იხილოთ აქ. ეს ბლოგპოსტი აღწერს, თუ როგორ შეგიძლიათ ისარგებლოთ ZeRO-თი, მიუხედავად იმისა, ფლობთ მხოლოდ ერთ GPU-ს თუ მათ მთელ დასტას. მოდით, ჩავატაროთ მცირე დაზუსტების (finetuning) ექსპერიმენტი თარგმნის ამოცანით, t5-large მოდელის და finetune_trainer.py სკრიპტის გამოყენებით, რომელიც შეგიძლიათ იპოვოთ transformers GitHub რეპოზიტორიუმის examples/seq2seq განყოფილებაში. ჩვენ გვაქვს 2x 24GB (Titan RTX) GPU ტესტირებისთვის. ეს არის კონცეფციის დამტკიცების (proof of concept) ბენჩმარკები, ამიტომ, რა თქმა უნდა, ყველაფერი შეიძლება კიდევ გაუმჯობესდეს; ჩვენ შევადარებთ 2000 ელემენტის მცირე ნიმუშზე ვარჯიშისთვის და 500 ელემენტის შეფასებისთვის. შეფასება ნაგულისხმევად აკეთებს 4 ზომის სხივურ ძიებას (beam search), ამიტომ ის უფრო ნელია, ვიდრე ვარჯიში იგივე რაოდენობის ნიმუშებით, სწორედ ამიტომ ამ ტესტებში 4-ჯერ ნაკლები შეფასების ელემენტი იყო გამოყენებული.
აი, ჩვენი ბაზისური ვერსიის (baseline) ძირითადი ბრძანების ხაზის არგუმენტები: ჩვენ ვიყენებთ მხოლოდ DistributedDataParallel-ს (DDP) და მეტს არაფერს, რათა გავზარდოთ ბაზისური ვერსიის მუშაობა. მე შევძელი 16-ის ზომის ეპიზოდის (batch size - BS) მორგება, სანამ მეხსიერების ამოწურვის (Out of Memory - OOM) შეცდომა არ მივიღე. გაითვალისწინეთ, რომ სიმარტივისთვის და გასაგებად, მე ვაჩვენე მხოლოდ ის ბრძანების ხაზის არგუმენტები, რომლებიც მნიშვნელოვანია ამ დემონსტრაციისთვის. სრულ ბრძანების ხაზს იპოვით ამ პოსტში.
შემდეგ, ჩვენ ხელახლა გავუშვებთ ბენჩმარკს, ყოველ ჯერზე ვამატებთ ერთ-ერთ შემდეგს: რადგან ძირითადი ოპტიმიზაცია აქ არის ის, რომ თითოეული ტექნიკა GPU RAM-ს უფრო ეფექტურად იყენებს, ჩვენ ვეცდებით განუწყვეტლივ გავზარდოთ ეპიზოდის ზომა და ველოდებით, რომ ვარჯიში და შეფასება უფრო სწრაფად დასრულდება (მეტრიკების სტაბილურად შენარჩუნებით ან თუნდაც გაუმჯობესებით, მაგრამ ამაზე აქ არ გავამახვილებთ ყურადღებას). გახსოვდეთ, რომ ვარჯიშისა და შეფასების ეტაპები ერთმანეთისგან ძალიან განსხვავდება, რადგან ვარჯიშის დროს მოდელის წონები იცვლება, გრადიენტები გამოითვლება და ოპტიმიზატორის მდგომარეობები ინახება. შეფასების დროს, არცერთი ეს არ ხდება, მაგრამ თარგმნის ამ კონკრეტულ ამოცანაში მოდელი შეეცდება საუკეთესო ჰიპოთეზის ძიებას, ამიტომ მას რეალურად მრავალჯერადი გაშვება სჭირდება, სანამ შედეგით კმაყოფილი იქნება. სწორედ ამიტომ არ არის ის სწრაფი, განსაკუთრებით მაშინ, როდესაც მოდელი დიდია.
მოდით, გადავხედოთ ამ ექვსი ტესტის გაშვების შედეგებს: ადვილი მისახვედრია, რომ FairScale-იც და DeepSpeed-იც დიდ გაუმჯობესებას გვთავაზობენ ბაზისურ ვერსიასთან შედარებით, როგორც ვარჯიშისა და შეფასების საერთო დროში, ასევე ეპიზოდის ზომაში. DeepSpeed ამ სტატიის დაწერის მომენტისთვის უფრო მეტ „მაგიას“ ახორციელებს და, როგორც ჩანს, მოკლევადიანი გამარჯვებულია, თუმცა Fairscale უფრო მარტივია გამოსაყენებლად. DeepSpeed-ისთვის საჭიროა მარტივი კონფიგურაციის ფაილის დაწერა და ბრძანების ხაზის გამშვების შეცვლა, Fairscale-ისთვის კი მხოლოდ --sharded_ddp ბრძანების ხაზის არგუმენტის დამატება გჭირდებათ, ამიტომ შეიძლება ჯერ მისი მოსინჯვა მოგინდეთ, რადგან ის ყველაზე მარტივია. 80:20 წესის გათვალისწინებით, ამ ბენჩმარკებზე მხოლოდ რამდენიმე საათი დავხარჯე და არ მიცდია ყოველი მბ და წამის ამოწურვა ბრძანების ხაზის არგუმენტებისა და კონფიგურაციის დახვეწით, რადგან მარტივი ცხრილიდან საკმაოდ აშკარაა, რა შეგიძლიათ სცადოთ შემდეგ. როდესაც რეალურ პროექტს შეხვდებით, რომელიც საათობით ან შესაძლოა დღეებით იმუშავებს, აუცილებლად დაუთმეთ მეტი დრო, რათა დარწმუნდეთ, რომ იყენებთ ყველაზე ოპტიმალურ ჰიპერ-პარამეტრებს თქვენი სამუშაოს უფრო სწრაფად და მინიმალური დანახარჯით შესასრულებლად.
თუ გსურთ თავად გამოსცადოთ ეს ბენჩმარკი ან მეტი დეტალი გაიგოთ მისი გაშვებისთვის გამოყენებული აპარატურისა და პროგრამული უზრუნველყოფის შესახებ, გთხოვთ, იხილოთ ეს პოსტი. მიუხედავად იმისა, რომ Fairscale მხოლოდ მრავალ GPU-სთან ერთად გვაძლევს გაუმჯობესებას, DeepSpeed საჩუქარია მათთვისაც კი, ვისაც ერთი GPU აქვს. მოდით, ვცადოთ შეუძლებელი – ვავარჯიშოთ t5-3b 24GB RTX-3090 ბარათზე. პირველ რიგში, შევეცადოთ უზარმაზარი t5-3b-ის დაზუსტება ჩვეულებრივი ერთი GPU-ს კონფიგურაციით: არაფერი გამოვიდა, BS=1-ითაც კი მივიღეთ: გაითვალისწინეთ, როგორც ადრე, მე ვაჩვენებ მხოლოდ მნიშვნელოვან ნაწილებს და ბრძანების ხაზის სრული არგუმენტები შეგიძლიათ იპოვოთ აქ. ახლა განაახლეთ თქვენი ტრენერი...
თეგები:
#ხელოვნური ინტელექტი
#მანქანური სწავლება
#ოპტიმიზაცია
#ღრმა სწავლება
#deepspeed
#zero
#gpu მეხსიერება
#fairscale
წყარო: huggingface.co
AI-ით გადამუშავებული


