
Bing-ის ვებმასტერის გაიდლაინების განახლება: ხელოვნური ინტელექტის ეპოქის გამოწვევები და GEO-ს კონცეფცია
Microsoft-მა განაახლა Bing-ის ვებმასტერის გაიდლაინები, რათა მოერგოს ხელოვნური ინტელექტის (AI) მართული ძიების გამოწვევებს. ახალი მითითებები მოიცავს Copilot-ის და AI პასუხების დასაბუთებას, ასევე აცნობს ახალ კონცეფციას „გენერაციული ძრავის ოპტიმიზაცია“ (GEO). განახლებები ასევე ეხება AI-ით გენერირებულ კონტენტს, იცვლება სპამის პოლიტიკა და გვთავაზობს რეკომენდაციებს AI სისტემებისთვის კონტენტის წყაროდ შერჩევისთვის, რაც ციფრული მარკეტინგის ლანდშაფტს მნიშვნელოვნად გარდაქმნის.
Atlassian-მა Jira-ში ხელოვნური ინტელექტის აგენტები დანერგა გუნდების პროდუქტიულობის გასაზრდელად
საინტერპრაიზო პროგრამული უზრუნველყოფის გიგანტმა Atlassian-მა თავის პროექტების მართვის პროგრამა Jira-ში ხელოვნური ინტელექტის აგენტები ჩააშენა, რაც ადამიანურ და AI გუნდებს საშუალებას აძლევს, შეუფერხებლად ითანამშრომლონ ერთიან დაფაზე. ეს ინიციატივა მიზნად ისახავს პროდუქტიულობის მნიშვნელოვან ზრდას ციფრული აგენტებისთვის დავალებების მინიჭების, მართვისა და თვალთვალის შესაძლებლობით, რაც შეამცირებს ქაოსს და ოპტიმიზაციას გაუწევს სამუშაო პროცესებს.

გახადეთ თქვენი ტელევიზორის გამოსახულება იდეალური: პარამეტრები, რომლებიც უნდა შეცვალოთ
გაიგეთ, თუ როგორ უნდა ოპტიმიზაცია გაუკეთოთ თქვენი ტელევიზორის პარამეტრებს, რათა მიიღოთ საუკეთესო ვიზუალური გამოცდილება. სტატია განმარტავს, თუ რატომ არის „სიმკვეთრის“ (Sharpness) პარამეტრი ხშირად მცდარი, როგორ მოქმედებს მოძრაობის გამარტივება (Motion Smoothing) გამოსახულებაზე, რატომ უნდა გამორთოთ „კაშკაშა“ (Vivid) რეჟიმი და როგორ სწორად დაარეგულიროთ სიკაშკაშე და კონტრასტი.

Mac-ის ოპტიმიზაცია: როგორ გავასუფთავოთ ქეში Safari-ში, Chrome-ში და აპლიკაციებში
ZDNET განმარტავს საკუთარი რეკომენდაციების მიუკერძოებელ ხასიათს, რომელიც ეფუძნება დეტალურ ტესტირებასა და კვლევას. სტატიაში ასევე განხილულია Mac-ის ქეშის დაგროვების პრობლემა, რაც ამცირებს სისტემის მუშაობას. მოცემულია დეტალური ინფორმაცია, თუ როგორ უნდა გავასუფთავოთ ქეში Safari-ში, Chrome-ში და სხვა აპლიკაციებში, რათა გაუმჯობესდეს მოწყობილობის სიჩქარე და მოგვარდეს გავრცელებული პრობლემები.

ლონდონური სტარტაპი Mirai AI მოდელებს მოწყობილობებზე მუშაობისთვის აუმჯობესებს
Mirai, $10 მილიონიანი საწყისი დაფინანსებით, მუშაობს ხელოვნური ინტელექტის მოდელების ოპტიმიზაციაზე ტელეფონებსა და ლეპტოპებზე. კომპანია, რომლის დამფუძნებლებსაც წარსულში წარმატებული სამომხმარებლო აპლიკაციების შექმნის გამოცდილება აქვთ, მიზნად ისახავს ღრუბლოვანი სერვისებზე დამოკიდებულების შემცირებას და დეველოპერებისთვის მარტივი SDK-ის შეთავაზებას, რაც ხელს შეუწყობს AI-ის ეფექტურ ინტეგრაციას მოწყობილობებში, და ასევე გეგმავს Android-ის მხარდაჭერასა და მოწყობილობაშიდა ბენჩმარკების გამოშვებას.

სახლის ბატარეის სისტემები: ენერგეტიკული დამოუკიდებლობა და ხარჯების ოპტიმიზაცია
ბოლოდროინდელმა ელექტროენერგიის გათიშვებმა გამოკვეთა ქსელის სისუსტე და სარეზერვო ენერგიის მნიშვნელობა. ენერგიის მზარდი ხარჯების ფონზე, სახლის ბატარეის სისტემები სულ უფრო მიმზიდველი ხდება. მზის პანელებთან დაწყვილებული, ეს სისტემები არა მხოლოდ უზრუნველყოფს სარეზერვო ენერგიას, არამედ საშუალებას აძლევს მფლობელებს შეინახონ ჭარბი ენერგია, გამოიყენონ ის პიკური მოთხოვნის დროს და მნიშვნელოვნად შეამცირონ ყოველთვიური გადასახადები. გარდა პრაქტიკული სარგებლისა, ბატარეის მფლობელები აფასებენ ენერგიის წყაროზე კო

SpendRule, ჯანდაცვის ხარჯების ხელოვნური ინტელექტით მართვის პლატფორმა, ფარული რეჟიმიდან გამოდის და 2 მილიონ დოლარს იზიდავს
SpendRule, ხელოვნური ინტელექტის მქონე პლატფორმა, რომელიც ჯანდაცვის სისტემებს ხარჯების თვალყურის დევნებასა და ოპტიმიზაციაში ეხმარება, ოფიციალურად ამოქმედდა და 2 მილიონი დოლარის საწყისი დაფინანსება მოიზიდა. კრის ჰეკლერისა და ჯოზეფ აკინტოლაიოს მიერ დაარსებული კომპანია მიზნად ისახავს რთული შესყიდვების მართვას და საავადმყოფოებში ზედმეტი ხარჯვის თავიდან აცილებას, ტრადიციული აუდიტორული პროცესების ავტომატიზაციით.

ZDNET-ის რეკომენდაციები: როგორ მივიღოთ მაქსიმალური ხარისხი HDMI კავშირით
სტატია განმარტავს ZDNET-ის სარედაქციო გუნდის მუშაობის პრინციპებს, რომელიც მოიცავს მრავალსაათიან ტესტირებას, კვლევასა და დამოუკიდებელ შეფასებებს, რათა მკითხველს მიაწოდოს ზუსტი და კომპეტენტური რჩევები. გარდა ამისა, მოცემულია დეტალური სახელმძღვანელო, თუ როგორ უნდა მოხდეს HDMI კავშირის ოპტიმიზაცია ტელევიზორებთან და სხვა მოწყობილობებთან, მაქსიმალური გამოსახულებისა და ხმის ხარისხის მისაღწევად. ძირითადი რჩევები მოიცავს სწორი HDMI პორტების (2.1 vs 2.0, ARC/eARC), შესაბამისი კაბელების (მაღალსიჩქარიანი, უ

Hugging Face-ი ფაილების გადაცემის არქიტექტურას ანახლებს: ახალი მიდგომა დიდი მოცულობის მონაცემებისთვის
Hugging Face აცხადებს ინფრასტრუქტურის მნიშვნელოვან განახლებას, რათა ოპტიმიზაცია გაუკეთოს მოდელებისა და მონაცემთა ნაკრებების დიდი ზომის ფაილების ატვირთვასა და ჩამოტვირთვას. არსებული CDN-ის (AWS CloudFront) 50GB ლიმიტის გამოწვევის ფონზე, კომპანია ნერგავს კონტენტზე მიბმულ საცავს (CAS), როგორც ახალ არქიტექტურულ ელემენტს. ეს ახალი სისტემა იყენებს "სულელი წაკითხვების" და "ჭკვიანი ჩაწერების" პერსონალიზებულ პროტოკოლს, რომელიც აანალიზებს ფაილებს ბაიტის დონეზე, რათა გააუმჯობესოს გადაცემის სიჩქარე, უზრუნვე
AMD Hugging Face-ის აპარატურის პარტნიორი ხდება: ახალი ეტაპი ხელოვნური ინტელექტის განვითარებაში
ტექნოლოგიურმა გიგანტებმა Hugging Face-მა და AMD-მ გამოაცხადეს სტრატეგიული პარტნიორობა, რომელიც მიზნად ისახავს უახლესი ტრანსფორმატორული მოდელების ოპტიმიზაციას AMD-ის ცენტრალურ პროცესორებსა (CPUs) და გრაფიკულ პროცესორებზე (GPUs). ეს თანამშრომლობა მნიშვნელოვნად გააფართოებს ღრმა სწავლისთვის ხელმისაწვდომი აპარატურის არჩევანს, შეამცირებს ხარჯებს და დააწესებს ახალ სტანდარტებს ხელოვნური ინტელექტის (AI) გამოთვლებში.
Core ML-ის ოპტიმიზაცია: Apple-ის მოწყობილობებზე AI მოდელების მუშაობის ახალი დონე
Core ML-ის უახლესი გაუმჯობესებები მნიშვნელოვნად აჩქარებს ხელოვნური ინტელექტის (AI) მოდელების, მათ შორის Stable Diffusion-ისა და დიდი ენის მოდელების, მუშაობას Apple-ის მოწყობილობებზე. ეს ოპტიმიზაციები, რომელიც მოიცავს 6-ბიტიან პალეტიზაციას და ml-stable-diffusion რეპოზიტორიუმის განახლებას, უზრუნველყოფს მონაცემთა ნაკლებ გადაცემას, მეტ კონფიდენციალურობას და ხარჯების დაზოგვას, რაც დეველოპერებს აძლევს საშუალებას, შექმნან უფრო ეფექტური აპლიკაციები უშუალოდ მოწყობილობაზე.

როგორ გავიგოთ და ოპტიმიზაცია გავუკეთოთ GPU მეხსიერების გამოყენებას PyTorch-ში
ეს სტატია დეტალურად განიხილავს, თუ როგორ უნდა მოვახდინოთ GPU მეხსიერების გამოყენების ვიზუალიზაცია, გაგება და ოპტიმიზაცია PyTorch-ში ტრენინგის დროს. ის ეტაპობრივად ხსნის მეხსიერების განაწილებას მოდელის შექმნის, შეყვანის ტენზორების, Forward/Backward გავლისა და ოპტიმიზატორის ნაბიჯებისთვის, დეტალური მაგალითებისა და პროფაილინგის ხელსაწყოების გამოყენებით. გაანალიზებულია როგორც გამარტივებული, ასევე რეალური LLM-ის ტრენინგის მეხსიერების პროფილი.
როგორ გავიგოთ და ოპტიმიზაცია გავუკეთოთ GPU მეხსიერებას PyTorch-ში
ეს გაკვეთილი ეტაპობრივად განმარტავს, თუ როგორ მოვახდინოთ GPU მეხსიერების გამოყენების ვიზუალიზაცია და გაგება PyTorch-ში ტრენინგის დროს. ის მოიცავს მეხსიერების მოთხოვნების შეფასებას, გამოყენების ოპტიმიზაციას PyTorch-ის პროფილის ხელსაწყოების მეშვეობით და დეტალურ ანალიზს იმის შესახებ, თუ როგორ იქცევა მეხსიერება მოდელის შექმნის, წინსვლის, უკუგადაცემის და ოპტიმიზატორის ნაბიჯების განმავლობაში, მათ შორის დიდი ენობრივი მოდელების (LLM) რეალურ სცენარებში.
Stable Diffusion XL Core ML-ზე: მოდელის ზომის შემცირება და მუშაობის გაუმჯობესება
Hugging Face-ი და Apple-ი აგრძელებენ ხელოვნური ინტელექტის მოდელების ოპტიმიზაციას სამომხმარებლო მოწყობილობებზე ადგილობრივად გასაშვებად. უახლესი მცდელობა Stable Diffusion XL-ის Core ML-ზე ადაპტაციაა Apple Silicon-ის Mac-ებისთვის, რაც საშუალებას იძლევა მოდელი შემცირდეს ზომით და გაუმჯობესდეს მისი მუშაობა ინოვაციური კვანტიზაციის მეთოდებით, მათ შორის შერეული ბიტების პალეტიზაციით. პროექტი სრულად ღია კოდით არის ხელმისაწვდომი და community-ის ჩართულობას ელის.

დიდი ენობრივი მოდელების კონტექსტის ფანჯრის გამოწვევები: KV Cache-ის მეხსიერების ოპტიმიზაცია KVPress-ით
დიდი ენობრივი მოდელების (LLM) გაფართოებული კონტექსტის ფანჯრები წარმოუდგენელ შესაძლებლობებს იძლევა, თუმცა KV Cache-ის მიერ მოხმარებული მეხსიერების მართვას ართულებს. მაგალითად, 1 მილიონი ტოკენის დამუშავება Llama 3-70B-ით 330 GB-ს მოითხოვს მხოლოდ KV Cache-ისთვის. NVIDIA-ს მიერ შემუშავებული KVPress ამ პრობლემის გადასაჭრელად კომპრესიის ინოვაციურ ტექნიკას გვთავაზობს, რომელიც მეხსიერების მოხმარებას ამცირებს მოდელის სიზუსტის შენარჩუნებით.
მოწინავე ჰიპერპარამეტრების ოპტიმიზაცია Hugging Face Transformers-თან და Ray Tune-თან ერთად
მანქანური სწავლების მოდელების ეფექტურობის გასაუმჯობესებლად აუცილებელია ჰიპერპარამეტრების დარეგულირება, თუმცა ხშირად მას სათანადო ყურადღება არ ექცევა. Hugging Face Transformers-ის 3.1 ვერსიაში Hugging Face Transformers-მა და Ray Tune-მა გააერთიანეს ძალები, რათა შემოგვთავაზონ მარტივი, მაგრამ მძლავრი ინტეგრაცია. ეს გადაწყვეტა უზრუნველყოფს მოწინავე ოპტიმიზაციის ალგორითმებზე მარტივ წვდომას, როგორიცაა PBT, HyperBand და ბაიესური ოპტიმიზაცია, რაც მნიშვნელოვნად აუმჯობესებს მოდელების მუშაობას და ინარჩუნებ
100-ჯერ გაზრდილი წარმადობა: დიდი AI მოდელების ოპტიმიზაცია Hugging Face-ის ინფრასტრუქტურაზე
მიუხედავად იმისა, რომ დიდი ენობრივი მოდელების ექსპერიმენტირება მარტივია, მათი მაქსიმალური წარმადობით პროდუქციაში განთავსება რთული საინჟინრო გამოწვევაა. Hugging Face გთავაზობთ გადაწყვეტას თავისი Accelerated Inference API-ის მეშვეობით, რომელიც უზრუნველყოფს 100-ჯერ გაზრდილ სიჩქარეს და მასშტაბირებადობას. სტატია დეტალურად აღწერს ოპტიმიზაციის სხვადასხვა დონეს – ბიბლიოთეკების გამოყენებიდან აპარატურის სპეციფიკურ მოდიფიკაციამდე – და ხაზს უსვამს Hugging Face-ის ექსპერტიზასა და პარტნიორობებს ტექნიკის წამყვ
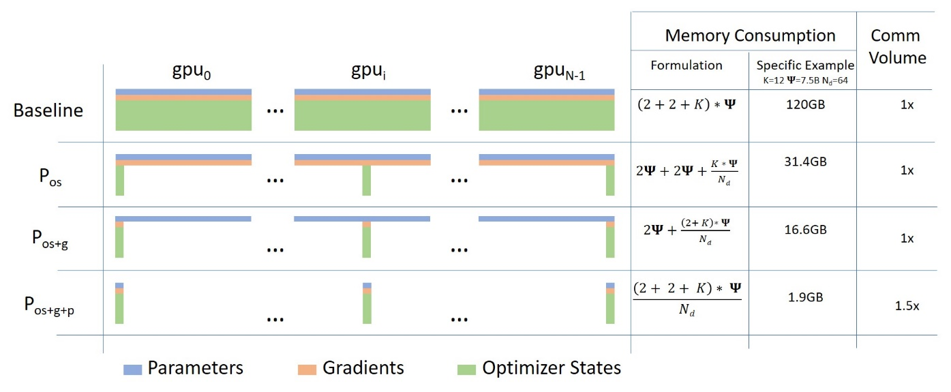
ZeRO, DeepSpeed და FairScale: ხელოვნური ინტელექტის მოდელების ვარჯიშის მეხსიერების ოპტიმიზაცია
სტატია მიმოიხილავს ხელოვნური ინტელექტის მოდელების ზრდასთან დაკავშირებულ მეხსიერების პრობლემებს და წარმოგიდგენთ ZeRO-ს, DeepSpeed-სა და FairScale-ს, როგორც ამ პრობლემის გადაჭრის საშუალებებს. განხილულია ამ ტექნოლოგიების ინტეგრაცია და ეფექტურობა მოდელების ვარჯიშის პროცესში, როგორც მრავალი, ისე ერთი GPU-ს გამოყენებისას, ხაზგასმულია მნიშვნელოვანი გაუმჯობესებები მუშაობის სიჩქარესა და მეხსიერების გამოყენებაში.
პირდაპირი უპირატესობის ოპტიმიზაცია (DPO) LLM-ების დახვეწას ამარტივებს
ეს სტატია წარმოგიდგენთ პირდაპირი უპირატესობის ოპტიმიზაციის (DPO) მეთოდს, რომელიც მნიშვნელოვნად ამარტივებს დიდი ენობრივი მოდელების (LLM) დახვეწის პროცესს. ტრადიციული გაძლიერებითი სწავლისგან ადამიანის უკუკავშირით (RLHF) განსხვავებით, DPO გამორიცხავს ჯილდოს მოდელის შექმნის კომპლექსურ საფეხურს და RL ოპტიმიზაციას, პირდაპირ ახდენს ენობრივი მოდელის ოპტიმიზაციას უპირატესობის მონაცემებზე, ბინარული კროს-ენტროპიის დანაკარგის გამოყენებით. ეს მიდგომა ვარჯიშს უფრო ეფექტურს და ნაკლებად პრობლემურს ხდის, რაც შეს

DeepSeek R1-ის გამოშვებიდან ორი კვირა: ღია-R1 პროექტის მიღწევები და გამოწვევები
სტატია აჯამებს ღია-R1 პროექტის განვითარებას, რომელიც DeepSeek R1-ის სასწავლო კონვეიერისა და სინთეზური მონაცემების რეპლიკაციას ისახავს მიზნად. მიღწევებს შორისაა DeepSeek-ის შეფასების ქულების რეპროდუცირება და GRPO-ის ინტეგრაცია TRL-ში. პროექტი DeepSeek R1-ის ხანგრძლივი პასუხების გამო GPU მეხსიერებისა და გენერაციის ეფექტურობის გამოწვევების წინაშე დგას, თუმცა ინფერენსის ოპტიმიზაციაში მნიშვნელოვანი პროგრესია. ინიციატივამ მედიის ფართო ინტერესიც გამოიწვია.
Bark TTS მოდელის ოპტიმიზაცია Hugging Face ეკოსისტემით: მეხსიერება და ინფერენსის გაუმჯობესება
ეს სტატია წარმოგიდგენთ 'Bark' ტექსტიდან მეტყველებად გარდამქმნელი (TTS) მოდელის ოპტიმიზაციის პრაქტიკულ სახელმძღვანელოს Hugging Face-ის 'Transformers', 'Optimum' და 'Accelerate' ბიბლიოთეკების გამოყენებით. დეტალურად განიხილება მეხსიერების მოხმარების შემცირებისა და ინფერენსის სიჩქარის გაუმჯობესების სამი მარტივი მეთოდი, მათ შორის 'Better Transformer' და 'Flash Attention'. ასევე ნაჩვენებია ოპტიმიზებული და არაოპტიმიზებული მოდელების წარმადობის შედარებისა და ბენჩმარკინგის პროცესი.
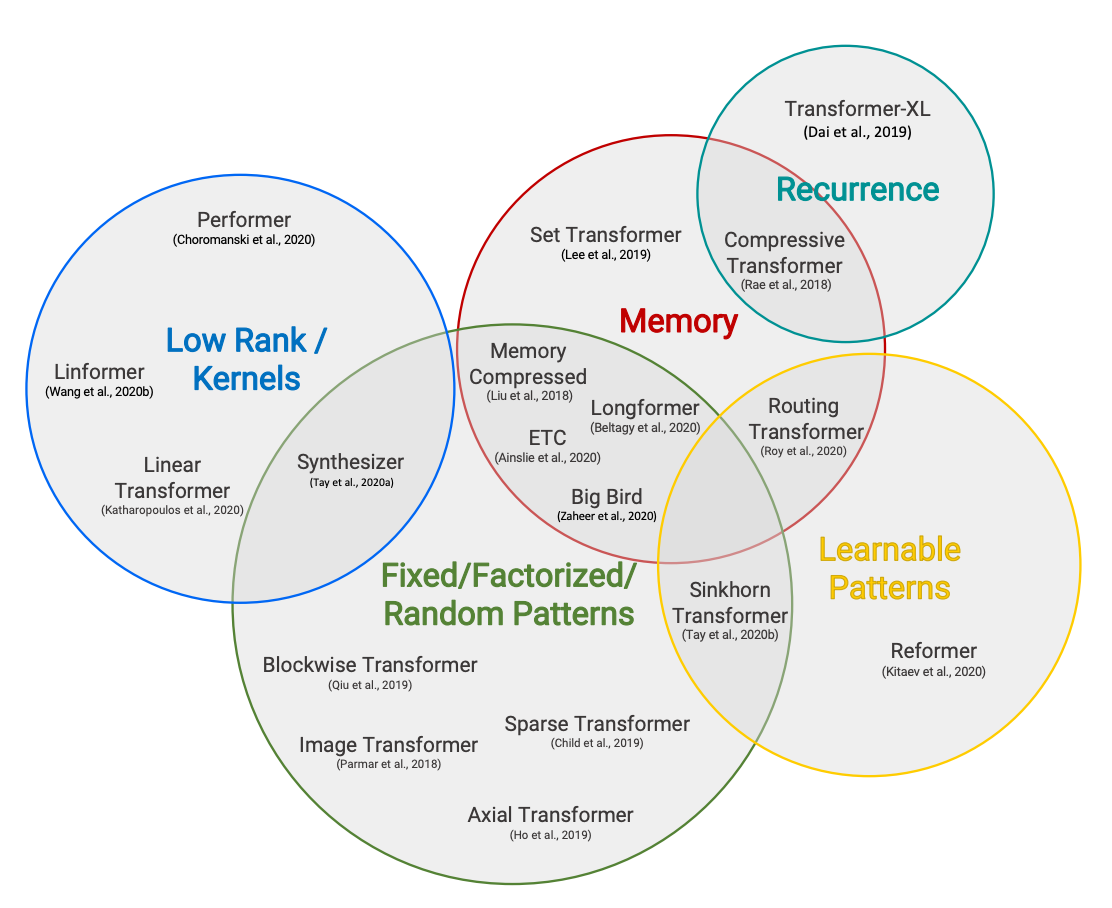
ტრანსფორმერების ეფექტურობის გამოწვევები: შორს მიმავალი ყურადღება და მეხსიერების ოპტიმიზაცია
დიდი ტრანსფორმერების მოდელების გამოთვლითი მოთხოვნების შემცირება კვლევის ერთ-ერთი მთავარი მიმართულებაა, განსაკუთრებით თანმიმდევრობის სიგრძესთან დაკავშირებული კვადრატული დანახარჯის პრობლემის გამო. სტატია განიხილავს ოთხ ძირითად მიდგომას ამ გამოწვევის მოსაგვარებლად: Longformer, Transformer-XL, Compressive Transformer და დაბალი რანგის ყურადღების მატრიცების გამოყენება, რომლებიც მიზნად ისახავს მოდელების მეხსიერებისა და დროის ეფექტურობის გაუმჯობესებას გრძელი თანმიმდევრობების დამუშავებისას.
Hugging Face-მა AutoGPTQ ინტეგრირება მოახდინა Transformers-ში: ხელმისაწვდომი დიდი ენობრივი მოდელები
Hugging Face-მა თავის Transformers ბიბლიოთეკაში AutoGPTQ-ის ინტეგრირებით, დიდი მანქანური სწავლის მოდელების ხელმისაწვდომობა მნიშვნელოვნად გაზარდა. ეს მომხმარებლებს საშუალებას აძლევს, მოდელების 8-დან 2-ბიტამდე სიზუსტით კვანტიზაცია და გაშვება შეძლონ GPTQ ალგორითმის გამოყენებით, მინიმალური სიზუსტის დაკარგვით და გაუმჯობესებული წარმადობით. ინტეგრაცია ხელმისაწვდომია როგორც Nvidia, ასევე RoCm-ზე მომუშავე AMD GPU-ებისთვის, რაც LLM-ების ოპტიმიზაციას უფრო ფართო აუდიტორიისთვის ხდის შესაძლებელს.
Hugging Face Hub: მონაცემთა გადაცემის და შენახვის ოპტიმიზაცია დედუპლიკაციის ახალი მიდგომებით
Hugging Face Hub-ზე ხელოვნური ინტელექტის მოდელებისა და მონაცემთა ნაკრებების სწრაფი ზრდა მოითხოვს ეფექტურ მონაცემთა მართვას. სტატია აღწერს, თუ როგორ უმკლავდება Xet გუნდი გამოწვევებს, რომლებიც დაკავშირებულია დედუპლიკაციასთან, ტრადიციული მიდგომების შეზღუდვებთან და მასშტაბირებადობასთან. ნაცვლად იმისა, რომ ფოკუსირება მხოლოდ მცირე ბლოკების დედუპლიკაციაზე მოხდეს, რაც ინფრასტრუქტურას გადატვირთავს, Xet გუნდმა შეიმუშავა ინოვაციური, ბლოკებზე დაფუძნებული მიდგომა Rust-ში დაწერილი xet-core და hf_xet ინტეგრაცი