ტრანსფორმერების ეფექტურობის გამოწვევები: შორს მიმავალი ყურადღება და მეხსიერების ოპტიმიზაცია
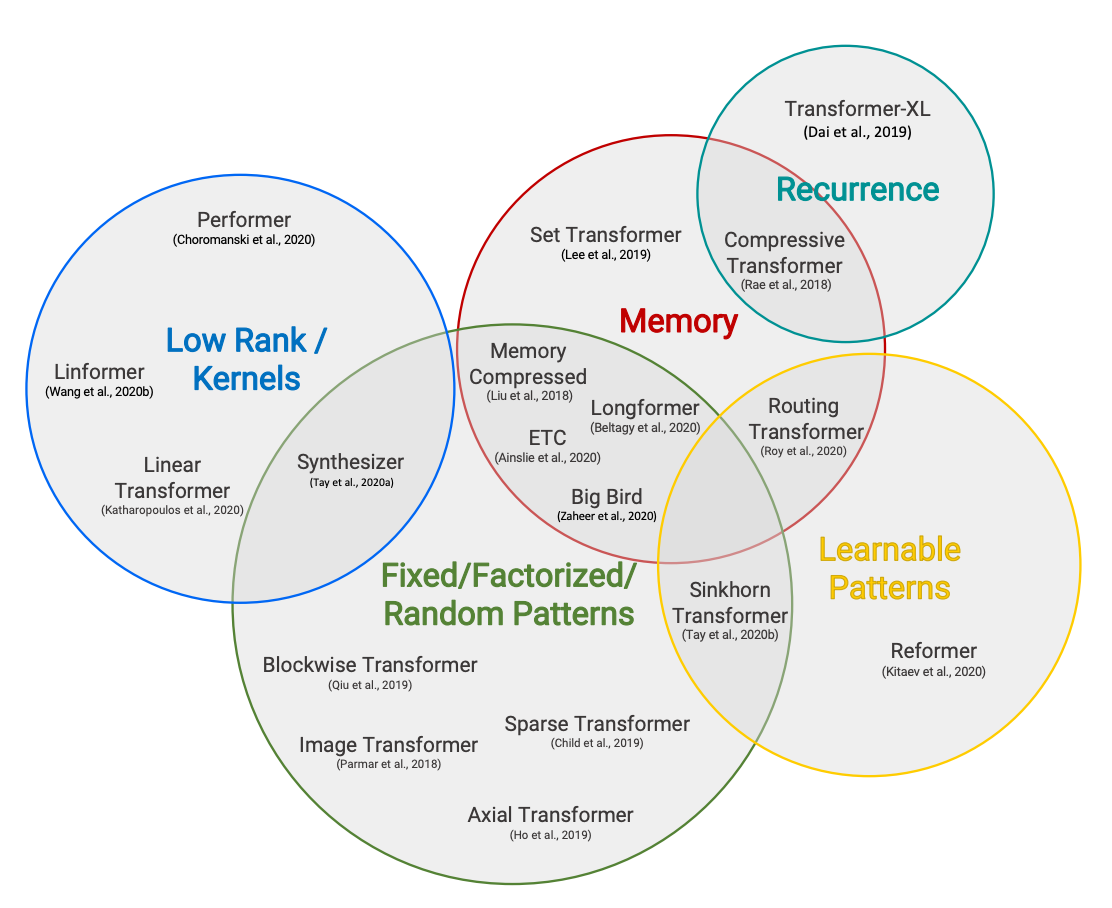
დიდი ტრანსფორმერების მოდელების გამოთვლითი მოთხოვნების შემცირება კვლევის ერთ-ერთი მთავარი მიმართულებაა, განსაკუთრებით თანმიმდევრობის სიგრძესთან დაკავშირებული კვადრატული დანახარჯის პრობლემის გამო. სტატია განიხილავს ოთხ ძირითად მიდგომას ამ გამოწვევის მოსაგვარებლად: Longformer, Transformer-XL, Compressive Transformer და დაბალი რანგის ყურადღების მატრიცების გამოყენება, რომლებიც მიზნად ისახავს მოდელების მეხსიერებისა და დროის ეფექტურობის გაუმჯობესებას გრძელი თანმიმდევრობების დამუშავებისას.
ყოველთვიურად ვირჩევთ ერთ თემას, რომელზეც ფოკუსირებას მოვახდენთ, კერძოდ, ამ საკითხზე ცოტა ხნის წინ გამოქვეყნებულ ოთხ ნაშრომს წავიკითხავთ. ამის შემდეგ, დავწერთ მოკლე ბლოგ პოსტს, რომელიც შეაჯამებს მათ დასკვნებს, მათ შორის არსებულ საერთო ტენდენციებს და შემდგომი კვლევისთვის წარმოშობილ კითხვებს. 2021 წლის იანვრის პირველი თემა იყო მეჩხერი სტრუქტურა და გასხვლა (Sparsity and Pruning), ხოლო 2021 წლის თებერვალში განვიხილეთ შორს მიმავალი ყურადღება ტრანსფორმერებში (Long-Range Attention in Transformers).
2018 და 2019 წლებში დიდი ტრანსფორმერების მოდელების გამოჩენის შემდეგ, სწრაფად გამოიკვეთა ორი ტენდენცია, რომელიც მიზნად ისახავდა მათი გამოთვლითი მოთხოვნების შემცირებას. პირველ რიგში, პირობითმა გამოთვლამ, კვანტიზაციამ, დისტილაციამ და გასხვლამ შესაძლებელი გახადა დიდი მოდელების ინფერენცია გამოთვლითი რესურსებით შეზღუდულ გარემოში; ამ საკითხს ნაწილობრივ უკვე შევეხეთ ჩვენს ბოლო სამკითხველო ჯგუფის პოსტში. შემდეგ კვლევითი საზოგადოება გადავიდა წინასწარი წვრთნის (pre-training) ხარჯების შემცირებაზე. კერძოდ, ძალისხმევის ცენტრში იყო ერთი საკითხი: ტრანსფორმერების მოდელების მეხსიერებისა და დროის კვადრატული დანახარჯი თანმიმდევრობის სიგრძესთან მიმართებაში.
ძალიან დიდი მოდელების ეფექტური წვრთნის უზრუნველსაყოფად, 2020 წელს გამოქვეყნდა უამრავი ნაშრომი ამ ბოთლის ყელის მოსაგვარებლად და ტრანსფორმერების გასაფართოებლად ჩვეულებრივი 512- ან 1024- თანმიმდევრობის სიგრძის მიღმა, რაც წლის დასაწყისში NLP-ში სტანდარტს წარმოადგენდა. ეს თემა თავიდანვე იყო ჩვენი კვლევითი დისკუსიების მთავარი ნაწილი, და ჩვენმა პატრიკ ფონ პლატენმა უკვე მიუძღვნა 4-ნაწილიანი სერია Reformer-ს.
ამ სამკითხველო ჯგუფში, ნაცვლად იმისა, რომ ყველა მიდგომა განვიხილოთ (რაც ძალიან ბევრია!), ჩვენ ოთხ ძირითად იდეაზე გავამახვილებთ ყურადღებას: თემის ამომწურავი მიმოხილვისთვის, იხილეთ „ეფექტური ტრანსფორმერები: მიმოხილვა“ (Efficient Transformers: A Survey) და „შორ მანძილზე მოქმედების ასპარეზი“ (Long Range Arena).
იზ ბელტაგი, მეთიუ ე. პეტერსი, არმან კოჰანი - Longformer-ი ტრანსფორმერების მეხსიერების ბოთლის ყელს აგვარებს ჩვეულებრივი თვით-ყურადღების (self-attention) ჩანაცვლებით ფანჯრისებური/ლოკალური/მეჩხერი (შდრ. Sparse Transformers (2019)) ყურადღებისა და გლობალური ყურადღების კომბინაციით, რომელიც ხაზოვნად იზრდება თანმიმდევრობის სიგრძესთან ერთად. წინა შორს მიმავალი ტრანსფორმერების მოდელებისგან განსხვავებით (მაგ., Transformer-XL (2019), Reformer (2020), Adaptive Attention Span (2019)), Longformer-ის თვით-ყურადღების ფენა შექმნილია, როგორც სტანდარტული თვით-ყურადღების პირდაპირი შემცვლელი, რითაც შესაძლებელი ხდება წინასწარ გაწვრთნილი საკონტროლო წერტილების გამოყენება შემდგომი წინასწარი წვრთნისა და/ან დახვეწისთვის გრძელი თანმიმდევრობის ამოცანებზე. სტანდარტული თვით-ყურადღების მატრიცა (სურათი ა) კვადრატულად იზრდება შეყვანის სიგრძესთან ერთად: Longformer-ი იყენებს ყურადღების სხვადასხვა შაბლონს ავტორეგრესიული ენის მოდელირებისთვის, ენკოდერის წინასწარი წვრთნისა და დახვეწისთვის, და თანმიმდევრობიდან-თანმიმდევრობაზე ამოცანებისთვის.
ჯეკ ვ. რეი, ანა პოტაპენკო, სიდანტ მ. ჯაიაკუმარი, ტიმოთი პ. ლილიკრაპი - Transformer-XL (2019) აჩვენა, რომ მეხსიერებაში ადრე გამოთვლილი ფენის გააქტიურების (activations) ქეშირებას შეუძლია გააუმჯობესოს შესრულება ენის მოდელირების ამოცანებზე (როგორიცაა enwik8). ნაცვლად მხოლოდ მიმდინარე `n` შეყვანის ტოკენებზე ყურადღების გამახვილებისა, მოდელს ასევე შეუძლია მიაქციოს ყურადღება `n_m` წარსულ ტოკენს, სადაც `n_m` არის მოდელის მეხსიერების ზომა. Transformer-XL-ს აქვს მეხსიერების სირთულე O(n² + n n_m), რაც აჩვენებს, რომ მეხსიერების ხარჯი შეიძლება მნიშვნელოვნად გაიზარდოს ძალიან დიდი `n_m`-სთვის. ამდენად, Transformer-XL-ს საბოლოოდ უწევს წარსული გააქტიურებების მეხსიერებიდან გადაგდება, როდესაც ქეშირებული გააქტიურებების რაოდენობა `n_m`-ს აღემატება.
კომპრესორული ტრანსფორმერი (Compressive Transformer) ამ პრობლემას აგვარებს დამატებითი შეკუმშული მეხსიერების დამატებით, რათა ეფექტურად დააქეშიროს წარსული გააქტიურებები, რომლებიც სხვა შემთხვევაში საბოლოოდ გადაიყრებოდა. ამ გზით მოდელს შეუძლია ისწავლოს უკეთესი შორს მიმავალი თანმიმდევრობის დამოკიდებულებები, რადგანაც მას აქვს წვდომა მნიშვნელოვნად მეტ წარსულ გააქტიურებაზე. შეკუმშვის ფაქტორი `c` (ილუსტრაციაში 3-ის ტოლია) არჩეულია იმისთვის, რომ გადაწყვიტოს, რა სიჩქარით შეკუმშონ წარსული გააქტიურებები. ავტორები ექსპერიმენტებს ატარებენ სხვადასხვა შეკუმშვის ფუნქციებით, როგორიცაა მაქს/საშუალო პულინგი (პარამეტრების გარეშე) და 1D კონვოლუცია (საწვრთნელი ფენა). შეკუმშვის ფუნქცია წვრთნის უკუ-გავრცელებით დროის განმავლობაში ან ლოკალური დამხმარე შეკუმშვის დანაკარგებით. `n` სიგრძის მიმდინარე შეყვანის გარდა, მოდელი ყურადღებას აქცევს `n_m` ქეშირებულ გააქტიურებას რეგულარულ მეხსიერებაში და `n_cm` შეკუმშული მეხსიერების გააქტიურებას, რაც იძლევა ხანგრძლივ დროით დამოკიდებულებას `l × (n_m + c n_cm)`-ის ტოლი, სადაც `l` არის ყურადღების ფენების რაოდენობა. ეს ზრდის Transformer-XL-ის დიაპაზონს დამატებითი `l × c × n_cm` ტოკენებით და მეხსიერების ხარჯი შეადგენს O(n² + n n_m + n n_cm)-ს. ექსპერიმენტები ტარდება განმტკიცებით სწავლაზე, აუდიოს გენერაციაზე და ბუნებრივი ენის დამუშავებაზე. ავტორები ასევე წარმოადგენენ ახალ შორს მიმავალი ენის მოდელირების ბენჩმარკს სახელწოდებით PG19.
სინონ ვანგი, ბელინდა ზ. ლი, მადიან ხაბსა, ჰან ფანგი, ჰაო მა - მიზანია თვით-ყურადღების სირთულის შემცირება თანმიმდევრობის სიგრძე `n`-სთან მიმართებაში კვადრატულიდან ხაზოვანზე. ეს ნაშრომი აღნიშნავს, რომ ყურადღების მატრიცები დაბალი რანგისაა (ანუ ისინი არ შეიცავენ `n × n` მოცულობის ინფორმაციას) და იკვლევს მაღალგანზომილებიანი მონაცემთა შეკუმშვის ტექნიკების გამოყენების შესაძლებლობას უფრო მეხსიერება-ეფექტური ტრანსფორმერების შესაქმნელად.
თეგები:
#ხელოვნური ინტელექტი
#კვლევა
#მანქანური სწავლება
#ეფექტურობა
#ტრანსფორმერები
#ღრმა სწავლება
#nlp
#შორს მიმავალი ყურადღება
წყარო: huggingface.co
AI-ით გადამუშავებული
მსგავსი სტატიები

ხელოვნური ინტელექტი და მანქანური სწავლება
Hugging Face Optimum და Graphcore IPU-ები: ViT მოდელების ეფექტური დახვეწა
ხელოვნური ინტელექტი და მანქანური სწავლება
Megatron-LM: დიდი ტრანსფორმერული მოდელების ოპტიმიზებული წვრთნა NVIDIA GPU-ებზე

AI