ტრანსფორმერების ეფექტურობის გამოწვევები: შორს მიმავალი ყურადღება და მეხსიერების ოპტიმიზაცია
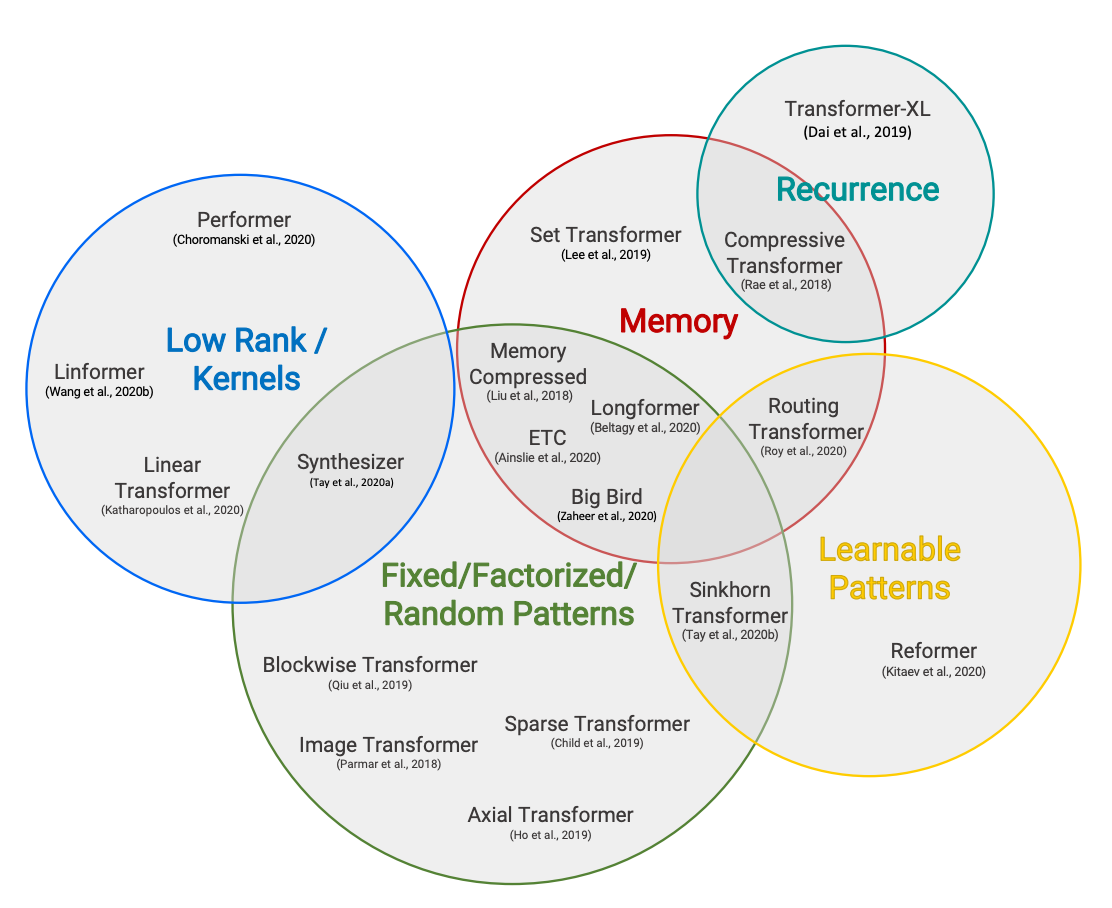
დიდი ტრანსფორმერების მოდელების გამოთვლითი მოთხოვნების შემცირება კვლევის ერთ-ერთი მთავარი მიმართულებაა, განსაკუთრებით თანმიმდევრობის სიგრძესთან დაკავშირებული კვადრატული დანახარჯის პრობლემის გამო. სტატია განიხილავს ოთხ ძირითად მიდგომას ამ გამოწვევის მოსაგვარებლად: Longformer, Transformer-XL, Compressive Transformer და დაბალი რანგის ყურადღების მატრიცების გამოყენება, რომლებიც მიზნად ისახავს მოდელების მეხსიერებისა და დროის ეფექტურობის გაუმჯობესებას გრძელი თანმიმდევრობების დამუშავებისას.

Hugging Face Optimum და Graphcore IPU-ები: ViT მოდელების ეფექტური დახვეწა
ეს ბლოგ-პოსტი აღწერს, თუ როგორ მარტივად შეიძლება წინასწარ გაწვრთნილი ტრანსფორმერული მოდელების, კერძოდ Vision Transformer (ViT) არქიტექტურის, დახვეწა Graphcore Intelligence Processing Units (IPU)-ზე Hugging Face Optimum ბიბლიოთეკის გამოყენებით. სტატია მოიცავს ViT-ის არქიტექტურას, მის უპირატესობებს კონვოლუციურ ნერვულ ქსელებთან (CNNs) შედარებით კომპიუტერულ ხედვაში, გამოყენების სფეროებს, განსაკუთრებით ჯანდაცვაში, და ხაზს უსვამს IPU-ების მიერ შეთავაზებულ ეფექტურობას.
Megatron-LM: დიდი ტრანსფორმერული მოდელების ოპტიმიზებული წვრთნა NVIDIA GPU-ებზე
ეს სტატია განიხილავს Megatron-LM-ს, NVIDIA-ს მძლავრ ფრეიმვორკს დიდი ტრანსფორმერული მოდელების წინა-წვრთნისთვის. მიუხედავად იმისა, რომ ის დამწყებთათვის შეიძლება რთული იყოს, Megatron-LM უაღრესად ოპტიმიზებულია GPU-ებზე წვრთნისთვის და გვთავაზობს მნიშვნელოვან აჩქარებას ისეთი მექანიზმების წყალობით, როგორიცაა ეფექტური DataLoader, Kernel Fusion და Fused AdamW. სტატიაში მოცემულია დეტალური გზამკვლევი GPT2 მოდელის წვრთნისთვის, მათ შორის გარემოს დაყენება, მონაცემთა წინასწარი დამუშავება და წვრთნის პარამეტრები