
Hugging Face Optimum და Graphcore IPU-ები: ViT მოდელების ეფექტური დახვეწა
ეს ბლოგ-პოსტი აღწერს, თუ როგორ მარტივად შეიძლება წინასწარ გაწვრთნილი ტრანსფორმერული მოდელების, კერძოდ Vision Transformer (ViT) არქიტექტურის, დახვეწა Graphcore Intelligence Processing Units (IPU)-ზე Hugging Face Optimum ბიბლიოთეკის გამოყენებით. სტატია მოიცავს ViT-ის არქიტექტურას, მის უპირატესობებს კონვოლუციურ ნერვულ ქსელებთან (CNNs) შედარებით კომპიუტერულ ხედვაში, გამოყენების სფეროებს, განსაკუთრებით ჯანდაცვაში, და ხაზს უსვამს IPU-ების მიერ შეთავაზებულ ეფექტურობას.
ეს ბლოგ-პოსტი აჩვენებს, თუ რამდენად მარტივია წინასწარ გაწვრთნილი ტრანსფორმერული მოდელების დახვეწა თქვენი მონაცემთა ნაკრებისთვის Graphcore Intelligence Processing Units (IPU)-ზე Hugging Face Optimum ბიბლიოთეკის გამოყენებით. მაგალითად, ჩვენ წარმოგიდგენთ ნაბიჯ-ნაბიჯ სახელმძღვანელოს და მოვაწოდებთ ნოუთბუქს, რომელიც იყენებს გულმკერდის რენტგენის გამოსახულებების დიდ, ფართოდ გამოყენებულ მონაცემთა ნაკრებს და წვრთნის ვიზუალურ ტრანსფორმერულ (ViT) მოდელს.
2017 წელს Google AI-ის მკვლევართა ჯგუფმა გამოაქვეყნა ნაშრომი, რომელშიც წარმოდგენილი იყო ტრანსფორმერული მოდელის არქიტექტურა. თავისი ინოვაციური თვითყურადღების მექანიზმით, ტრანსფორმერები შემოთავაზებული იქნა, როგორც ახალი და ეფექტური მოდელების ჯგუფი ენის დამუშავების ამოცანებისთვის. მართლაც, ბოლო ხუთი წლის განმავლობაში, ტრანსფორმერებმა საოცარი პოპულარობა მოიპოვეს და ახლა ბუნებრივი ენის დამუშავების (NLP) დე ფაქტო სტანდარტად არის მიღებული. ენის დამუშავებისთვის განკუთვნილი ტრანსფორმერები, ალბათ, ყველაზე მეტად წარმოდგენილია სწრაფად განვითარებადი GPT და BERT მოდელების ოჯახებით. ორივე მათგანს შეუძლია მარტივად და ეფექტურად იმუშაოს Graphcore IPU-ებზე, როგორც მზარდი Hugging Face Optimum Graphcore ბიბლიოთეკის ნაწილი.
გამორჩეული ტრანსფორმერული ენობრივი მოდელების გამოშვების ქრონოლოგია (კრედიტი: Hugging Face). ტრანსფორმერული მოდელის არქიტექტურის (NLP-ზე ფოკუსირებით) სიღრმისეული ახსნა-განმარტება შეგიძლიათ იხილოთ Hugging Face-ის ვებგვერდზე.
მიუხედავად იმისა, რომ ტრანსფორმერებმა საწყისი წარმატება ენის დამუშავებაში მოიპოვეს, ისინი უკიდურესად მრავალმხრივია და შეიძლება გამოყენებულ იქნას სხვა მრავალი მიზნისთვის, მათ შორის კომპიუტერული ხედვისთვის (CV), რასაც ამ ბლოგ-პოსტში განვიხილავთ. კომპიუტერული ხედვა (CV) არის სფერო, სადაც კონვოლუციური ნერვული ქსელები (CNNs) უდავოდ ყველაზე პოპულარული არქიტექტურაა. თუმცა, ვიზუალური ტრანსფორმერული (ViT) არქიტექტურა, რომელიც პირველად 2021 წელს Google Research-ის ნაშრომში იქნა წარმოდგენილი, გარღვევას წარმოადგენს გამოსახულების ამოცნობაში და იყენებს იმავე თვითყურადღების მექანიზმს, როგორც BERT და GPT, თავის ძირითად კომპონენტად.
მაშინ, როცა BERT და სხვა ტრანსფორმერზე დაფუძნებული ენის დამუშავების მოდელები იღებენ წინადადებას (ანუ სიტყვების სიას) შეტანის სახით, ViT მოდელები შეყვანილ გამოსახულებას ყოფენ რამდენიმე პატარა „პაჩად“ (ნაწილად), რაც ენის დამუშავებაში ცალკეული სიტყვების ეკვივალენტურია. თითოეული „პაჩი“ ტრანსფორმერული მოდელის მიერ ხაზობრივად კოდირდება ვექტორულ წარმოდგენაში, რომელიც შეიძლება ინდივიდუალურად დამუშავდეს. გამოსახულებების „პაჩებად“ ანუ ვიზუალურ ტოკენებად დაყოფის ეს მიდგომა განსხვავდება CNN-ების მიერ გამოყენებული პიქსელური მასივებისგან. წინასწარი წვრთნის წყალობით, ViT მოდელი სწავლობს გამოსახულებების შიდა წარმოდგენას, რომელიც შემდეგ შეიძლება გამოყენებულ იქნას შემდგომი ამოცანებისთვის სასარგებლო ვიზუალური მახასიათებლების ამოსაღებად. მაგალითად, შეგიძლიათ გაწვრთნათ კლასიფიკატორი მარკირებული გამოსახულებების ახალ მონაცემთა ნაკრებზე, წინასწარ გაწვრთნილი ვიზუალური ენკოდერის თავზე ხაზოვანი ფენის განთავსებით. როგორც წესი, ხაზოვან ფენას [CLS] ტოკენის თავზე ათავსებენ, რადგან ამ ტოკენის ბოლო ფარული მდგომარეობა შეიძლება განიხილებოდეს, როგორც მთლიანი გამოსახულების წარმოდგენა.
ViT მოდელის სტრუქტურის მიმოხილვა, როგორც წარმოდგენილია Google Research-ის ორიგინალურ 2021 წლის ნაშრომში. CNN-ებთან შედარებით, ViT მოდელებმა აჩვენეს ამოცნობის უფრო მაღალი სიზუსტე დაბალი გამოთვლითი ხარჯებით და გამოიყენება მრავალი აპლიკაციისთვის, მათ შორის გამოსახულების კლასიფიკაციის, ობიექტების ამოცნობისა და სეგმენტაციისთვის. მხოლოდ ჯანდაცვის სფეროში გამოყენების შემთხვევები მოიცავს COVID-19-ის, ბარძაყის მოტეხილობების, ემფიზემის, ძუძუს კიბოს და ალცჰაიმერის დაავადების აღმოჩენასა და კლასიფიკაციას — მრავალ სხვასთან ერთად.
Graphcore IPU-ები განსაკუთრებით კარგად შეეფერება ViT მოდელებს, მონაცემთა მილსადენისა და მოდელის პარალელიზმის კომბინაციის გამოყენებით წვრთნის პარალელიზაციის უნარის გამო. ამ მასიურად პარალელური პროცესის აჩქარება შესაძლებელია IPU-ის MIMD არქიტექტურით და მისი მასშტაბირების გადაწყვეტილებით, რომელიც ორიენტირებულია IPU-Fabric-ზე. მილსადენის პარალელიზმის შემოღებით, იზრდება მონაცემთა პარალელიზმის თითოეული ინსტანციისთვის დასამუშავებელი პაკეტის ზომა, უმჯობესდება ერთი IPU-ს მიერ დამუშავებული მეხსიერების არეალის წვდომის ეფექტურობა და მცირდება პარამეტრების აგრეგაციის კომუნიკაციის დრო მონაცემთა პარალელური სწავლისთვის.
ღია კოდის Hugging Face Optimum Graphcore ბიბლიოთეკაში წინასწარ ოპტიმიზებული ტრანსფორმერული მოდელების დამატების წყალობით, წარმოუდგენლად ადვილია მაღალი ხარისხის მუშაობისა და ეფექტურობის მიღწევა IPU-ებზე ViT-ის მსგავსი მოდელების გაშვებისა და დახვეწისას. Hugging Face Optimum-ის მეშვეობით, Graphcore-მა გამოუშვა გამოსაყენებლად მზა IPU-ზე გაწვრთნილი მოდელის ჩექპოინტები და კონფიგურაციის ფაილები, რათა მოდელების მაქსიმალური ეფექტურობით გაწვრთნა მარტივი იყოს. ეს განსაკუთრებით სასარგებლოა, რადგან ViT მოდელები, როგორც წესი, საჭიროებენ წინასწარ წვრთნას დიდი რაოდენობის მონაცემებზე. ეს ინტეგრაცია საშუალებას გაძლევთ გამოიყენოთ ორიგინალური ავტორების მიერ გამოშვებული ჩექპოინტები Hugging Face მოდელის ჰაბის ფარგლებში, ასე რომ თქვენ თავად აღარ მოგიწევთ მათი გაწვრთნა. მომხმარებლებისთვის ნებისმიერი საჯარო მონაცემთა ნაკრების მარტივად გამოყენების შესაძლებლობით, Optimum ამცირებს AI მოდელების განვითარების საერთო სასიცოცხლო ციკლს და უზრუნველყოფს უწყვეტ ინტეგრაციას Graphcore-ის უახლეს აპარატურასთან, რაც აჩქარებს ღირებულების მიღებას.
ამ ბლოგ-პოსტისთვის ჩვენ გამოვიყენებთ ImageNet-21k-ზე წინასწარ გაწვრთნილ ViT მოდელს, რომელიც ეფუძნება ნაშრომს „An Image is Worth 16x16 Words: Transformers for Image Recognition at Scale“ დოსოვიტსკის და სხვების მიერ. მაგალითად, ჩვენ გაჩვენებთ Optimum-ის გამოყენების პროცესს ViT-ის დახვეწისთვის ChestX-ray1-ზე.
თეგები:
#ხელოვნური ინტელექტი
#მანქანური სწავლება
#კომპიუტერული ხედვა
#ჯანდაცვა
#hugging face
#vit
#nlp
#მოდელის დახვეწა
#ტრანსფორმერი
#optimum
#graphcore
#ipu
წყარო: huggingface.co
AI-ით გადამუშავებული
მსგავსი სტატიები
ხელოვნური ინტელექტი და მანქანური სწავლება
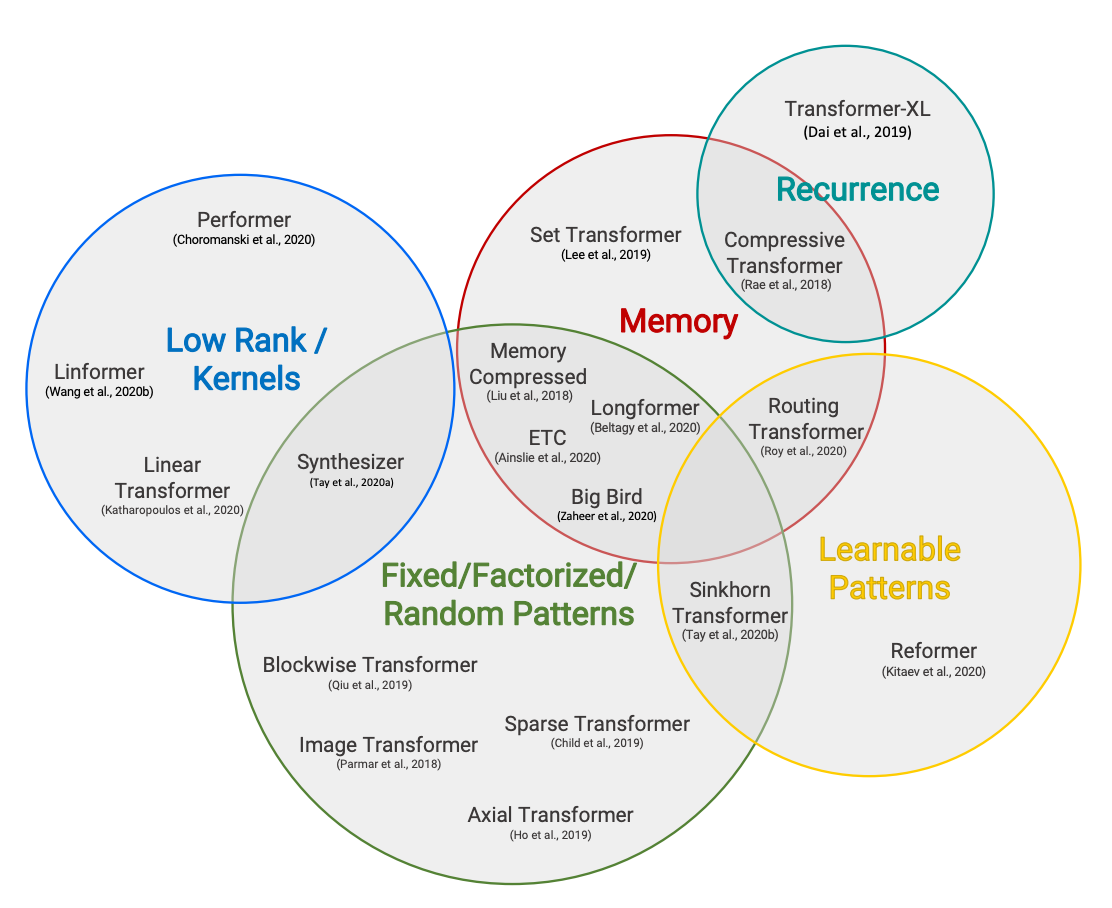
ტრანსფორმერების ეფექტურობის გამოწვევები: შორს მიმავალი ყურადღება და მეხსიერების ოპტიმიზაცია
ხელოვნური ინტელექტი და მანქანური სწავლება
Megatron-LM: დიდი ტრანსფორმერული მოდელების ოპტიმიზებული წვრთნა NVIDIA GPU-ებზე

AI