Habana Gaudi2-ის რეკორდული სისწრაფე BridgeTower-ის დახვეწისას: A100-ზე 2.5-ჯერ, H100-ზე 1.4-ჯერ სწრაფი
უახლესი კვლევის მიხედვით, Habana Gaudi2-ზე Optimum Habana v1.7-ის გამოყენებით, შესაძლებელია BridgeTower ხედვა-ენის მოდელის დახვეწის პროცესის მნიშვნელოვნად დაჩქარება. ეს მიღწევა, რომელიც A100-თან შედარებით 2.5-ჯერ, ხოლო H100-თან შედარებით 1.4-ჯერ ზრდის სისწრაფეს, ეფუძნება აპარატურულად აჩქარებულ მონაცემთა ჩატვირთვას. ეს ტექნიკები ნებისმიერ სხვა სამუშაო დატვირთვასაც ესადაგება, სადაც მონაცემთა ჩატვირთვა წარმოადგენს შეფერხებას, რაც ხედვის მოდელებისთვის ხშირია.
Bark TTS მოდელის ოპტიმიზაცია Hugging Face ეკოსისტემით: მეხსიერება და ინფერენსის გაუმჯობესება
ეს სტატია წარმოგიდგენთ 'Bark' ტექსტიდან მეტყველებად გარდამქმნელი (TTS) მოდელის ოპტიმიზაციის პრაქტიკულ სახელმძღვანელოს Hugging Face-ის 'Transformers', 'Optimum' და 'Accelerate' ბიბლიოთეკების გამოყენებით. დეტალურად განიხილება მეხსიერების მოხმარების შემცირებისა და ინფერენსის სიჩქარის გაუმჯობესების სამი მარტივი მეთოდი, მათ შორის 'Better Transformer' და 'Flash Attention'. ასევე ნაჩვენებია ოპტიმიზებული და არაოპტიმიზებული მოდელების წარმადობის შედარებისა და ბენჩმარკინგის პროცესი.
ტრანსფორმერული მოდელები წარმოებაში: გამოწვევები და Optimum-ის გადაწყვეტა
ტრანსფორმერული მოდელები, რომლებიც თანამედროვე ხელოვნური ინტელექტის განუყოფელი ნაწილია, ფართოდ გამოიყენება ტექნოლოგიური გიგანტების მიერ ისეთ სფეროებში, როგორიცაა ავტოპილოტი, ენის დამუშავება და ვიზუალური ამოცნობა. თუმცა, ამ მასიური მოდელების ეფექტურად წარმოებაში დანერგვა სერიოზულ გამოწვევებს აწყდება, განსაკუთრებით იმ გუნდებისთვის, რომლებსაც არ გააჩნიათ შეუზღუდავი რესურსები. Hugging Face-ის ახალი ღია კოდის ბიბლიოთეკა Optimum, Intel® Neural Compressor-თან თანამშრომლობით, მიზნად ისახავს ამ პროცესის გ
Transformer მოდელების აჩქარება Graphcore IPU-ებზე Hugging Face Optimum-ით
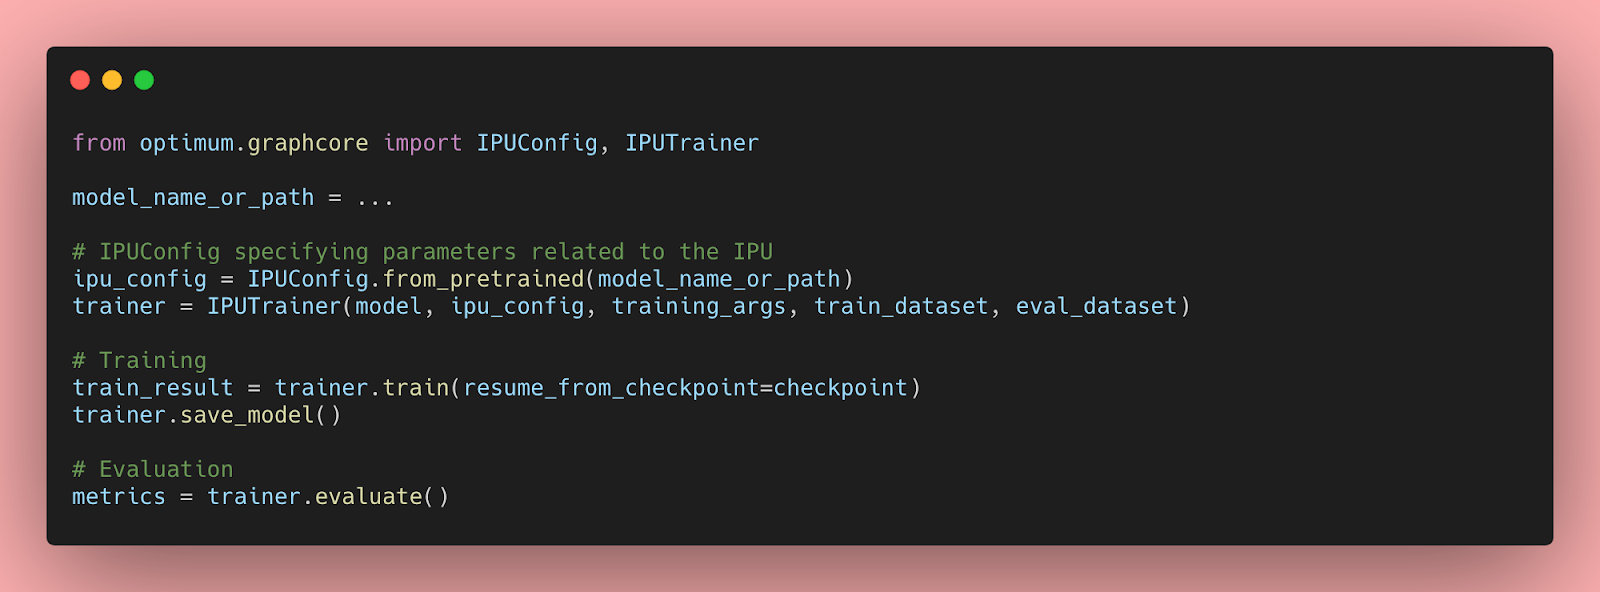
Hugging Face-მა წარმოადგინა Optimum, ღია კოდის ბიბლიოთეკა, რომელიც ამარტივებს Transformer მოდელების პროგნოზირების შეყოვნების შემცირებას სხვადასხვა აპარატურულ პლატფორმაზე. Graphcore-სა და Hugging Face-ის პარტნიორობის ფარგლებში, ახლა წარმოდგენილია BERT, როგორც პირველი IPU-ზე ოპტიმიზებული მოდელი, რომელიც განკუთვნილია Graphcore-ის ინტელექტუალური დამუშავების ერთეულისთვის (IPU). ეს სტატია დეტალურად აღწერს, თუ როგორ გამოიყენოთ Optimum და IPU-ები BERT მოდელების მარტივად გასაწვრთნელად და დასაჩქარებლად, მ
Hugging Face Optimum და Graphcore IPU: Transformer მოდელების აჩქარება
Hugging Face-მა წარმოადგინა Optimum, ღია კოდის ბიბლიოთეკა, რომელიც ამარტივებს Transformer მოდელების პროგნოზირების შეყოვნების შემცირებას სხვადასხვა აპარატურულ პლატფორმაზე. ეს ბლოგპოსტი გვიჩვენებს, თუ როგორ შეიძლება Transformer მოდელების დაჩქარება Graphcore Intelligence Processing Unit (IPU)-სთვის, რომელიც ხელოვნური ინტელექტის დატვირთვებისთვის შექმნილი მოქნილი პროცესორია. Graphcore-სა და Hugging Face-ს შორის პარტნიორობის ფარგლებში, BERT პირველი IPU-სთვის ოპტიმიზებული მოდელია. სტატია დეტალურად აღწე
Llama 2-ის ეფექტური განთავსება AWS Inferentia2-ზე Hugging Face Optimum Neuron-ის მეშვეობით
Hugging Face-ის ბლოგზე ადრე წარდგენილი AWS Inferentia2-ის გაფართოების შედეგად, ახლა შესაძლებელია დიდი ენობრივი მოდელების (LLM) განთავსება ტექსტის გენერაციისთვის AWS Inferentia2 ინსტანციებზე Optimum Neuron-ის გამოყენებით. სტატია დეტალურად აღწერს Llama 2-ის განთავსების პროცესს, გთავაზობთ რეკომენდაციებს Hugging Face Neuron Deep Learning AMI-ზე ან Amazon SageMaker-ზე განთავსების შესახებ და განმარტავს მოდელების კომპილაციასა და ექსპორტს. ასევე, მოცემულია Inferentia2-ზე ტექსტის გენერაციის ეფექტურობის ა

Optimum-NVIDIA: LLM-ის ინფერენსის რევოლუციური აჩქარება NVIDIA პლატფორმაზე
Hugging Face-ის Optimum-NVIDIA ბიბლიოთეკა მნიშვნელოვნად აჩქარებს დიდი ენობრივი მოდელების (LLM) ინფერენსს NVIDIA პლატფორმაზე, კოდის მხოლოდ ერთი ხაზის შეცვლით 28-ჯერ უფრო სწრაფ მუშაობას და 1,200 ტოკენს/წამში სიჩქარეს უზრუნველყოფს. ის პირველი Hugging Face ბიბლიოთეკაა, რომელიც სარგებლობს ახალი float8 (FP8) ფორმატით, რაც კიდევ უფრო აუმჯობესებს გამტარუნარიანობას და ამცირებს პირველი ტოკენის ლატენტურობას, რაც საშუალებას იძლევა, უფრო დიდი მოდელები ერთ GPU-ზე გაეშვას სიზუსტის დაკარგვის გარეშე. აღნიშნული ტ
Habana Labs და Hugging Face-ი თანამშრომლობენ ტრანსფორმერული მოდელების ტრენინგის დასაჩქარებლად
Habana Labs, ღრმა სწავლის პროცესორების პიონერი, და Hugging Face, ტრანსფორმერული მოდელების ცენტრალური პლატფორმა, აცხადებენ პარტნიორობის შესახებ, რომლის მიზანია მაღალი ხარისხის ტრანსფორმერული მოდელების სწავლების პროცესის გამარტივება, დაჩქარება და გაიაფება. Habana-ს SynapseAI პროგრამული პაკეტის Hugging Face Optimum-ის ღია კოდის ბიბლიოთეკასთან ინტეგრაცია საშუალებას მისცემს მონაცემთა მეცნიერებსა და მანქანური სწავლების ინჟინრებს, ეფექტურად გამოიყენონ Habana Gaudi პროცესორები, შეამცირონ ხარჯები და გაზა
Hugging Face Optimum: ტრანსფორმერების მოდელების ტრენინგისა და ინფერენსის დაჩქარება
BERT-ისა და Transformer-ის მოდელების გამოყენება სულ უფრო იზრდება სხვადასხვა სფეროში, თუმცა ისინი ხშირად ნელი და მოცულობითია. Hugging Face-მა შექმნა Optimum – გაფართოება, რომელიც ამ მოდელების ტრენინგსა და ინფერენსს აჩქარებს. Optimum უზრუნველყოფს ოპტიმიზებულ შესრულებას დაჩქარებულ აპარატურაზე, მათ შორის ONNX Runtime-თან ინტეგრაციით, რაც მომხმარებლებს საშუალებას აძლევს მარტივად გადავიდნენ სტანდარტული Transformers API-დან ოპტიმიზებულ ვერსიაზე, მოდელების კვანტიზაციისა და გრაფის ოპტიმიზაციის ჩათვლით.
Hugging Face და AMD აძლიერებენ ხელოვნური ინტელექტის განვითარებას AMD GPU-ებზე
Hugging Face-ი და AMD-ი აცხადებენ მნიშვნელოვან პროგრესს AMD GPU-ებზე დიდი ენობრივი მოდელების (LLM) მხარდაჭერაში, რაც უზრუნველყოფს ტრანსფორმერული მოდელების უწყვეტ გაშვებას კოდის შეცვლის გარეშე. დამატებითი აჩქარების ინსტრუმენტები, როგორიცაა ONNX, Optimum-Benchmark და DeepSpeed, უკვე მხარდაჭერილია. კომპანიები ასევე ხელს უწყობენ დეველოპერებს PC AI კონკურსის ფარგლებში ინოვაციური AI აპლიკაციების შექმნაში AMD Ryzen AI-ით აღჭურვილ კომპიუტერებზე.
Intel-ი Hugging Face-ის აპარატურის პარტნიორთა პროგრამას უერთდება ტრანსფორმერების მოდელების ოპტიმიზაციისთვის
Hugging Face-ის მისიაა მანქანური სწავლების დემოკრატიზაცია და მისი დადებითი გავლენის მაქსიმიზაცია. ამ მიზნით, Intel-ი ოფიციალურად შეუერთდა Hugging Face-ის აპარატურის პარტნიორთა პროგრამას. Optimum-ის ღია კოდის ბიბლიოთეკის წყალობით, Intel-ი და Hugging Face-ი ითანამშრომლებენ უახლესი აპარატურული აჩქარების შესაქმნელად ტრანსფორმერების მოდელების წვრთნის, დაზუსტებისა და პროგნოზირებისთვის. ეს პარტნიორობა მიზნად ისახავს დიდი და კომპლექსური ტრანსფორმერების მოდელების გამოწვევების გადაჭრას, განსაკუთრებით შეყო
Hugging Face Optimum: ტრანსფორმერების მოდელების ოპტიმიზაცია და ONNX-ში ექსპორტი წარმოებისთვის
ეს სახელმძღვანელო დეტალურად აღწერს, თუ როგორ უნდა მოხდეს Transformers მოდელების ექსპორტირება ONNX ფორმატში Hugging Face Optimum ბიბლიოთეკის გამოყენებით, რათა მივაღწიოთ მაქსიმალურ ეფექტურობას წარმოების გარემოში. სტატია განმარტავს ONNX-ის, როგორც ღია სტანდარტის მნიშვნელობას, წარმოგიდგენთ Optimum-ის ფართო შესაძლებლობებს მოდელის ოპტიმიზაციისთვის და იკვლევს კონვერტაციის სხვადასხვა მეთოდს, მარტივი API-დან მოწინავე ფუნქციონალამდე.

Xeon პროცესორებზე წარმადობის მნიშვნელოვანი ზრდა ჩაშენებული მოდელების ოპტიმიზაციით Optimum Intel-ისა და fastRAG-ის გამოყენებით
ეს ბლოგი დეტალურად აღწერს, თუ როგორ მივაღწიოთ წარმადობის მნიშვნელოვან ზრდას Intel Xeon-ზე დაფუძნებულ CPU-ებზე, ოპტიმიზებული ჩაშენების (embedding) მოდელების ინტეგრირებით არსებულ RAG კონვეიერებში fastRAG-ის გამოყენებით. განხილულია Optimum Intel ბიბლიოთეკის როლი მოდელების დასაჩქარებლად, ისეთი ტექნიკების გამოყენებით, როგორიცაა დაბალბიტიანი კვანტიზაცია და Intel-ის სპეციფიკური გაფართოებების (AVX-512, VNNI, AMX) გამოყენება. სტატია ყურადღებას ამახვილებს BGE მოდელებზე და წარმოგიდგენთ ნაბიჯ-ნაბიჯ სახელმძღ
წარდგენა Quanto-სი: PyTorch-ის კვანტიზაციის ახალი ბეკენდი ხელოვნური ინტელექტის მოდელების ეფექტურობისთვის
Hugging Face წარმოგიდგენთ „quanto“-ს, PyTorch-ის კვანტიზაციის ახალ ბეკენდს Optimum-ისთვის, რომელიც შექმნილია ღრმა სწავლების მოდელების კვანტიზაციის გასამარტივებლად და სტანდარტიზებისთვის. Quanto მიზნად ისახავს მსხვილი ენობრივი მოდელების (LLM) უფრო ეფექტურს გახადოს სამომხმარებლო მოწყობილობებისთვის მეხსიერების შემცირებით და სპეციალიზებული აპარატურის ოპტიმიზაციების ჩართვით, გთავაზობთ მრავალმხრივ და მოწყობილობისგან დამოუკიდებელ გადაწყვეტას.
SetFit-ის მოდელების ოპტიმიზაცია Intel CPU-ებზე: 7.8-ჯერ უფრო სწრაფი ინფერენცია
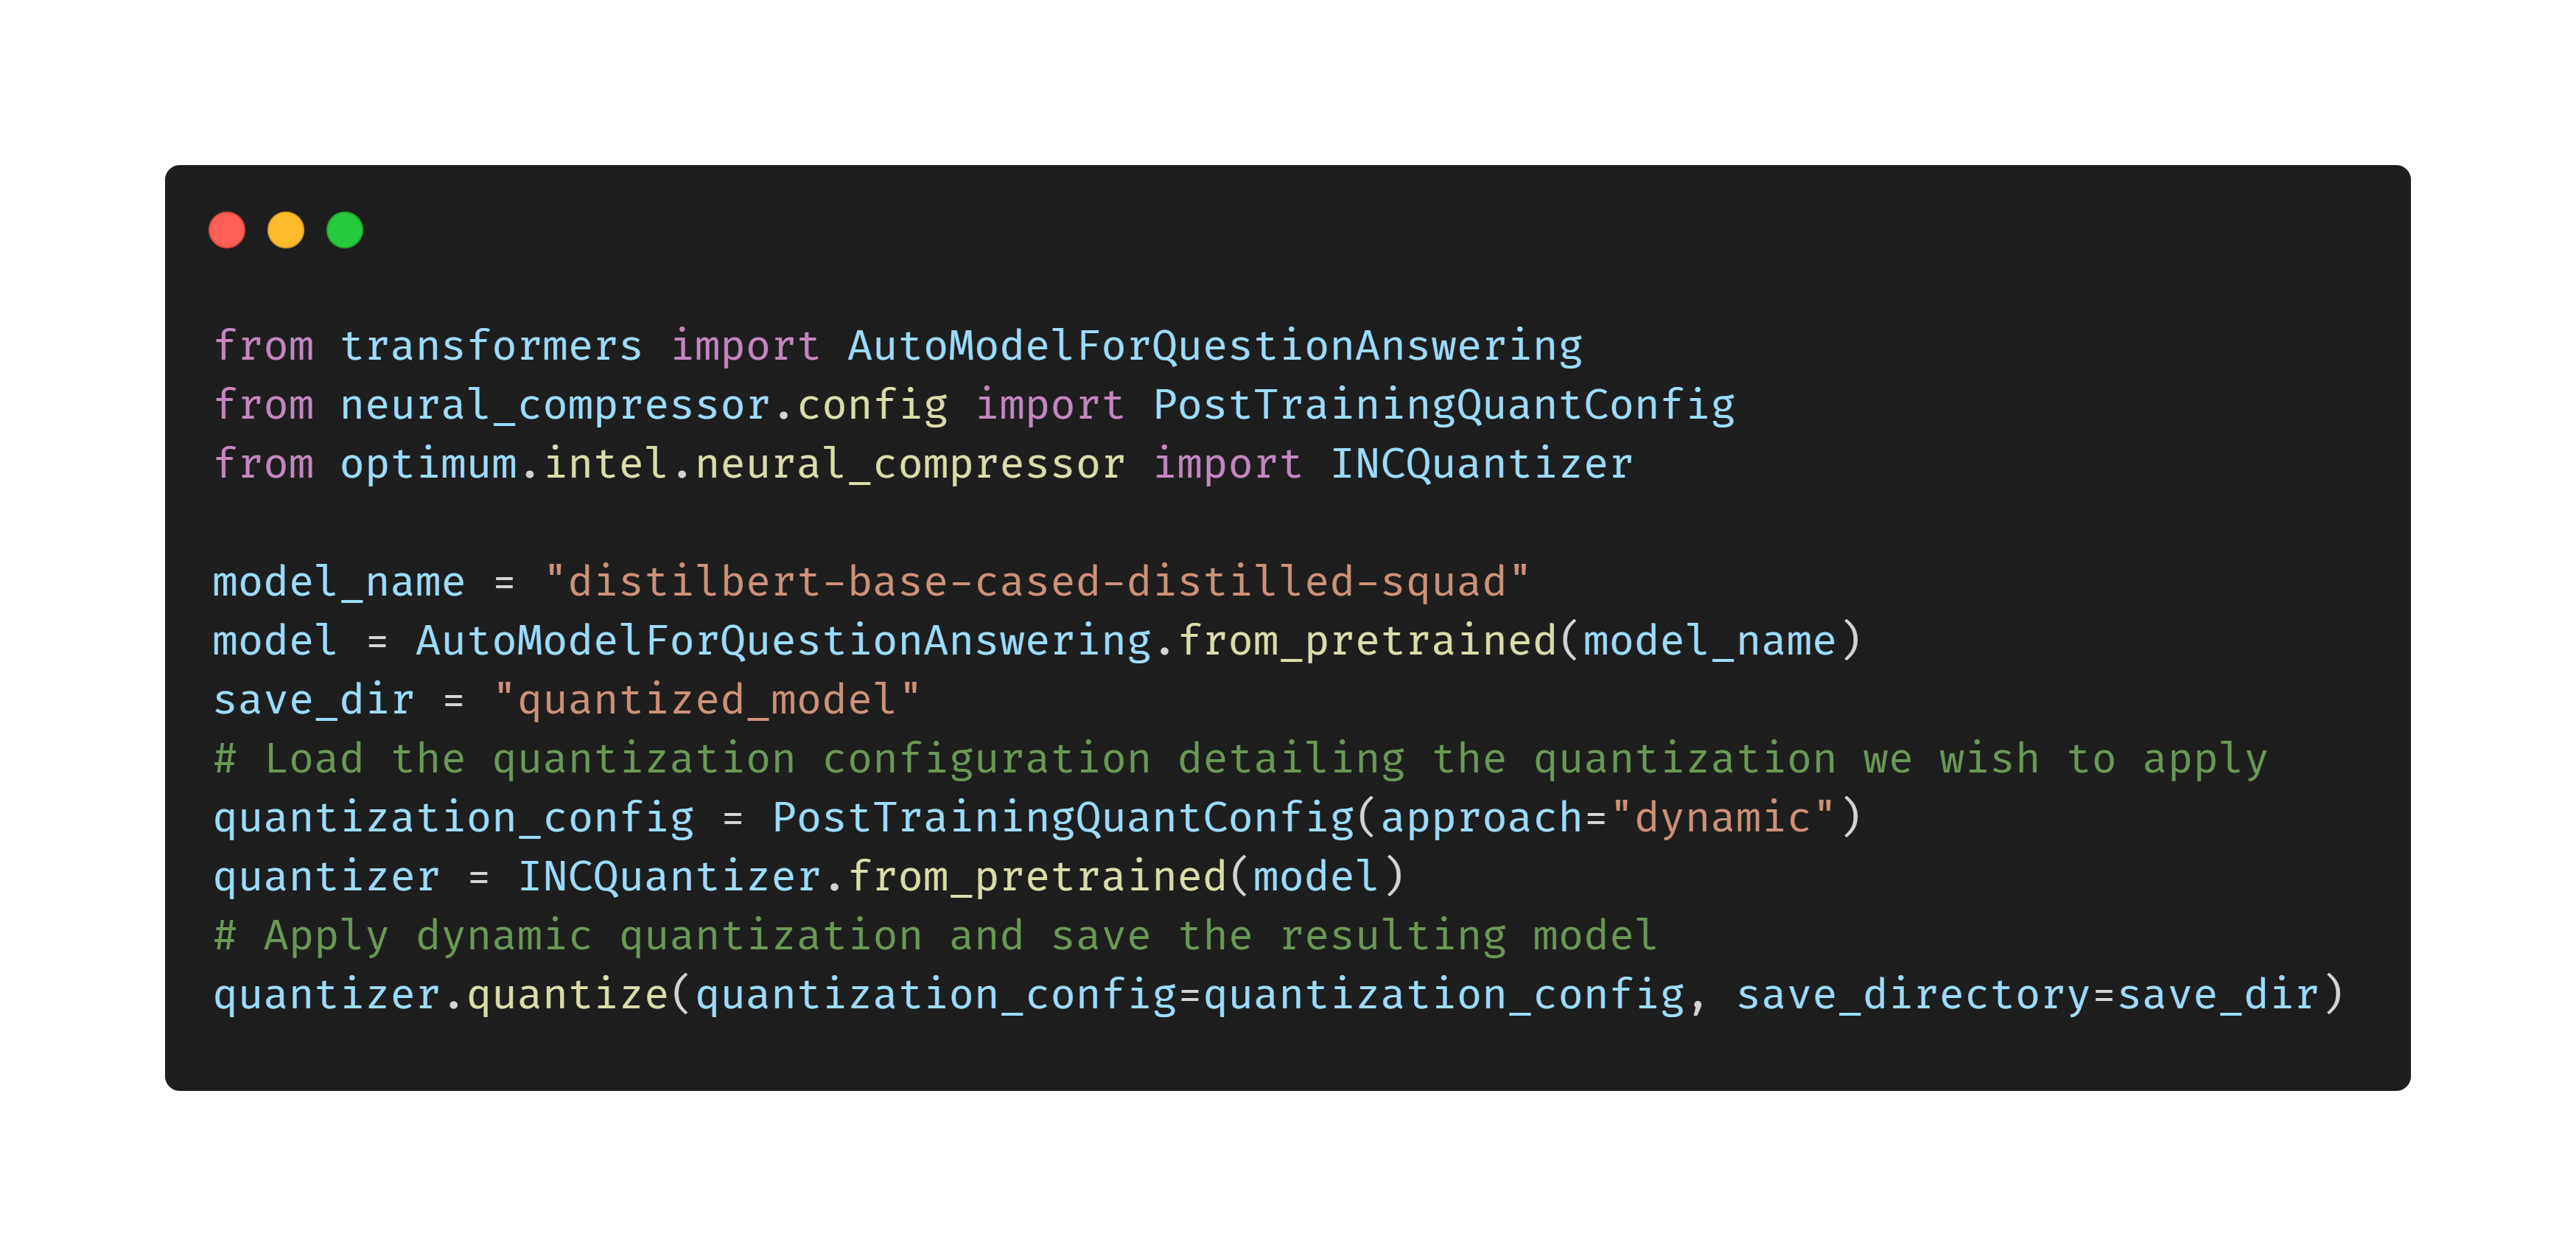
SetFit მაღალ სიზუსტეს აღწევს მცირე მარკირებული მონაცემებით, აჭარბებს GPT-3.5-ს და GPT-4-საც კი, და გამოირჩევა LLM-ზე დაფუძნებული მეთოდებისგან პრომპტების არარსებობითა და ვარჯიშის სისწრაფით. ეს სტატია განმარტავს, თუ როგორ შეიძლება SetFit-ის ინფერენციის დაჩქარება 7.8-ჯერ Intel-ის პროცესორებზე Optimum Intel-ის ბიბლიოთეკისა და ვარჯიშის შემდგომი კვანტიზაციის გამოყენებით. განხილულია Optimum Intel-ის ტექნიკური უპირატესობები, კვანტიზაციის მექანიზმები და მოცემულია პრაქტიკული ნაბიჯები მოდელის ოპტიმიზაციისა
SetFit-ის ინფერენციის 7.8-ჯერ დაჩქარება Intel CPU-ებზე Optimum Intel-ის გამოყენებით
SetFit, ხელოვნური ინტელექტის მოდელი, რომელიც ცნობილია მცირე მარკირებული მონაცემებით მაღალი სიზუსტის მიღწევით, ახლა შესაძლებელია Intel CPU-ებზე 7.8-ჯერ უფრო სწრაფად ამუშავდეს. ეს მიიღწევა 🤗 Optimum Intel-ის ბიბლიოთეკის გამოყენებით და პოსტ-ტრენინგული კვანტიზაციით, რაც SetFit-ის გადაწყვეტილებების წარმოებაში დანერგვას საგრძნობლად აადვილებს და გამტარუნარიანობას ზრდის.

Hugging Face Optimum და Graphcore IPU-ები: ViT მოდელების ეფექტური დახვეწა
ეს ბლოგ-პოსტი აღწერს, თუ როგორ მარტივად შეიძლება წინასწარ გაწვრთნილი ტრანსფორმერული მოდელების, კერძოდ Vision Transformer (ViT) არქიტექტურის, დახვეწა Graphcore Intelligence Processing Units (IPU)-ზე Hugging Face Optimum ბიბლიოთეკის გამოყენებით. სტატია მოიცავს ViT-ის არქიტექტურას, მის უპირატესობებს კონვოლუციურ ნერვულ ქსელებთან (CNNs) შედარებით კომპიუტერულ ხედვაში, გამოყენების სფეროებს, განსაკუთრებით ჯანდაცვაში, და ხაზს უსვამს IPU-ების მიერ შეთავაზებულ ეფექტურობას.
ვიზუალური ტრანსფორმერების (ViT) დაზუსტება Graphcore IPU-ებზე Hugging Face Optimum-ის გამოყენებით
ეს ბლოგ-პოსტი გვიჩვენებს, თუ რამდენად მარტივია წინასწარ გაწვრთნილი ტრანსფორმერული მოდელების, კერძოდ, ვიზუალური ტრანსფორმერების (ViT) დაზუსტება Graphcore Intelligence Processing Units (IPU)-ზე Hugging Face Optimum ბიბლიოთეკის გამოყენებით. სტატია მოიცავს დეტალურ სახელმძღვანელოს გულმკერდის რენტგენის მონაცემთა ნაკრების მაგალითზე, განმარტავს ViT არქიტექტურის უპირატესობებს CNN-ებთან შედარებით და ხაზს უსვამს IPU-ების როლს ამ პროცესის ოპტიმიზაციაში სხვადასხვა სფეროში, მათ შორის ჯანდაცვაში.
Intel-ი და Hugging Face-ი Optimum Intel-ში OpenVINO-ს ინტეგრაციას აცხადებენ ტრანსფორმერული მოდელების დასაჩქარებლად
Intel-მა და Hugging Face-მა OpenVINO ინტეგრირეს Optimum Intel-ში, რაც დეველოპერებს საშუალებას აძლევს, მარტივად დააჩქარონ ტრანსფორმერული მოდელები Intel-ის სხვადასხვა პროცესორზე. ეს ინტეგრაცია უზრუნველყოფს ეფექტურ ინფერენსსა და კვანტიზაციას OpenVINO ნერვული ქსელების შეკუმშვის ფრეიმვორკის (NNCF) გამოყენებით, მნიშვნელოვნად ამცირებს მოდელის ზომასა და შეყოვნებას სიზუსტის მინიმალური დაკარგვით.
Intel-ი და Hugging Face-ი OpenVINO-ს Optimum Intel-ში აერთიანებენ AI მოდელების დასაჩქარებლად
Intel-მა და Hugging Face-მა გამოაცხადეს Intel OpenVINO-ს Optimum Intel-ში ინტეგრაციის შესახებ, რაც ტრანსფორმერული მოდელების სწრაფ და ეფექტურ ინფერენსს შესაძლებელს ხდის Intel-ის პროცესორებზე. სიახლე მოიცავს მოდელების კვანტიზაციას ზომის შემცირებისა და პროგნოზირების დაყოვნების გაუმჯობესებისთვის, ასევე მოცემულია ვიზუალური ტრანსფორმერის (ViT) გამოყენების პრაქტიკული მაგალითი. დეველოპერებს მოუწოდებენ, გამოიკვლიონ ახალი შესაძლებლობები.

AI მოდელების ლოკალური გაშვება: ოპტიმიზაცია Optimum Intel-ით და OpenVINO-თი
AI მოდელების საკუთარ მოწყობილობაზე გაშვება უზრუნველყოფს გაუმჯობესებულ კონფიდენციალურობას, სიჩქარესა და სანდოობას. ეს ბლოგპოსტი აღწერს, თუ როგორ შეიძლება მცირე, ეფექტური მოდელების, როგორიცაა SmolVLM, ოპტიმიზაცია და ლოკალურად გაშვება Optimum Intel-ისა და OpenVINO-ს ინსტრუმენტების გამოყენებით, ძვირადღირებული აპარატურის გარეშე. განხილულია კვანტიზაციის მეთოდები (მხოლოდ წონების კვანტიზაცია და სტატიკური კვანტიზაცია) მეხსიერების მოხმარების შემცირებისა და ინფერენციის დაჩქარების მიზნით. ბენჩმარკები აჩვენე
AI მოდელების ლოკალური ოპტიმიზაცია Intel-ის აპარატურაზე: OpenVINO და Optimum Intel-ის გამოყენებით
ხელოვნური ინტელექტის მოდელების საკუთარ მოწყობილობაზე გაშვება, მიუხედავად მათი გამოთვლითი სირთულისა, მნიშვნელოვან უპირატესობებს გვთავაზობს, მათ შორის გაუმჯობესებულ კონფიდენციალურობასა და სიჩქარეს. ეს სტატია განმარტავს, თუ როგორ შეიძლება მოდელების ოპტიმიზაცია Optimum Intel-ისა და OpenVINO-ს, ასევე მცირე ზომის მოდელების, როგორიცაა SmolVLM, გამოყენებით. ნაბიჯ-ნაბიჯ განხილულია კვანტიზაციის (Weight-only და Static) ტექნიკა, რაც ხელს უწყობს მეხსიერების შემცირებას და ინფერენსის დაჩქარებას, ძვირადღირებული