Hugging Face Transformers-ისა და AWS SageMaker-ის ინტეგრაცია: მარტივი და სწრაფი AI მოდელების ტრენინგი
Hugging Face-ისა და AWS SageMaker-ის გუნდებმა ერთობლივად შექმნეს Transformers-ის ოპტიმიზებული ღრმა სწავლების კონტეინერები, რაც მნიშვნელოვნად აჩქარებს Transformers-ზე დაფუძნებული მოდელების ტრენინგს. ახალი HuggingFace estimator-ის წყალობით SageMaker Python SDK-ში, ტრენინგის დაწყება კოდის ერთი ხაზითაა შესაძლებელი. ეს ინტეგრაცია დეტალურად აღწერილია ბლოგ-პოსტში, რომელიც მოიცავს დაწყების მაგალითებსა და დოკუმენტაციას. სტატია განმარტავს, თუ როგორ ხდება Facebook-ის BART-large-cnn მოდელის დახვეწა Samsum მ

როგორ დავხვეწოთ Llama 2 70B PyTorch FSDP-ის გამოყენებით: საუკეთესო პრაქტიკები და გამოწვევების გადაჭრა
ეს ბლოგპოსტი დეტალურად განიხილავს Llama 2 70B მოდელის დახვეწას PyTorch FSDP-ის გამოყენებით. სტატია ფოკუსირებულია ძირითად გამოწვევებზე, როგორიცაა CPU RAM-ის გადატვირთვა, შუალედური ჩეკპოინტების შენახვის სირთულეები და VRAM-ის მოხმარების ოპტიმიზაცია. წარმოდგენილია გადაწყვეტები Hugging Face Transformers, Accelerate და TRL ინსტრუმენტების მეშვეობით, ასევე განხილულია Accelerate-ის გამოყენება SLURM-თან ერთად. მოცემულია საჭირო რესურსები და კონფიგურაციები შედეგების რეპროდუცირებისთვის.
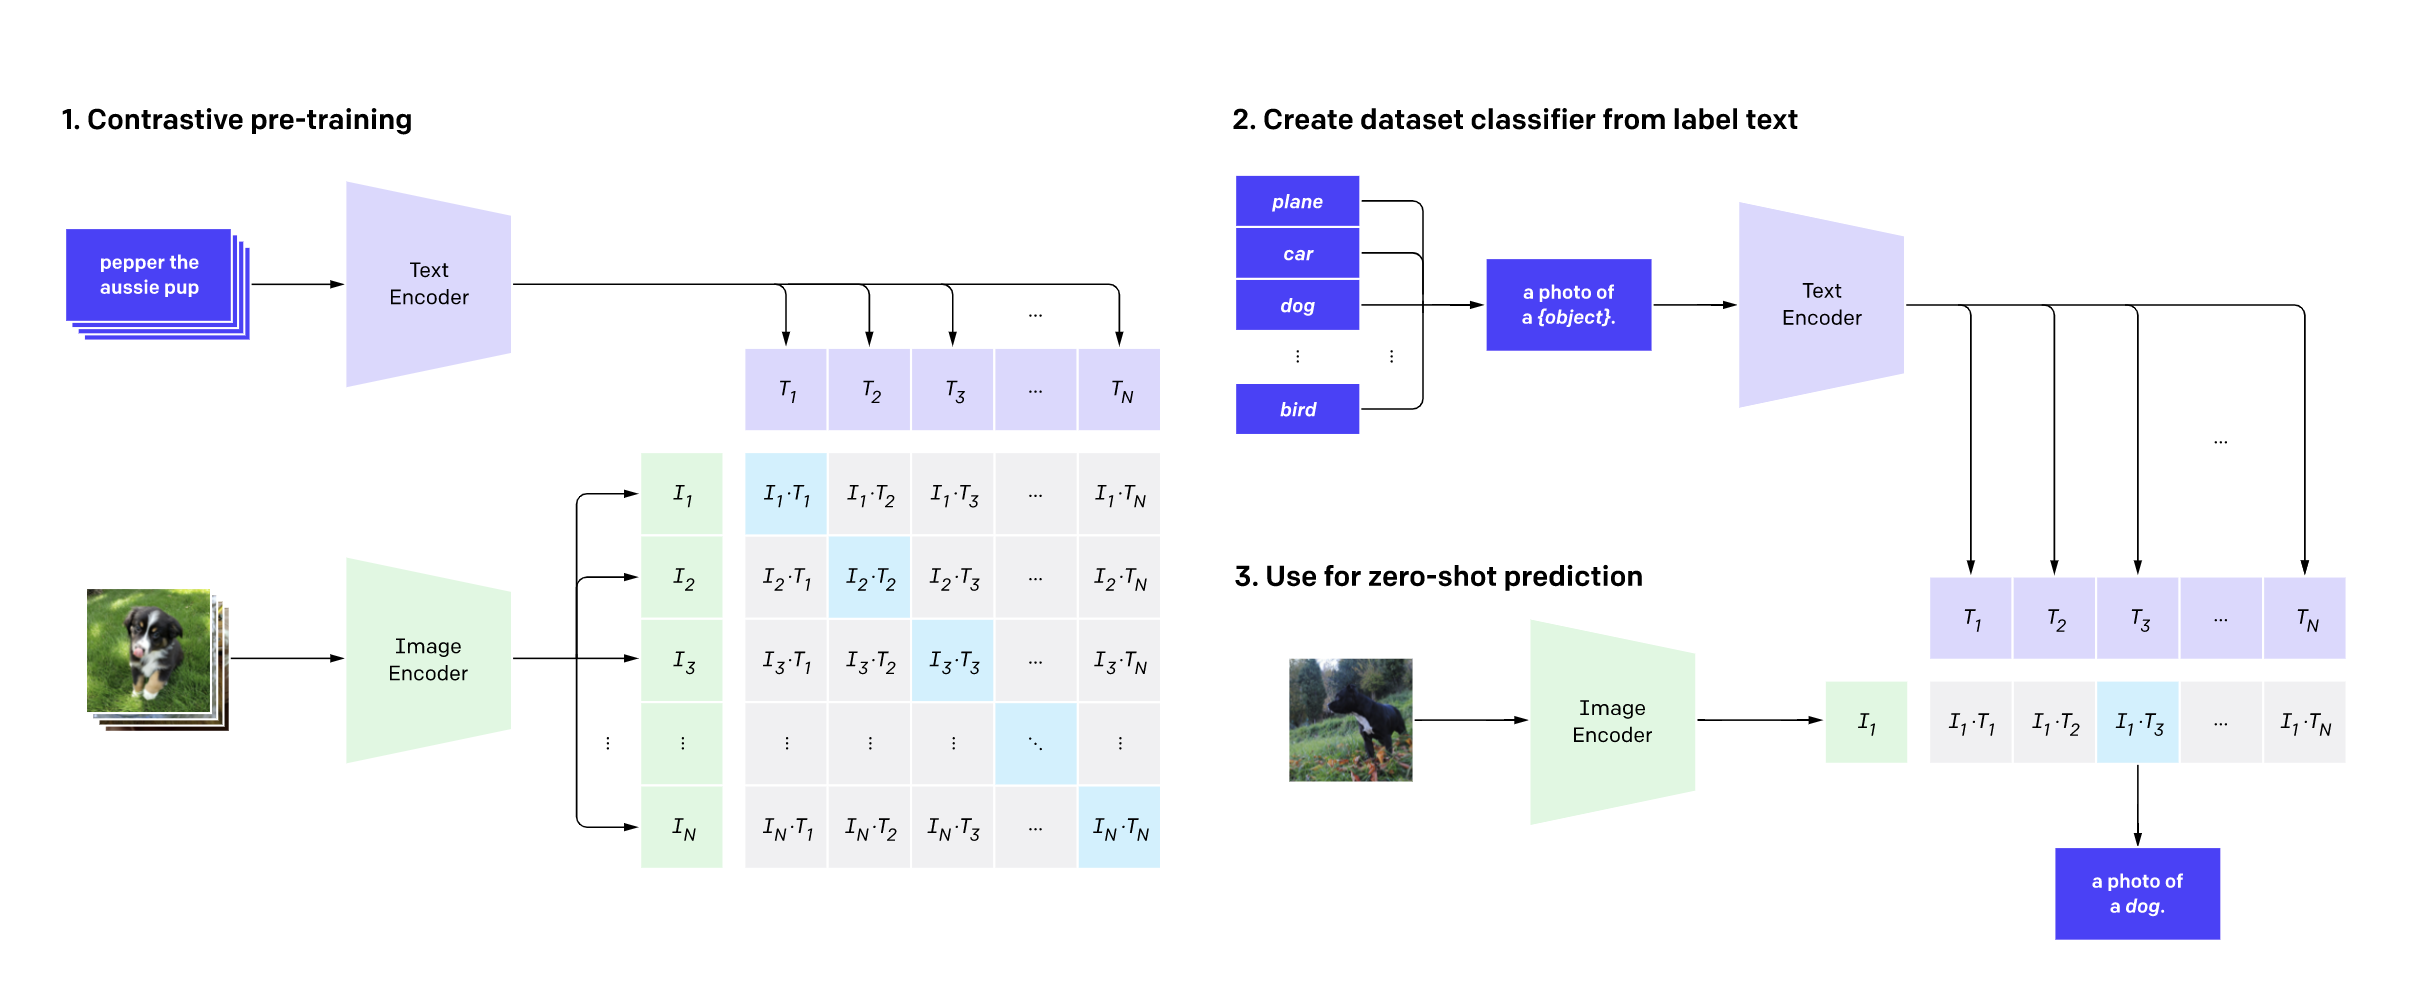
CLIP მოდელის დახვეწა სატელიტური გამოსახულებებისთვის: Hugging Face-ის საზოგადოებრივი კვირეულის პროექტი
მიმდინარე წლის ივლისში Hugging Face-მა მოაწყო Flax/JAX საზოგადოებრივი კვირეული, სადაც მონაწილეებმა გამოიყენეს Tensor Processing Units (TPU) Flax-ისა და JAX-ის საშუალებით, რათა გაეწვრთნათ Hugging Face ტრანსფორმერების მოდელები ბუნებრივი ენის დამუშავებისა და კომპიუტერული ხედვის სფეროებში. ჩვენმა გუნდმა OpenAI-ის CLIP ქსელი დახვეწა RSICD, UCM და სიდნეის მონაცემთა ნაკრებებიდან მიღებული სატელიტური გამოსახულებებითა და აღწერებით. პროექტის მიზანი იყო სატელიტური გამოსახულებების დიდი კოლექციების ტექსტური მ
ფლორენს-2 მოდელის დახვეწა DocVQA ამოცანისთვის: დეტალური მიმოხილვა
სტატიაში განხილულია Florence-2 ხელოვნური ინტელექტის მოდელის დახვეწის პროცესი დოკუმენტების ვიზუალური კითხვა-პასუხის (DocVQA) კონკრეტული ამოცანისთვის. მიუხედავად იმისა, რომ Florence-2 მრავალ ფუნქციას უშუალოდ ასრულებს, ვიზუალური კითხვა-პასუხის (VQA) შესაძლებლობა გამოცემულ მოდელებში არ შედის. ტექსტში აღწერილია მოდელის არქიტექტურა, მისი სიძლიერე უზარმაზარი FLD-5B მონაცემთა ნაკრებიდან, მონაცემთა ნაკრების ავტომატიზებული შექმნის პროცესი და ექსპერიმენტული შედეგები, რომლებიც აჩვენებს მუშაობის მნიშვნელოვან