Hugging Face Transformers-ისა და AWS SageMaker-ის ინტეგრაცია: მარტივი და სწრაფი AI მოდელების ტრენინგი
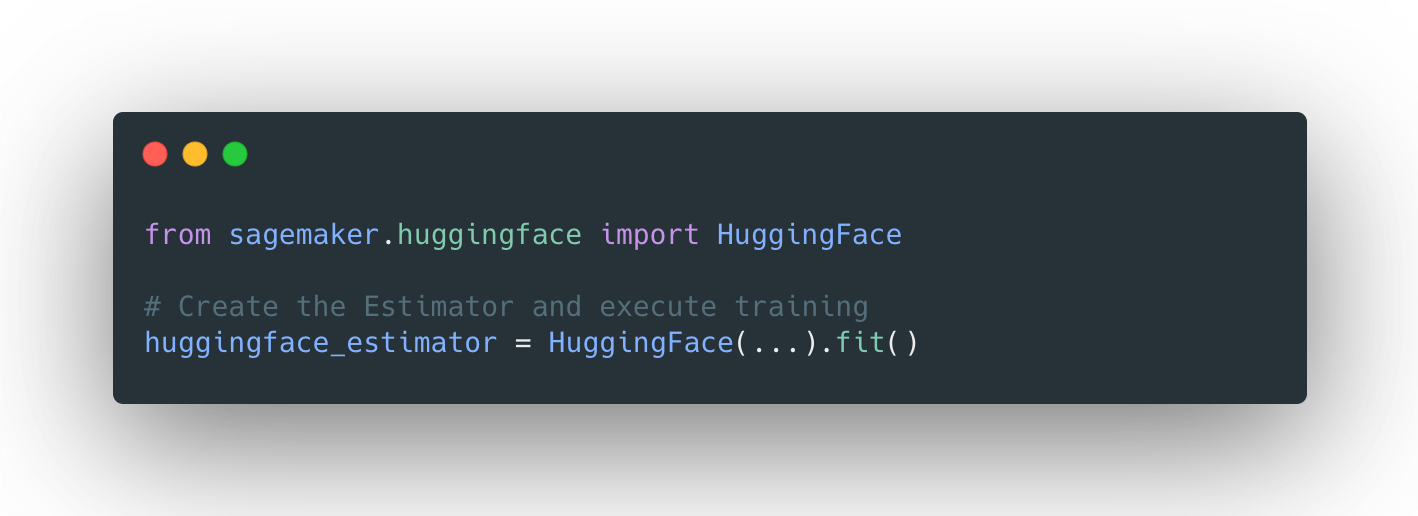
Hugging Face-ისა და AWS SageMaker-ის გუნდებმა ერთობლივად შექმნეს Transformers-ის ოპტიმიზებული ღრმა სწავლების კონტეინერები, რაც მნიშვნელოვნად აჩქარებს Transformers-ზე დაფუძნებული მოდელების ტრენინგს. ახალი HuggingFace estimator-ის წყალობით SageMaker Python SDK-ში, ტრენინგის დაწყება კოდის ერთი ხაზითაა შესაძლებელი. ეს ინტეგრაცია დეტალურად აღწერილია ბლოგ-პოსტში, რომელიც მოიცავს დაწყების მაგალითებსა და დოკუმენტაციას. სტატია განმარტავს, თუ როგორ ხდება Facebook-ის BART-large-cnn მოდელის დახვეწა Samsum მ
SageMaker-ის გუნდთან ერთად, ჩვენ შევქმენით 🤗 Transformers-ის ოპტიმიზებული ღრმა სწავლების კონტეინერები (DLCs), რათა დაგვეჩქარებინა Transformers-ზე დაფუძნებული მოდელების ტრენინგი. მადლობა AWS-ის მეგობრებს!🤗 🚀 SageMaker Python SDK-ში ახალი HuggingFace estimator-ის დახმარებით, ტრენინგის დაწყება კოდის ერთი ხაზითაა შესაძლებელი. ინტეგრაციის შესახებ სრული ინფორმაცია, მათ შორის „პირველი ნაბიჯების“ მაგალითი და ბმულები დოკუმენტაციის, მაგალითებისა და ფუნქციებისკენ, მოცემულია განცხადების ბლოგ-პოსტში, რომელზეც ინფორმაცია ასევე ხელმისაწვდომია აქ:
მათთვის, ვინც არ იცნობს Amazon SageMaker-ს: „Amazon SageMaker არის სრულად მართული სერვისი, რომელიც ყველა დეველოპერსა და მონაცემთა მეცნიერს აძლევს საშუალებას, სწრაფად შექმნას, გაწვრთნას და განათავსოს მანქანური სწავლების (ML) მოდელები. SageMaker ამსუბუქებს მანქანური სწავლების პროცესის ყოველი ეტაპის რთულ ამოცანებს, რაც ხელს უწყობს მაღალი ხარისხის მოდელების შექმნას.“ [REF]
ჩვენ გამოვიყენებთ ახალ Hugging Face DLCs-ს და Amazon SageMaker-ის გაფართოებას, რათა ავაწყოთ განაწილებული Seq2Seq-ტრანსფორმერული მოდელი რეზიუმირების ამოცანისთვის, transformers და datasets ბიბლიოთეკების გამოყენებით, შემდეგ კი ავტვირთავთ მოდელს huggingface.co-ზე და შევამოწმებთ. როგორც განაწილებული ტრენინგის სტრატეგია, ჩვენ გამოვიყენებთ SageMaker Data Parallelism-ს, რომელიც ინტეგრირებულია Trainer API-ში. მონაცემთა პარალელიზმის გამოსაყენებლად, საჭიროა მხოლოდ განაწილების პარამეტრის განსაზღვრა ჩვენს HuggingFace estimator-ში. ამ სახელმძღვანელოში, ტრენინგის სამუშაოს გასაშვებად გამოვიყენებთ Amazon SageMaker Notebook ინსტანციას. თუ როგორ უნდა მოაწყოთ Notebook ინსტანცია, შეგიძლიათ გაიგოთ აქ.
რას გავაკეთებთ: ჩვენ დავხვეწავთ facebook/bart-large-cnn მოდელს samsum მონაცემთა ნაკრებზე. „BART არის „მიმდევრობა-მიმდევრობაზე“ (sequence-to-sequence) მოდელი, რომელიც გაწვრთნილია ხმაურის მოცილებით, როგორც წინასწარი ტრენინგის მიზანი.“ [REF] samsum მონაცემთა ნაკრები შეიცავს დაახლოებით 16 ათას მესენჯერის მსგავს საუბარს რეზიუმეებით.
მას შემდეგ, რაც ჩვენი SageMaker Notebook ინსტანცია ამუშავდება, შეგვიძლია ავირჩიოთ Jupyter Notebook ან JupyterLab და შევქმნათ ახალი Notebook conda_pytorch_p36 ბირთვით. შენიშვნა: Jupyter-ის გამოყენება სავალდებულო არ არის. SageMaker-ის ტრენინგის სამუშაოების გაშვება შესაძლებელია ნებისმიერი ადგილიდან, სადაც დაინსტალირებულია SDK, არის ღრუბელთან კავშირი და შესაბამისი ნებართვები, მაგალითად, ლეპტოპიდან, სხვა IDE-დან ან ამოცანების განრიგის ხელსაწყოდან, როგორიცაა Airflow ან AWS Step Functions. ამის შემდეგ, შეგვიძლია დავაინსტალიროთ საჭირო დამოკიდებულებები, მათ შორის git-lfs მოდელის ატვირთვისთვის. SageMaker-ზე ტრენინგის გასაშვებად, საჭიროა sagemaker Session-ის შექმნა და IAM როლის მიწოდება სწორი ნებართვებით. ეს IAM როლი მოგვიანებით მიმაგრდება TrainingJob-ზე, რაც საშუალებას მისცემს მას მონაცემების ჩამოტვირთვას, მაგალითად, Amazon S3-დან.
🤗 Transformers-ის საცავი შეიცავს რამდენიმე მაგალითს/სკრიპტს მოდელების დახვეწისთვის ამოცანებზე, დაწყებული ენის მოდელირებიდან ტოკენების კლასიფიკაციამდე. ჩვენს შემთხვევაში, ვიყენებთ run_summarization.py-ს seq2seq/ მაგალითებიდან. შენიშვნა: შეგიძლიათ გამოიყენოთ ეს სახელმძღვანელო უცვლელად, რათა გაწვრთნათ თქვენი მოდელი სხვა მაგალითის სკრიპტით. იმის გამო, რომ HuggingFace Estimator-ს ინტეგრირებული აქვს git მხარდაჭერა, ჩვენ შეგვიძლია GitHub საცავში შენახული ტრენინგის სკრიპტი მივუთითოთ როგორც entry_point და source_dir.
ჩვენ გამოვიყენებთ transformers 4.4.2 DLC-ს, რაც ნიშნავს, რომ v4.4.2 უნდა დავაკონფიგურიროთ, როგორც ფილიალი თავსებადი მაგალითის სკრიპტების მოსაზიდად. შემდეგ, განვსაზღვრავთ ჩვენს ჰიპერპარამეტრებს და დავაკონფიგურირებთ განაწილებული ტრენინგის სტრატეგიას. ჰიპერპარამეტრად შეგვიძლია განვსაზღვროთ ნებისმიერი Seq2SeqTrainingArguments და ის პარამეტრები, რომლებიც განსაზღვრულია run_summarization.py-ში. ვინაიდან ვიყენებთ SageMaker Data Parallelism-ს, ჩვენი საერთო ბეტჩის ზომა (total_batch_size) იქნება თითო მოწყობილობაზე ტრენინგის ბეტჩის ზომა (per_device_train_batch_size) * GPU-ების რაოდენობა (n_gpus).
ტრენინგის დაწყებამდე ბოლო ნაბიჯი არის HuggingFace estimator-ის შექმნა. Estimator მართავს Amazon SageMaker-ის მთლიან ტრენინგს (end-to-end). ჩვენ განვსაზღვრავთ, თუ რომელი დახვეწის სკრიპტი უნდა იქნას გამოყენებული როგორც entry_point, რომელი ინსტანციის ტიპი (instance_type) უნდა იქნას გამოყენებული და რომელი ჰიპერპარამეტრები გადაეცემა. ინსტანციის ტიპად ვიყენებთ ml.p3dn.24xlarge-ს, რომელიც შეიცავს 8x NVIDIA A100-ს, ინსტანციების რაოდენობით 2. ეს ნიშნავს, რომ ტრენინგი ჩატარდება 16 GPU-ზე, საერთო ბეტჩის ზომით (total_batch_size) 16*4=64. ჩვენ ვწვრთნით 400 მილიონი პარამეტრის მოდელს საერთო ბეტჩის ზომით 64, რაც უბრალოდ შთამბეჭდავია.
ტრენინგის დასაწყებად ვიძახებთ .fit() მეთოდს. ტრენინგის ხანგრძლივობა წამებში არის 2882, რადგან ის გამრავლებულია ინსტანციების რაოდენობაზე. თუ გამოვთვლით 2882/2=1441, ეს არის დრო „ტრენინგის გამოსახულების ჩამოტვირთვიდან“ „ტრენინგის სამუშაოს დასრულებამდე“. რეალურ ფულად ერთეულში გადაყვანისას, ჩვენი ტრენინგი 16 NVIDIA Tesla V100-GPU-ზე უახლესი რეზიუმირების მოდელისთვის დაახლოებით 28 აშშ დოლარი დაჯდა. ვინაიდან ჩვენმა მოდელმა მიაღწია საკმაოდ კარგ შედეგს, ჩვენ ვაპირებთ მის ატვირთვას huggingface.co-ზე, შევქმნით მოდელის ბარათს (model_card) და შევამოწმებთ მას ჰოსტირებული დასკვნის ვიჯეტის (Hosted Inference widget) გამოყენებით. მოდელის ასატვირთად, საჭიროა ანგარიშის შექმნა აქ. ჩვენ შეგვიძლია გადმოვწეროთ ჩვენი მოდელი Amazon S3-დან და გავხსნათ ის შემდეგი სნიპეტის გამოყენებით. სანამ ჩვენს მოდელს ავტვირთავთ huggingface.co-ზე, საჭიროა შევქმნათ მოდელის ბარათი (model_card). მოდელის ბარათი აღწერს მოდელს და მოიცავს ჰიპერპარამეტრებს, შედეგებს, ასევე აზუსტებს, თუ რომელი მონაცემთა ნაკრები იქნა გამოყენებული ტრენინგისთვის. მოდელის ბარათის შესაქმნელად, ჩვენ ვქმნით README.md-ს ჩვენს ლოკალურ გზაზე. მას შემდეგ, რაც ამოვიღებთ ყველა იმ მეტრიკას, რომლის ჩართვაც გვსურს...
თეგები:
#ai
#cloud computing
#მანქანური სწავლება
#gpu
#ტრანსფორმერები
#ღრმა სწავლება
#hugging face
#განაწილებული ტრენინგი
#aws sagemaker
#რეზიუმირება
#ღრმა სწავლების კონტეინერები
წყარო: huggingface.co
AI-ით გადამუშავებული
მსგავსი სტატიები

ტექნოლოგიები
Honor Magic V6: უთხელესი დასაკეცი ტელეფონი? პირველი შთაბეჭდილებები
ტექნოლოგიები
Honor Magic V6: ყველაზე თხელი დასაკეცი სმარტფონი და მისი შთამბეჭდავი შესაძლებლობები

ტექნოლოგიები