CLIP მოდელის დახვეწა სატელიტური გამოსახულებებისთვის: Hugging Face-ის საზოგადოებრივი კვირეულის პროექტი
მიმდინარე წლის ივლისში Hugging Face-მა მოაწყო Flax/JAX საზოგადოებრივი კვირეული, სადაც მონაწილეებმა გამოიყენეს Tensor Processing Units (TPU) Flax-ისა და JAX-ის საშუალებით, რათა გაეწვრთნათ Hugging Face ტრანსფორმერების მოდელები ბუნებრივი ენის დამუშავებისა და კომპიუტერული ხედვის სფეროებში. ჩვენმა გუნდმა OpenAI-ის CLIP ქსელი დახვეწა RSICD, UCM და სიდნეის მონაცემთა ნაკრებებიდან მიღებული სატელიტური გამოსახულებებითა და აღწერებით. პროექტის მიზანი იყო სატელიტური გამოსახულებების დიდი კოლექციების ტექსტური მ
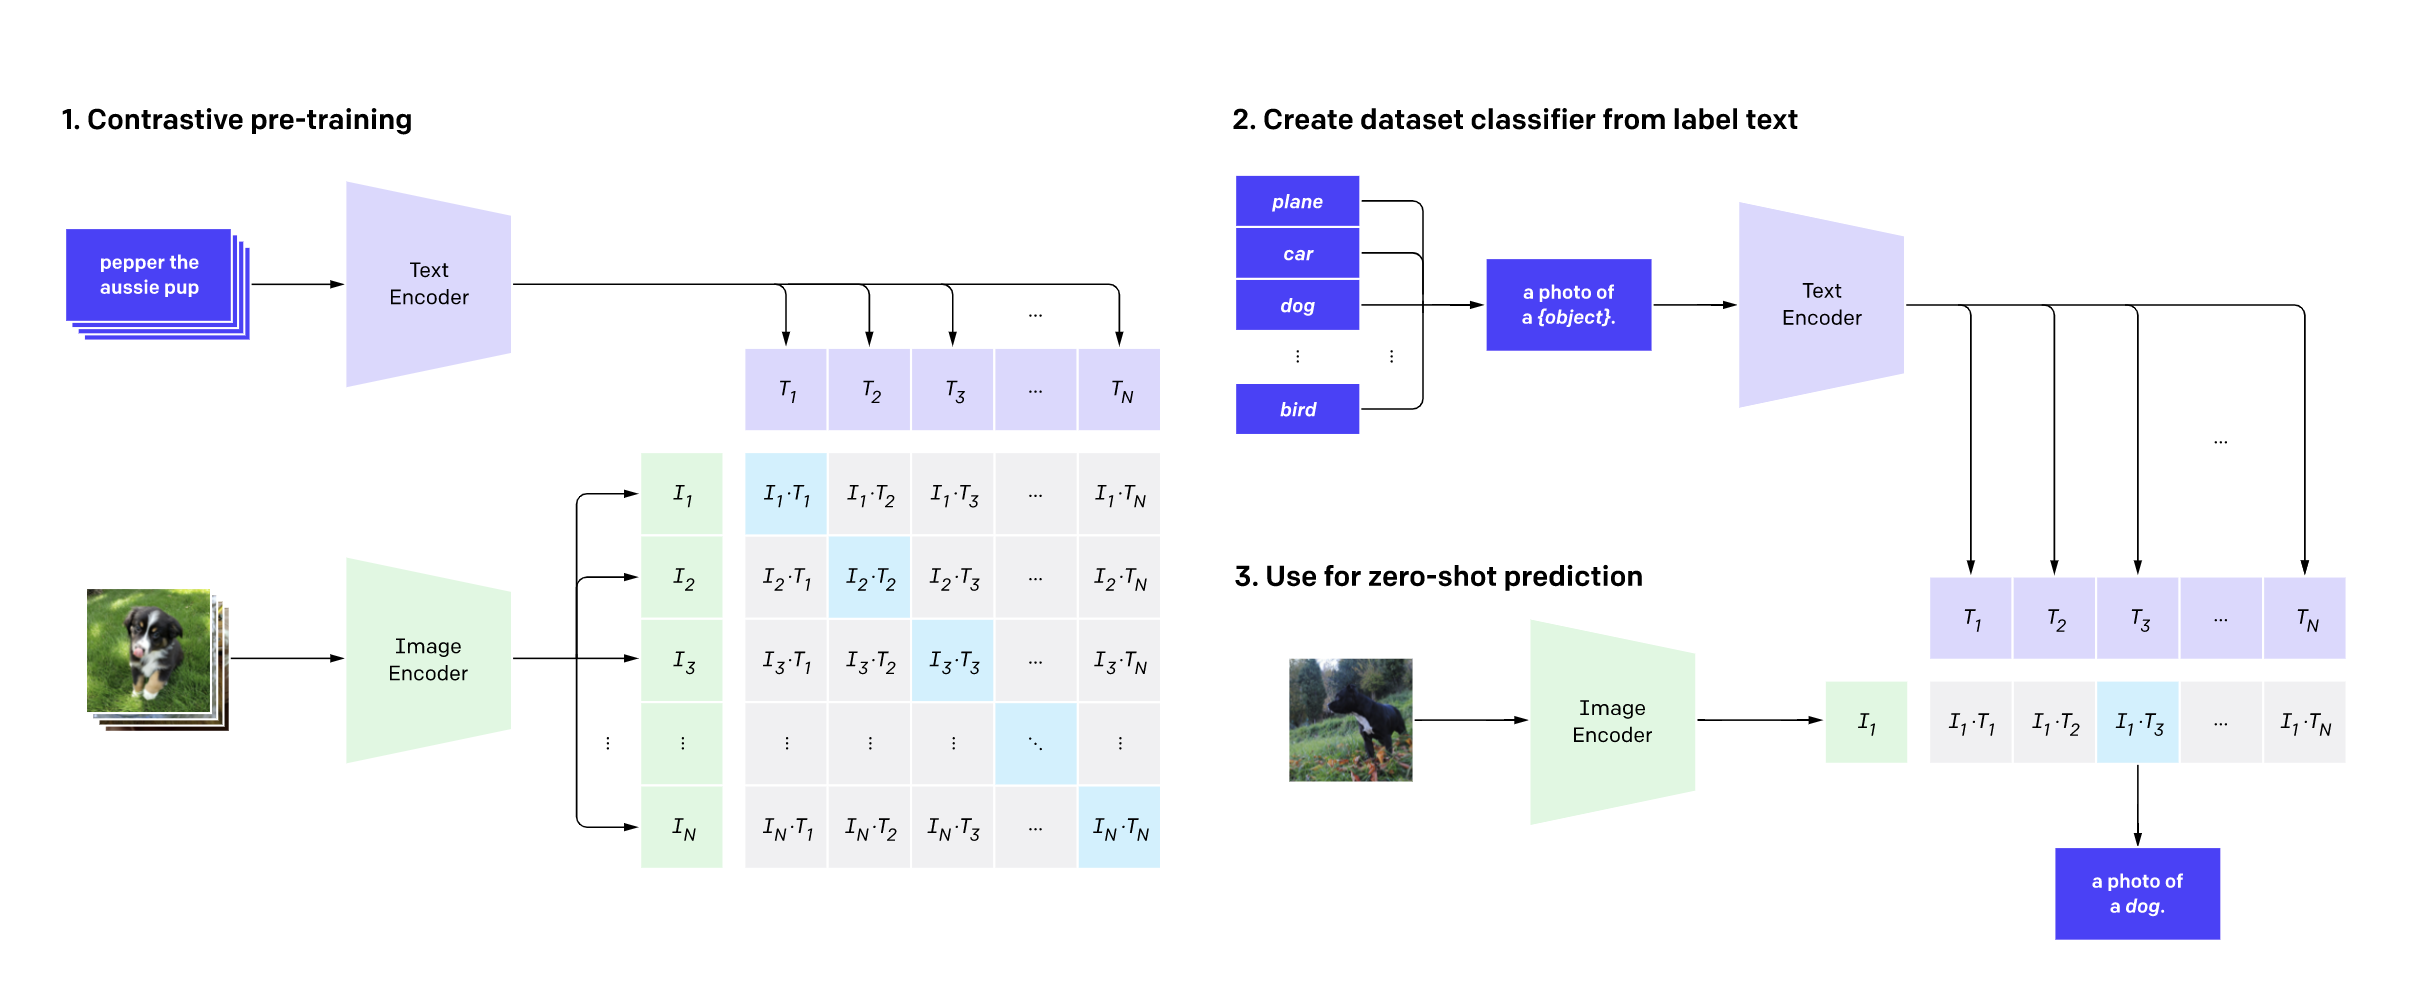
მიმდინარე წლის ივლისში, Hugging Face-მა მოაწყო Flax/JAX საზოგადოებრივი კვირეული და მოიწვია საზოგადოება, წარმოედგინათ პროექტები Hugging Face ტრანსფორმერების მოდელების გასაწვრთნელად ბუნებრივი ენის დამუშავებისა (NLP) და კომპიუტერული ხედვის (CV) სფეროებში. მონაწილეებმა გამოიყენეს ტენზორული დამმუშავებელი ერთეულები (TPU) Flax-ისა და JAX-ის საშუალებით. JAX არის წრფივი ალგებრის ბიბლიოთეკა (როგორიცაა numpy), რომელსაც შეუძლია ავტომატური დიფერენცირება (Autograd) და XLA-მდე კომპილირება, ხოლო Flax არის ნეირონული ქსელის ბიბლიოთეკა და ეკოსისტემა JAX-ისთვის. TPU-ს გამოთვლითი დრო უფასოდ იქნა მიწოდებული Google Cloud-ის მიერ, რომელიც ღონისძიების თანასპონსორი იყო. მომდევნო ორი კვირის განმავლობაში, გუნდებმა მონაწილეობა მიიღეს Hugging Face-ისა და Google-ის ლექციებში, გაწვრთნეს ერთი ან მეტი მოდელი JAX/Flax-ის გამოყენებით, გაუზიარეს ისინი საზოგადოებას და წარმოადგინეს Hugging Face Spaces-ის დემო, რომელიც ასახავდა მათი მოდელის შესაძლებლობებს. ღონისძიებაში დაახლოებით 100-მა გუნდმა მიიღო მონაწილეობა, რის შედეგადაც შეიქმნა 170 მოდელი და 36 დემო. ჩვენი გუნდი, ისევე როგორც მრავალი სხვა, დისტრიბუციული იყო და 12 დროის სარტყელზე იყო გადაჭიმული. ჩვენი საერთო მახასიათებელი ის არის, რომ ყველა TWIML Slack არხის წევრები ვართ, სადაც შევიკრიბეთ ხელოვნური ინტელექტისა (AI) და მანქანური სწავლების (ML) თემებისადმი საერთო ინტერესის საფუძველზე. ჩვენ დავხვეწეთ OpenAI-ის CLIP ქსელი RSICD მონაცემთა ნაკრებიდან მიღებული სატელიტური გამოსახულებებითა და აღწერებით. CLIP ქსელი ვიზუალურ კონცეფციებს სწავლობს გამოსახულებისა და აღწერის წყვილების გამოყენებით თვითზედამხედველობითი მეთოდით გაწვრთნის შედეგად, ინტერნეტში ნაპოვნი სურათებთან დაწყვილებული ტექსტის მეშვეობით. დასკვნის ეტაპზე (inference), მოდელს შეუძლია იწინასწარმეტყველოს ყველაზე შესაბამისი გამოსახულება მოცემული ტექსტური აღწერის საფუძველზე, ან ყველაზე შესაბამისი ტექსტური აღწერა მოცემული გამოსახულების საფუძველზე. CLIP საკმარისად მძლავრია, რომ გამოყენებულ იქნას ნულოვანი ცდით (zero-shot) ყოველდღიურ სურათებზე. თუმცა, მიგვაჩნდა, რომ სატელიტური გამოსახულებები საკმარისად განსხვავდებოდა ყოველდღიური სურათებისგან, რომ სასარგებლო იქნებოდა CLIP-ის მათი მეშვეობით დახვეწა. ჩვენი ინტუიცია სწორი აღმოჩნდა, რასაც შეფასების შედეგები (აღწერილი ქვემოთ) გვიჩვენებს. ამ პოსტში აღვწერთ ჩვენი ტრენინგისა და შეფასების პროცესის დეტალებს, ასევე ჩვენს გეგმებს ამ პროექტზე მომავალი მუშაობისთვის. ჩვენი პროექტის მიზანი იყო სასარგებლო სერვისის მიწოდება და იმის დემონსტრირება, თუ როგორ შეიძლება CLIP-ის გამოყენება პრაქტიკული მიზნებისთვის. ჩვენი მოდელი შეიძლება გამოყენებულ იქნას აპლიკაციების მიერ სატელიტური გამოსახულებების დიდი კოლექციების მოსაძიებლად ტექსტური მოთხოვნების გამოყენებით. ასეთი მოთხოვნები შეიძლება აღწერდეს გამოსახულებას მთლიანად (მაგალითად, სანაპირო, მთა, აეროპორტი, ბეისბოლის მოედანი და ა.შ.) ან ეძებდეს/ახსენებდეს კონკრეტულ გეოგრაფიულ ან ხელოვნურ მახასიათებლებს ამ გამოსახულებებში. CLIP ანალოგიურად შეიძლება დახვეწილ იქნას სხვა სფეროებისთვისაც, როგორც ეს აჩვენა medclip-demo გუნდმა სამედიცინო გამოსახულებებისთვის. ტექსტური მოთხოვნების გამოყენებით გამოსახულებების დიდი კოლექციების ძიების შესაძლებლობა უაღრესად მძლავრი ფუნქციაა და შეიძლება გამოყენებულ იქნას როგორც სოციალური სიკეთისთვის, ასევე მავნე მიზნებისთვის. შესაძლო აპლიკაციებში შედის ეროვნული თავდაცვისა და ანტიტერორისტული საქმიანობა, კლიმატის ცვლილების ეფექტების იდენტიფიცირებისა და მათზე რეაგირების შესაძლებლობა, სანამ ისინი უკონტროლო გახდებიან და ა.შ. სამწუხაროდ, ეს ძალა შეიძლება ბოროტად იქნას გამოყენებული, მაგალითად, ავტორიტარული სახელმწიფოების მიერ სამხედრო და პოლიციის ზედამხედველობისთვის, ამიტომ ის გარკვეულ ეთიკურ კითხვებსაც ბადებს. პროექტის შესახებ შეგიძლიათ წაიკითხოთ ჩვენს პროექტის გვერდზე, ჩამოტვირთოთ ჩვენი გაწვრთნილი მოდელი თქვენს მონაცემებზე დასკვნის მისაღებად, ან ნახოთ მისი მოქმედება ჩვენს დემოზე. ჩვენ CLIP მოდელი ძირითადად RSICD მონაცემთა ნაკრებით დავხვეწეთ. ეს მონაცემთა ნაკრები დაახლოებით 10 000 გამოსახულებას მოიცავს, რომლებიც შეგროვებულია Google Earth-იდან, Baidu Map-იდან, MapABC-დან და Tianditu-დან. ის თავისუფლად მიეწოდება კვლევით საზოგადოებას, რათა ხელი შეუწყოს დისტანციური ზონდირების აღწერის წინსვლას „Exploring Models and Data for Remote Sensing Image Caption Generation“ (Lu et al, 2017) მეშვეობით. გამოსახულებები არის (224, 224) RGB სურათები სხვადასხვა გარჩევადობით და თითოეულ გამოსახულებასთან დაკავშირებულია 5-მდე აღწერა. გარდა ამისა, ტრენინგისთვის გამოვიყენეთ UCM მონაცემთა ნაკრები და სიდნეის მონაცემთა ნაკრები. UCM მონაცემთა ნაკრები დაფუძნებულია UC Merced მიწის გამოყენების მონაცემთა ნაკრებზე. ის მოიცავს 2100 გამოსახულებას, რომლებიც ეკუთვნის 21 კლასს (100 გამოსახულება თითო კლასზე), და თითოეულ გამოსახულებას აქვს 5 აღწერა. სიდნეის მონაცემთა ნაკრები შეიცავს ავსტრალიის ქალაქ სიდნეის გამოსახულებებს Google Earth-იდან. ის მოიცავს 613 გამოსახულებას, რომლებიც ეკუთვნის 7 კლასს. გამოსახულებები არის (500, 500) RGB და თითოეული გამოსახულებისთვის მოცემულია 5 აღწერა. ეს დამატებითი მონაცემთა ნაკრებები იმიტომ გამოვიყენეთ, რომ არ ვიყავით დარწმუნებულნი, იქნებოდა თუ არა RSICD მონაცემთა ნაკრები საკმარისად დიდი CLIP-ის დასახვეწად. ჩვენი მოდელი წარმოადგენს ორიგინალი CLIP მოდელის დახვეწილ ვერსიას. მოდელის შეყვანებია აღწერების ჯგუფი და გამოსახულებების ჯგუფი, რომლებიც გაივლის CLIP ტექსტურ ენკოდერსა და გამოსახულების ენკოდერს შესაბამისად. ტრენინგის პროცესი იყენებს კონტრასტულ სწავლებას გამოსახულებისა და აღწერების ერთობლივი ჩანერგვის წარმოდგენის შესასწავლად. ამ ჩანერგვის სივრცეში, გამოსახულებები და მათი შესაბამისი აღწერები ერთმანეთთან ახლოს მიდის, ისევე როგორც მსგავსი გამოსახულებები და მსგავსი აღწერები. პირიქით, სხვადასხვა გამოსახულების გამოსახულებები და აღწერები, ან განსხვავებული გამოსახულებები და აღწერები, სავარაუდოდ, ერთმანეთისგან უფრო შორს იქნება. ჩვენი მონაცემთა ნაკრების რეგულარიზაციისა და მონაცემთა ნაკრების ზომის გამო ზედმეტი მორგების თავიდან ასაცილებლად, გამოვიყენეთ როგორც გამოსახულების, ასევე ტექსტის აუგმენტაცია.
თეგები:
#ai
#მანქანური სწავლება
#google cloud
#კომპიუტერული ხედვა
#ბუნებრივი ენის დამუშავება
#hugging face
#ml
#clip
#flax/jax
#სატელიტური გამოსახულებები
#tensor processing units
წყარო: huggingface.co
AI-ით გადამუშავებული
მსგავსი სტატიები

ხელოვნური ინტელექტი
Anthropic-ის Claude-ის აღზევება Apple App Store-ის რეიტინგებში პენტაგონთან მოლაპარაკებების ფონზე

ხელოვნური ინტელექტი
ტრამპის ადმინისტრაცია Anthropic-ს სანქციებს უწესებს ხელოვნური ინტელექტის გამოყენებაზე უარის გამო: ექსპერტი ინდუსტრიის უსაფრთხოების ხარვეზებზე საუბრობს
ხელოვნური ინტელექტი