
გიორგი გერგანოვის გუნდი Hugging Face-ს უერთდება: ახალი ეტაპი ადგილობრივი AI-ის განვითარებაში
გიორგი გერგანოვი და მისი გუნდი, რომლებიც დგანან ggml-ისა და llama.cpp-ის პროექტების უკან, უერთდებიან Hugging Face-ს. ეს ნაბიჯი მიზნად ისახავს ადგილობრივი ხელოვნური ინტელექტის (AI) ექსპონენციურ განვითარებას მომდევნო წლებში, პროექტის გრძელვადიანი, მდგრადი რესურსებით უზრუნველყოფას და მისი ღია კოდის ბუნების შენარჩუნებას. გუნდი სრულ ავტონომიას შეინარჩუნებს ტექნიკურ მიმართულებებსა და საზოგადოებასთან მუშაობაში.

Gradio-ს gr.HTML: რთული ინტერაქტიული ვებ კომპონენტების შექმნა ერთ ფაილში
სტატია აღწერს, თუ როგორ აძლევს Gradio-ს gr.HTML კომპონენტი დეველოპერებს საშუალებას, უპრეცედენტო სიმარტივითა და სისწრაფით შექმნან დახვეწილი, ინტერაქტიული ვებ აპლიკაციები და ხელოვნური ინტელექტის ინსტრუმენტები. ის გვიჩვენებს სხვადასხვა მაგალითს, როგორიცაა პომოდოროს ტაიმერი, GitHub-ის სითბური რუკა, კანბანის დაფა და AI-სთვის სპეციფიკური მაყურებლები, რომლებიც ყველა ერთ პითონ ფაილშია შემუშავებული, რაც ამარტივებს განლაგებას და აჩქარებს განვითარების ციკლს იდეიდან ცოცხალ აპლიკაციამდე წამებში.

Livebook, Elixir და Hugging Face: მანქანური სწავლების ახალი ჰორიზონტები
სტატია მიმოიხილავს ჩატის აპლიკაციას, რომელიც აუდიო შეტყობინებებს Whisper ML მოდელის გამოყენებით ტექსტად გარდაქმნის და წარმოაჩენს Livebook-ისა და Elixir-ის მანქანური სწავლების ეკოსისტემის შესაძლებლობებს. დეტალურად არის განხილული Elixir-ის საზოგადოების თანამშრომლობა Hugging Face პლატფორმასთან, მათ შორის Bumblebee ბიბლიოთეკის, tokenizers-ის და Livebook-ის Hugging Face Spaces-ში ინტეგრაციის მაგალითები, რაც მანქანური სწავლის გამოყენების ახალ გზებს ხსნის.
Core ML-ის ოპტიმიზაცია: Apple-ის მოწყობილობებზე AI მოდელების მუშაობის ახალი დონე
Core ML-ის უახლესი გაუმჯობესებები მნიშვნელოვნად აჩქარებს ხელოვნური ინტელექტის (AI) მოდელების, მათ შორის Stable Diffusion-ისა და დიდი ენის მოდელების, მუშაობას Apple-ის მოწყობილობებზე. ეს ოპტიმიზაციები, რომელიც მოიცავს 6-ბიტიან პალეტიზაციას და ml-stable-diffusion რეპოზიტორიუმის განახლებას, უზრუნველყოფს მონაცემთა ნაკლებ გადაცემას, მეტ კონფიდენციალურობას და ხარჯების დაზოგვას, რაც დეველოპერებს აძლევს საშუალებას, შექმნან უფრო ეფექტური აპლიკაციები უშუალოდ მოწყობილობაზე.

LLaMA-ს MMLU შეფასება: უთანხმოება ხელოვნური ინტელექტის მოდელების რეიტინგში
Open LLM ლიდერბორდზე LLaMA მოდელის MMLU (Massive Multitask Language Understanding) შეფასების ქულები გაცილებით დაბალი აღმოჩნდა, ვიდრე მის გამოქვეყნებულ ნაშრომში იყო მითითებული. ამან საზოგადოებაში გაკვირვება გამოიწვია. გამოძიებამ გამოავლინა MMLU შეფასების სხვადასხვა იმპლემენტაცია, მათ შორის EleutherAI Harness, ორიგინალი UC Berkeley-ის კოდი და Stanford HELM, რომლებიც განსხვავებულ შედეგებს იძლევა და მოდელების რეიტინგსაც კი ცვლის. სტატია დეტალურად განმარტავს ამ შეუსაბამობის მიზეზებს და დიდი ენობრივი
ღია კოდის AI თამაშების ჯემი: გამარჯვებული და გამორჩეული ნამუშევრები
ღია კოდის ხელოვნური ინტელექტის თამაშების ჯემმა, რომლის მიზანიც იყო ღია კოდის AI ინსტრუმენტების თამაშებში ინტეგრირება, მოლოდინს გადააჭარბა 1300-ზე მეტი რეგისტრაციითა და 88 თამაშის წარდგენით. თემამ „გაფართოება“ ხელი შეუწყო მრავალფეროვან შემოქმედებას. თანატოლთა შეფასებისა და ჟიურის მსჯელობის შემდეგ, „Snip It“ (ohmlet-ის მიერ) დასახელდა გამარჯვებულად, რომელმაც წარმოაჩინა ინოვაციური, ხელოვნური ინტელექტის მიერ გენერირებული გეიმპლეი.
Hugging Face ევროკავშირის ხელოვნური ინტელექტის აქტის შესახებ: ღია ML განვითარების აუცილებლობა
Hugging Face, Creative Commons-თან, Eleuther AI-თან, GitHub-თან, LAION-თან და Open Future-თან კოალიციაში, წარმოადგენს თავის პოზიციას ევროკავშირის ხელოვნური ინტელექტის (AI) აქტის შესახებ. კომპანია ხაზს უსვამს ღია მანქანური სწავლების (ML) განვითარების აუცილებელ როლს აქტის მიზნების მისაღწევად და მოუწოდებს რეგულაციას, უკეთ გაითვალისწინოს ღია, მოდულური და კოლაბორაციული ML განვითარების საჭიროებები, რაც ხელს უწყობს ინოვაციას, გამჭვირვალობასა და ანგარიშვალდებულებას.
Stable Diffusion XL Core ML-ზე: მოდელის ზომის შემცირება და მუშაობის გაუმჯობესება
Hugging Face-ი და Apple-ი აგრძელებენ ხელოვნური ინტელექტის მოდელების ოპტიმიზაციას სამომხმარებლო მოწყობილობებზე ადგილობრივად გასაშვებად. უახლესი მცდელობა Stable Diffusion XL-ის Core ML-ზე ადაპტაციაა Apple Silicon-ის Mac-ებისთვის, რაც საშუალებას იძლევა მოდელი შემცირდეს ზომით და გაუმჯობესდეს მისი მუშაობა ინოვაციური კვანტიზაციის მეთოდებით, მათ შორის შერეული ბიტების პალეტიზაციით. პროექტი სრულად ღია კოდით არის ხელმისაწვდომი და community-ის ჩართულობას ელის.
Stable Diffusion XL სამომხმარებლო აპარატურაზე: მოდელის ზომისა და მუშაობის ოპტიმიზაციის ახალი გზები
Stable Diffusion XL (SDXL) დიდი ზომის მოდელია, თუმცა მისი გაშვება უკვე შესაძლებელია 16 GB GPU RAM-ის მქონე CUDA აპარატურაზე, მათ შორის Colab-ის უფასო ვერსიაზეც. ბოლო თვეებში გაიზარდა ინტერესი ML მოდელების ადგილობრივად გაშვების მიმართ, რაც განპირობებულია კონფიდენციალურობითა და მოხერხებულობით. Apple-მა და Hugging Face-მა წარმოადგინეს SDXL-ის Core ML ვერსია, რომელიც ღია წყაროა. ნერგდება ახალი ტექნიკა – შერეული ბიტის პალეტიზაცია (mixed-bit palettization), რომელიც მნიშვნელოვნად ამცირებს მოდელის ზომას
Segmind-ის ინოვაცია: გენერაციული AI მოდელები SD-Small და SD-Tiny - უფრო სწრაფი და ეფექტური
კომპანია Segmind-მა წარმოადგინა შეკუმშული გენერაციული AI მოდელები, SD-Small და SD-Tiny, რომლებიც მნიშვნელოვნად აჩქარებენ დასკვნის გამოტანის პროცესს და ამცირებენ რესურსების მოხმარებას. Knowledge-Distillation (KD) ტექნიკით გაწვრთნილი ეს მოდელები საბაზისო მოდელებთან შედარებით 35%-ით და 55%-ით ნაკლებ პარამეტრს შეიცავს, მაგრამ გამოსახულების შედარებით ხარისხს ინარჩუნებს. წინა წელს გამოშვებულ voltaML ბიბლიოთეკასთან ერთად, რომელიც ინფერენციის სიჩქარეს 4-6-ჯერ ზრდის, ახალი მოდელები 100%-მდე მეტ სისწრაფეს
LLM-ების ინტეგრაცია Swift აპლიკაციებში Core ML-ის გამოყენებით: დეველოპერების სახელმძღვანელო
მანქანური სწავლება (ML) პროგრამული უზრუნველყოფის შექმნის ახალ გზებს ხსნის, განსაკუთრებით Swift დეველოპერებისთვის, რომლებსაც სურთ ხელოვნური ინტელექტის ფუნქციების ინტეგრირება თავიანთ აპლიკაციებში. ეს სტატია წარმოგიდგენთ Core ML-ზე დაფუძნებულ ინსტრუმენტებსა და დეტალურ სახელმძღვანელოს, თუ როგორ უნდა გაუშვათ დიდი ენობრივი მოდელები (LLM), როგორიცაა Llama 2, Mac-ზე. პროექტი მოუწოდებს დეველოპერებს, შეერთდნენ და წვლილი შეიტანონ ამ ინიციატივის ერთობლივ გაუმჯობესებაში, რათა დააჩქარონ ხელოვნური ინტელექტის შ
DeepFloyd IF-ის ინტეგრაცია BentoML-თან პროდუქტიული განთავსებისთვის
სტატია მიმოიხილავს, თუ როგორ ხდება BentoML-ის, ღია კოდის პლატფორმის, გამოყენება DeepFloyd IF-ის, თანამედროვე ტექსტიდან გამოსახულების გენერირების მოდელის, განთავსებისთვის. აღწერილია DeepFloyd IF-ის უნიკალური არქიტექტურა (პიქსელურ სივრცეში მუშაობა, კასკადური დიფუზია, LLM-ის გამოყენება მოთხოვნებისთვის) და BentoML-ის მეშვეობით რესურსების ოპტიმალური მართვა, მათ შორის GPU-ს განაწილება. მოცემულია ინსტრუქციები პროექტის ლოკალურად გაშვებისთვის, მოდელების ჩამოტვირთვისთვის, სერვერის Gradio-სთან ერთად გაშვებ
Hugging Face-ისა და Amazon-ის სტრატეგიული პარტნიორობა: უახლესი ML მოდელების გამოყენების გამარტივება SageMaker-ში
Hugging Face-მა და Amazon-მა სტრატეგიული პარტნიორობა გამოაცხადეს, რათა კომპანიებისთვის უახლესი მანქანური სწავლების (ML) მოდელების გამოყენება და NLP ფუნქციების სწრაფად დანერგვა გაამარტივონ. Hugging Face Amazon Web Services-ს (AWS) სასურველ ღრუბლოვან პროვაიდერად ირჩევს. ამ თანამშრომლობის პირველი ნაბიჯი Hugging Face-ის ახალი ღრმა სწავლების კონტეინერების (DLCs) შეთავაზებაა, რაც Amazon SageMaker-ში Transformer მოდელების გაწვრთნას უპრეცედენტოდ ამარტივებს.
SmolVLM2: ვიდეოს გაგება ხელმისაწვდომი ხდება ყველა მოწყობილობაზე
SmolVLM2 წარმოადგენს ფუნდამენტურ ცვლილებას ვიდეოს გაგების მიდგომაში, მოძრაობს მასიური, რესურსმომთხოვნი მოდელებიდან ეფექტურ, ნებისმიერ მოწყობილობაზე გაშვებად გადაწყვეტილებებზე. მიზანია ვიდეოს გაგება ხელმისაწვდომი გახდეს ყველა მოწყობილობისთვის, ტელეფონებიდან სერვერებამდე. გამოშვებულია სამი ზომის (2.2B, 500M და 256M) მოდელი, MLX-თან თავსებადობით (Python და Swift API-ები). ეს მოდელები, მიუხედავად მცირე ზომისა, მნიშვნელოვნად აღემატება არსებულ ანალოგებს მეხსიერების მოხმარების მხრივ და ზოგიერთ შემთხვევ
Hugging Face-ის ზაფხულის განახლებები: ივნისი, ივლისი, აგვისტო
ეს პოსტი აჯამებს Hugging Face-ის ივნის-აგვისტოს განახლებებს, მათ შორის საჯარო მოდელების რეპოზიტორიების 10,000-დან 16,000-მდე ზრდას. წარმოდგენილია ახალი ფუნქციები, როგორიცაა „Spaces“ ML დემო აპლიკაციების ჰოსტინგისთვის, ნივთების „მოწონების“ შესაძლებლობა, TensorBoard-ის ინტეგრაცია, შეფასების მეტრიკები, რომლებიც დაკავშირებულია Papers With Code-თან, ახალი ვიჯეტები სხვადასხვა ML ამოცანებისთვის (აუდიო, სტრუქტურირებული მონაცემები, გამოსახულება), გაუმჯობესებული დოკუმენტაცია, რეპოზიტორიების გადატანა/გადარ
მარტივად შექმენით ინტერაქტიული ML დემოები Gradio-თი Hugging Face Spaces-ზე
ეს სტატია განმარტავს, თუ როგორ უნდა შექმნათ და უმასპინძლოთ ინტერაქტიულ მანქანური სწავლების მოდელების დემოებს Hugging Face Spaces-ზე Gradio-ს გამოყენებით. ის დეტალურად აღწერს პროცესს ინტერფეისების განსაზღვრიდან რთული მოდელების პაიპლაინების განთავსებამდე, ხაზს უსვამს Hugging Face-ის Inference API-სთან ინტეგრაციასა და Gradio Series-ის მოქნილობას.
როგორ განავითარა Rocket Money-მ ტრანზაქციების კლასიფიკაციის AI სისტემა: Regex-დან BERT-ამდე და Hugging Face-მდე
Rocket Money (ყოფილი Truebill) მომხმარებლებს ფინანსური კეთილდღეობის გაუმჯობესებაში ეხმარება ტრანზაქციების კლასიფიკაციის გზით. თავდაპირველად, კომპანია რეგულარულ გამოსახულებებს (regex) იყენებდა, თუმცა მომხმარებელთა ზრდასთან ერთად, სისტემას მასშტაბირების პრობლემები შეექმნა. ამ გამოწვევის საპასუხოდ, Rocket Money-მ მიმართა მანქანური სწავლის (ML) გადაწყვეტილებებს და ნულიდან ააწყო შიდა სისტემა, რომელიც BERT მოდელების ოჯახს იყენებს. მოდელების წარმატებული ოფლაინ ტესტირების შემდეგ, კომპანია შეუდგა საწარმო
Rocket Money-ის რევოლუცია ტრანზაქციების კლასიფიკაციაში: AI-ის დანერგვა და Hugging Face-ის სტრატეგიული არჩევანი
პირადი ფინანსების აპლიკაცია Rocket Money-მ, მომხმარებელთა მზარდი ბაზისა და გამოწერის ეკონომიკის ბუმის ფონზე, ტრანზაქციების კლასიფიკაციისა და გამყიდველების იდენტიფიცირების სისტემა განავითარა. კომპანია რეგულარულ გამოსახულებებზე (regex) დაფუძნებული სისტემიდან მანქანური სწავლების (ML) უფრო დახვეწილ მიდგომაზე (BERT მოდელები) გადავიდა. ტრადიციულ ML გადაწყვეტებთან დაკავშირებული სირთულეების და შიდა სისტემის აშენების შემდეგ, Rocket Money-მ წარმატებით მოახდინა BERT მოდელების ინტეგრაცია. მოდელების განსათავ
Streamlit Hugging Face Spaces-ში: ML მოდელებისა და მონაცემთა ვიზუალიზაცია
ეს სტატია განმარტავს, თუ როგორ გამოიყენოთ Streamlit Hugging Face Spaces-თან ერთად მანქანური სწავლების მოდელების დემოების შესაქმნელად და მონაცემთა ნაკრებების ვიზუალიზაციისთვის. ის მოიცავს მოდელების ჰოსტინგს, ინტერფეისის აგებას, მონაცემთა სტრიმინგსა და ვიზუალიზაციის კომპონენტების გამოყენებას, მაგალითად, „Write with Transformer“-ის რეპლიკაციით.
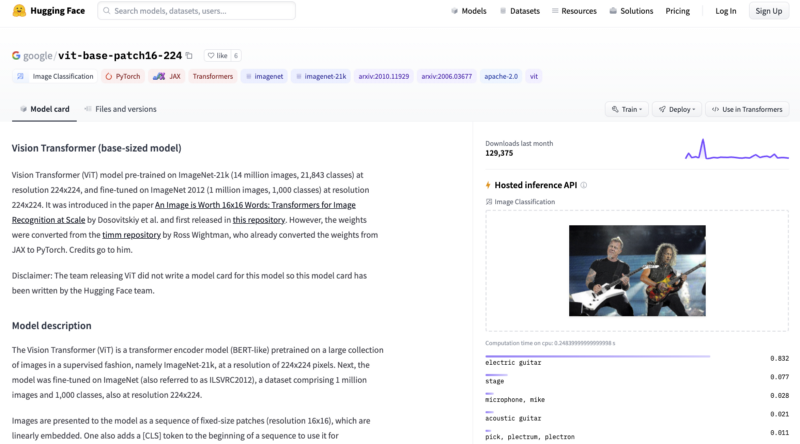
მანქანური სწავლა ყველგან: როგორ ვაქციოთ AI საწარმოო რეალობად MLOps-ისა და ტრანსფორმერების დახმარებით
მანქანური სწავლისა (ML) და ხელოვნური ინტელექტის (AI) ფართო დანერგვის ფონზე, ტექსტი აყენებს კითხვას ინდუსტრიის მზაობის შესახებ ამ მასშტაბური განთავსებისთვის. ავტორი ხაზს უსვამს MLOps-ის მნიშვნელობას, რომელიც აერთიანებს პროგრამული ინჟინერიის საუკეთესო პრაქტიკებს (ვერსიონირება, ხელახალი გამოყენება, ტესტირება) მანქანური სწავლის სამუშაო პროცესებთან. იგი ამტკიცებს, რომ საჭიროა მეტი ML-ში გათვითცნობიერებული პროგრამული უზრუნველყოფის და DevOps ინჟინერი, ვიდრე უბრალოდ მონაცემთა მეცნიერი, რათა მოდელები წარ
ხელოვნური ინტელექტი და მისი განვითარება: გამოწვევები, MLOps-ის მნიშვნელობა და ტრანსფორმერების აღზევება
ხელოვნური ინტელექტი (ხი) და მანქანური სწავლება (მს) სულ უფრო ხშირად გამოიყენება კრიტიკულ ინფრასტრუქტურაში, თუმცა ჩნდება კითხვები ინდუსტრიის სიმწიფისა და მასშტაბური დანერგვის შესახებ. სტატია განიხილავს მყარი მს-სამუშაო პროცესების შექმნის აუცილებლობას, ხაზს უსვამს MLOps-ის, როგორც DevOps-ის გაგრძელების, მნიშვნელობას და ამტკიცებს, რომ პროგრამული უზრუნველყოფის და DevOps ინჟინრები, რომლებსაც ესმით მანქანური სწავლება, უფრო მეტად არიან საჭირო, ვიდრე უბრალოდ მონაცემთა მეცნიერები. ასევე, ყურადღება ექცევა
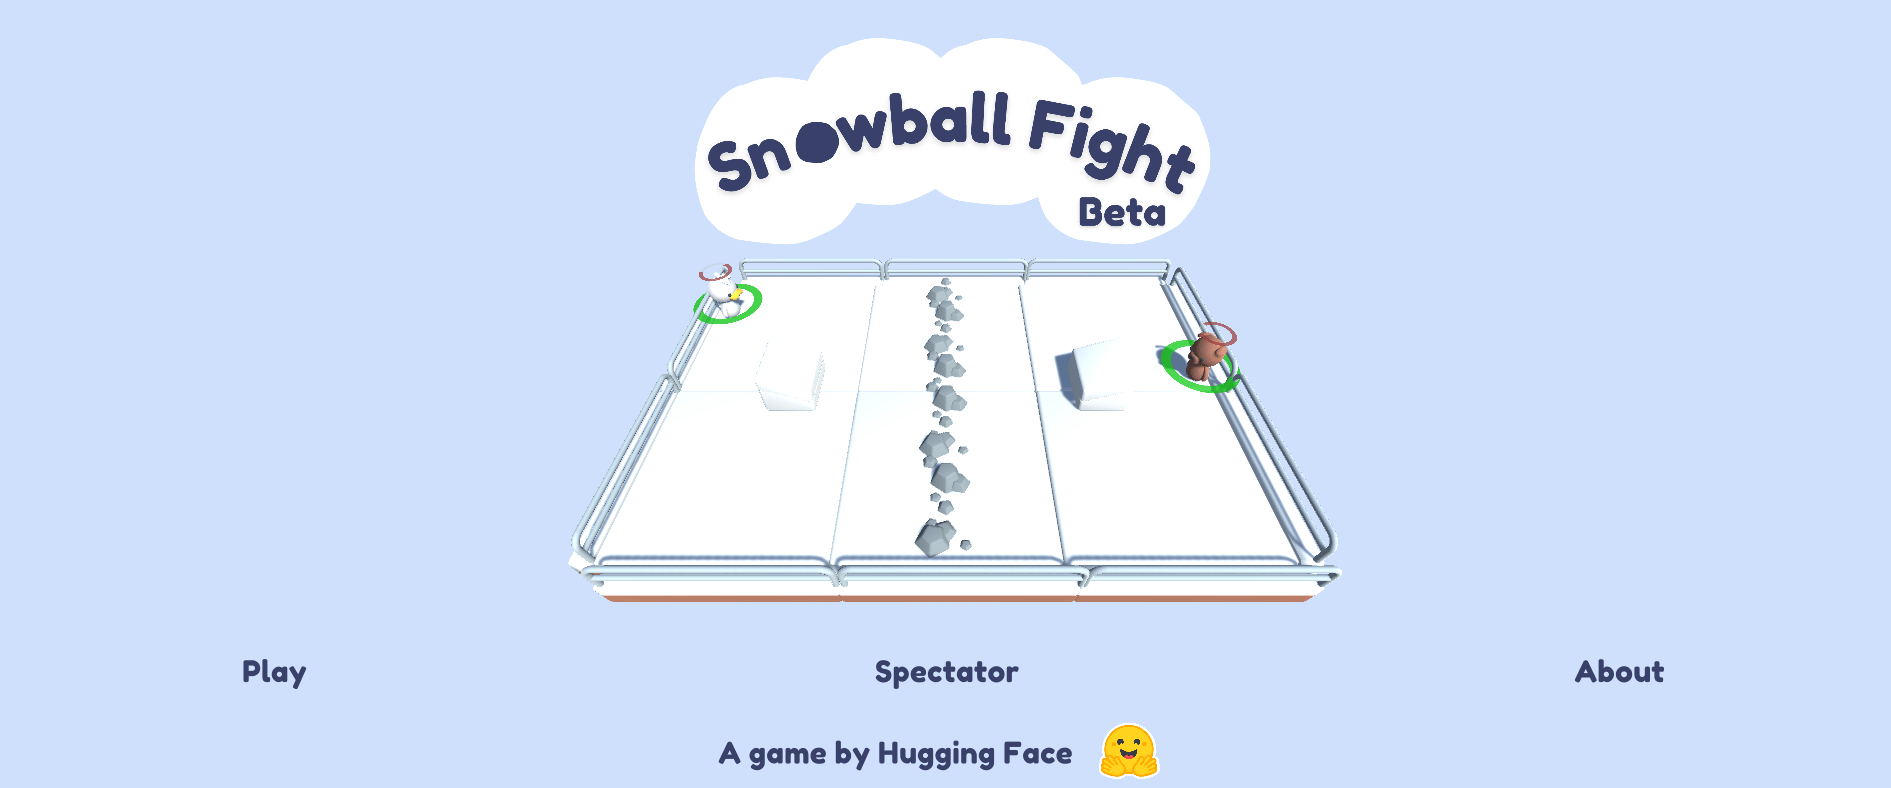
Hugging Face-ი აფართოებს Deep Reinforcement Learning-ის ეკოსისტემას Unity ML-Agents-ით: ახალი თამაში და საზოგადოება
Hugging Face-ი, Unity ML-Agents-ის გამოყენებით, ღრმა გაძლიერებითი სწავლების მკვლევრებისა და ენთუზიასტებისთვის ეკოსისტემას აფართოებს. ამ ინიციატივის ფარგლებში წარმოდგენილია თამაში „Snowball Fight“ და ახალი Discord სერვერი საზოგადოების ჩართულობისთვის.
Renumics Spotlight: ინტერაქტიული ვიზუალიზაცია და მონაცემთა ინსპექცია Hugging Face-ის მონაცემთა ნაკრებებისთვის
Renumics Spotlight გთავაზობთ ინტერაქტიულ ვიზუალიზაციებს Hugging Face-ის მონაცემთა ნაკრებებში კრიტიკული კლასტერების იდენტიფიცირებისთვის. ის იყენებს მოდელის შედეგებს (პროგნოზები, ემბედინგები) მონაცემთა სეგმენტებისა და მოდელის შეცდომების ღრმა გაგებისთვის, რაც აადვილებს მონაცემთა ინსპექციას და ხდის მას მასშტაბირებადს. ხელსაწყო პირდაპირ ინტეგრირდება `datasets` ბიბლიოთეკასთან და მხარს უჭერს სხვადასხვა ტიპის მონაცემებსა და ML ამოცანებს, მათ შორის NLP, აუდიო და კომპიუტერული ხედვა.

Gradio-ს 5-წლიანი გზა: როგორ გახდა ის AI ვებ აპლიკაციების სტანდარტი
5 წლის წინ Stanford-ის მკვლევრებისთვის შექმნილი Gradio დღეს მილიონობით დეველოპერს ეხმარება AI ვებ აპლიკაციების შექმნასა და გაზიარებაში. სტატია მიმოიხილავს Gradio-ს ზრდის სტრატეგიებს, მათ შორის, დაბალდონიანი API-ების განვითარებას მაღალი დონის აბსტრაქციების ნაცვლად, ვიწრო, მზარდ ნიშაზე ფოკუსირებას (ML ვებ აპლიკაციები) და მომხმარებლებისთვის გაზიარების მარტივი მექანიზმების შეთავაზებას.