ZeRO, DeepSpeed და FairScale: ხელოვნური ინტელექტის მოდელების ვარჯიშის მეხსიერების ოპტიმიზაცია
სტატია მიმოიხილავს ხელოვნური ინტელექტის მოდელების ზრდასთან დაკავშირებულ მეხსიერების პრობლემებს და წარმოგიდგენთ ZeRO-ს, DeepSpeed-სა და FairScale-ს, როგორც ამ პრობლემის გადაჭრის საშუალებებს. განხილულია ამ ტექნოლოგიების ინტეგრაცია და ეფექტურობა მოდელების ვარჯიშის პროცესში, როგორც მრავალი, ისე ერთი GPU-ს გამოყენებისას, ხაზგასმულია მნიშვნელოვანი გაუმჯობესებები მუშაობის სიჩქარესა და მეხსიერების გამოყენებაში.

დიდი ML მოდელების ეფექტური ვარჯიში: PyTorch FSDP-ის გამოყენება განაწილებულ სისტემებში
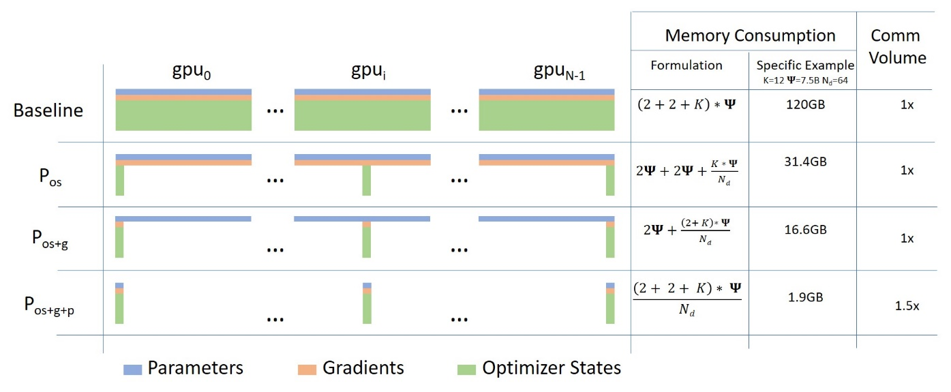
მანქანური სწავლების (ML) მოდელების მზარდი ზომისა და პარამეტრების გამო, სპეციალისტებს უჭირთ მათი ვარჯიში სტანდარტულ აპარატურაზე, მიუხედავად იმისა, რომ დიდი მოდელები უფრო სწრაფად სწავლობენ და მაღალ წარმადობას ავლენენ. ამ გამოწვევის საპასუხოდ, განაწილებული სწავლება ხდება გადამწყვეტი. ეს სტატია იკვლევს მონაცემთა პარალელიზმს ZeRO კონცეფციის გამოყენებით და კონკრეტულად PyTorch-ის უახლეს ფუნქციას, FullyShardedDataParallel (FSDP)-ს. DeepSpeed-ისა და FairScale-ის მიერ დანერგილი ZeRO-ის იდეები, PyTorch-ში