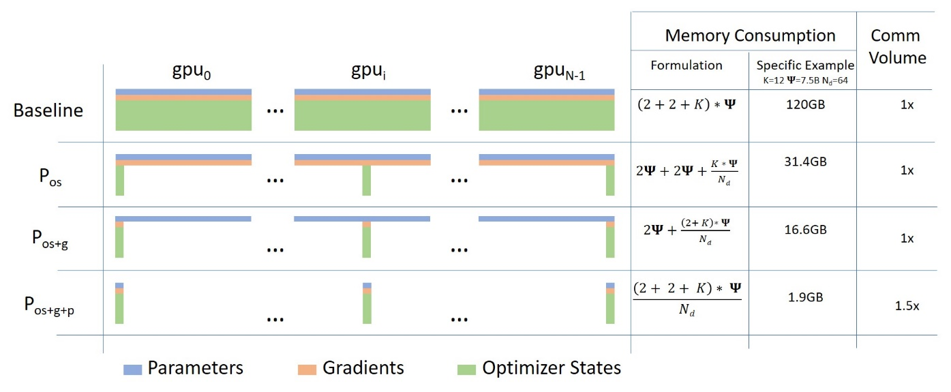
ZeRO, DeepSpeed და FairScale: ხელოვნური ინტელექტის მოდელების ვარჯიშის მეხსიერების ოპტიმიზაცია
სტატია მიმოიხილავს ხელოვნური ინტელექტის მოდელების ზრდასთან დაკავშირებულ მეხსიერების პრობლემებს და წარმოგიდგენთ ZeRO-ს, DeepSpeed-სა და FairScale-ს, როგორც ამ პრობლემის გადაჭრის საშუალებებს. განხილულია ამ ტექნოლოგიების ინტეგრაცია და ეფექტურობა მოდელების ვარჯიშის პროცესში, როგორც მრავალი, ისე ერთი GPU-ს გამოყენებისას, ხაზგასმულია მნიშვნელოვანი გაუმჯობესებები მუშაობის სიჩქარესა და მეხსიერების გამოყენებაში.

Deepseek R1-ის 'აჰა მომენტი' და მისი ხელახლა შექმნა GRPO-სა და Countdown თამაშის მეშვეობით
Deepseek R1-ის გამოშვებამ ინდუსტრია შეძრა, რადგან ის არის ღია მოდელი, რომელიც OpenAI-ის o1-ს ეჯიბრება კომპლექსური მსჯელობის ამოცანებში. მოდელი გამოირჩევა „აჰა მომენტით“ – თვითვერიფიკაციის უნარით ადამიანური ჩარევის გარეშე. ეს ბლოგ პოსტი მიზნად ისახავს ამ უნიკალური ქცევის ხელახლა შექმნას Group Relative Policy Optimization (GRPO) და Countdown თამაშის გამოყენებით, დისტრიბუციულ ტრენინგზე ფოკუსირებით Deepspeed-ისა და vLLM-ის მეშვეობით.

დიდი ML მოდელების ეფექტური ვარჯიში: PyTorch FSDP-ის გამოყენება განაწილებულ სისტემებში
მანქანური სწავლების (ML) მოდელების მზარდი ზომისა და პარამეტრების გამო, სპეციალისტებს უჭირთ მათი ვარჯიში სტანდარტულ აპარატურაზე, მიუხედავად იმისა, რომ დიდი მოდელები უფრო სწრაფად სწავლობენ და მაღალ წარმადობას ავლენენ. ამ გამოწვევის საპასუხოდ, განაწილებული სწავლება ხდება გადამწყვეტი. ეს სტატია იკვლევს მონაცემთა პარალელიზმს ZeRO კონცეფციის გამოყენებით და კონკრეტულად PyTorch-ის უახლეს ფუნქციას, FullyShardedDataParallel (FSDP)-ს. DeepSpeed-ისა და FairScale-ის მიერ დანერგილი ZeRO-ის იდეები, PyTorch-ში
Hugging Face და AMD აძლიერებენ ხელოვნური ინტელექტის განვითარებას AMD GPU-ებზე
Hugging Face-ი და AMD-ი აცხადებენ მნიშვნელოვან პროგრესს AMD GPU-ებზე დიდი ენობრივი მოდელების (LLM) მხარდაჭერაში, რაც უზრუნველყოფს ტრანსფორმერული მოდელების უწყვეტ გაშვებას კოდის შეცვლის გარეშე. დამატებითი აჩქარების ინსტრუმენტები, როგორიცაა ONNX, Optimum-Benchmark და DeepSpeed, უკვე მხარდაჭერილია. კომპანიები ასევე ხელს უწყობენ დეველოპერებს PC AI კონკურსის ფარგლებში ინოვაციური AI აპლიკაციების შექმნაში AMD Ryzen AI-ით აღჭურვილ კომპიუტერებზე.

OOM შეცდომები წარსულს ჩაბარდა: დიდი მოდელების ვარჯიში DeepSpeed ZeRO-სა და Accelerate-ით
სტატია განმარტავს, თუ როგორ შეიძლება თავიდან ავიცილოთ მეხსიერების უკმარისობის (OOM) შეცდომები დიდი ხელოვნური ინტელექტის მოდელების ვარჯიშისას. იგი აღწერს DeepSpeed ZeRO ოპტიმიზატორის გამოყენებას Accelerate ბიბლიოთეკასთან ერთად, რაც საშუალებას იძლევა, ეფექტურად გამოვიყენოთ არსებული აპარატურა, გავზარდოთ პაკეტის ზომა და დავაჩქაროთ ვარჯიშის პროცესი. წარმოდგენილია შედარებები DDP-სა და DeepSpeed ZeRO Stage-2-ს შორის, რაც აჩვენებს მნიშვნელოვან გაუმჯობესებას შესრულებაში.
OOM შეცდომების დავიწყება: დიდი მოდელების ეფექტური წვრთნა DeepSpeed ZeRO-ს გამოყენებით
დაიღალეთ მეხსიერებიდან ამოწურვის (OOM) შეცდომებით დიდი ხელოვნური ინტელექტის მოდელების წვრთნისას? ეს სტატია წარმოგიდგენთ DeepSpeed ZeRO (Zero Redundancy Optimizer) ტექნოლოგიას, რომელიც მონაცემთა პარალელიზმის (Data Parallelism) გამოყენებით საშუალებას გაძლევთ მაქსიმალურად გამოიყენოთ არსებული აპარატურა. ჩვენ განვიხილავთ ZeRO-ს სხვადასხვა სტადიას, ოპტიმიზატორის მდგომარეობების, გრადიენტებისა და მოდელის პარამეტრების დანაწილების ჩათვლით. სტატია აჩვენებს, თუ როგორ შეუძლია DeepSpeed ZeRO Stage-2-ს, Accele
BLOOM: 176 მილიარდი პარამეტრის მოდელის შექმნის საინჟინრო მიღწევები და ტექნოლოგიები
პროექტი, რომელიც Hugging Face-ის თანადამფუძნებელმა თომას ვოლფმა წამოიწყო, მიზნად ისახავდა ერთ-ერთი უდიდესი მრავალენოვანი მოდელის შექმნას და მის ხელმისაწვდომობას ყველასთვის. ეს სტატია ფოკუსირებულია 176 მილიარდი პარამეტრის BLOOM მოდელის წვრთნის საინჟინრო ასპექტებზე, ხაზს უსვამს ექსპერტებისა და კომპანიების ერთობლივ ძალისხმევას. განხილულია ფრანგული სუპერკომპიუტერის Jean Zay გამოყენება და მოწინავე Megatron-DeepSpeed ფრეიმვორკი, რომელიც 3D პარალელიზმს იყენებს ეფექტური წვრთნისთვის.

BLOOM ინფერენსის ოპტიმიზაცია GPU-ებზე: წარმადობის ბენჩმარკინგი
ეს სტატია განიხილავს BLOOM ხელოვნური ინტელექტის მოდელის ინფერენსის ოპტიმიზაციას სხვადასხვა GPU კონფიგურაციებზე. მოცემულია აპარატურული მოთხოვნები 352GB bf16 წონებისთვის, სადაც რეკომენდებულია 8x80GB A100 GPU-ები, თუმცა განიხილება ალტერნატივებიც. სტატია აანალიზებს მოდელის ჩატვირთვის დროს და ტოკენების გენერირების წარმადობას (throughput) ისეთი გადაწყვეტების გამოყენებით, როგორიცაა Deepspeed-Inference და Accelerate, ასევე 8-ბიტიანი კვანტიზაცია მეხსიერების შესამცირებლად. ბენჩმარკინგის შედეგები აჩვენებს
Bloom მოდელის ოპტიმიზაცია: გზა 5x შეყოვნების შემცირებამდე და 50x გამტარუნარიანობამდე
ამ სტატიაში განხილულია Bloom-ის დიდი ენობრივი მოდელის (LLM) ოპტიმიზაციის პროცესი, რამაც გამოიწვია ინფერენციის შეყოვნების 5-ჯერ შემცირება და გამტარუნარიანობის 50-ჯერ გაზრდა. აღწერილია გამოწვევები, მათ შორის მოდელის `transformers` ბიბლიოთეკაში პორტირება, მკაცრი ტესტირების ნაკრების შექმნა, მონაცემთა სხვადასხვა ტიპებთან (bfloat16 vs float16) მუშაობა და ტენზორული პარალელიზმის საკითხები. საბოლოოდ, განიხილება ისეთი გადაწყვეტილებები, როგორიცაა `Megatron-Deepspeed` ტრენინგისთვის, მცირე მოდელების გამოყენე
DeepSpeed-ისა და FSDP-ის სიზუსტის გამოწვევები: როგორ მოაგვარა Accelerate-მა პრობლემა PyTorch-ის ტრენინგში
ბოლო დროს, DeepSpeed-ისა და PyTorch FSDP-ის გამოყენებით Mistral-7B მოდელის ტრენინგისას, აღმოჩნდა განსხვავებული შედეგები, რაც DeepSpeed-ის მიერ შიდა fp32 სიზუსტის გამოყენებით იყო გამოწვეული. 🤗 Accelerate-მა ამ პრობლემის მოსაგვარებლად FSDP-ისთვის ავტომატური upcasting-ის ფუნქცია დაამატა, რითაც უზრუნველყო ჩარჩოების უკეთესი შეთავსება და გააუმჯობესა ტრენინგის სტაბილურობა. სტატია დეტალურად განიხილავს ამ აღმოჩენებს, დანერგილ ცვლილებებს და გამტარუნარიანობის შედარებებს.