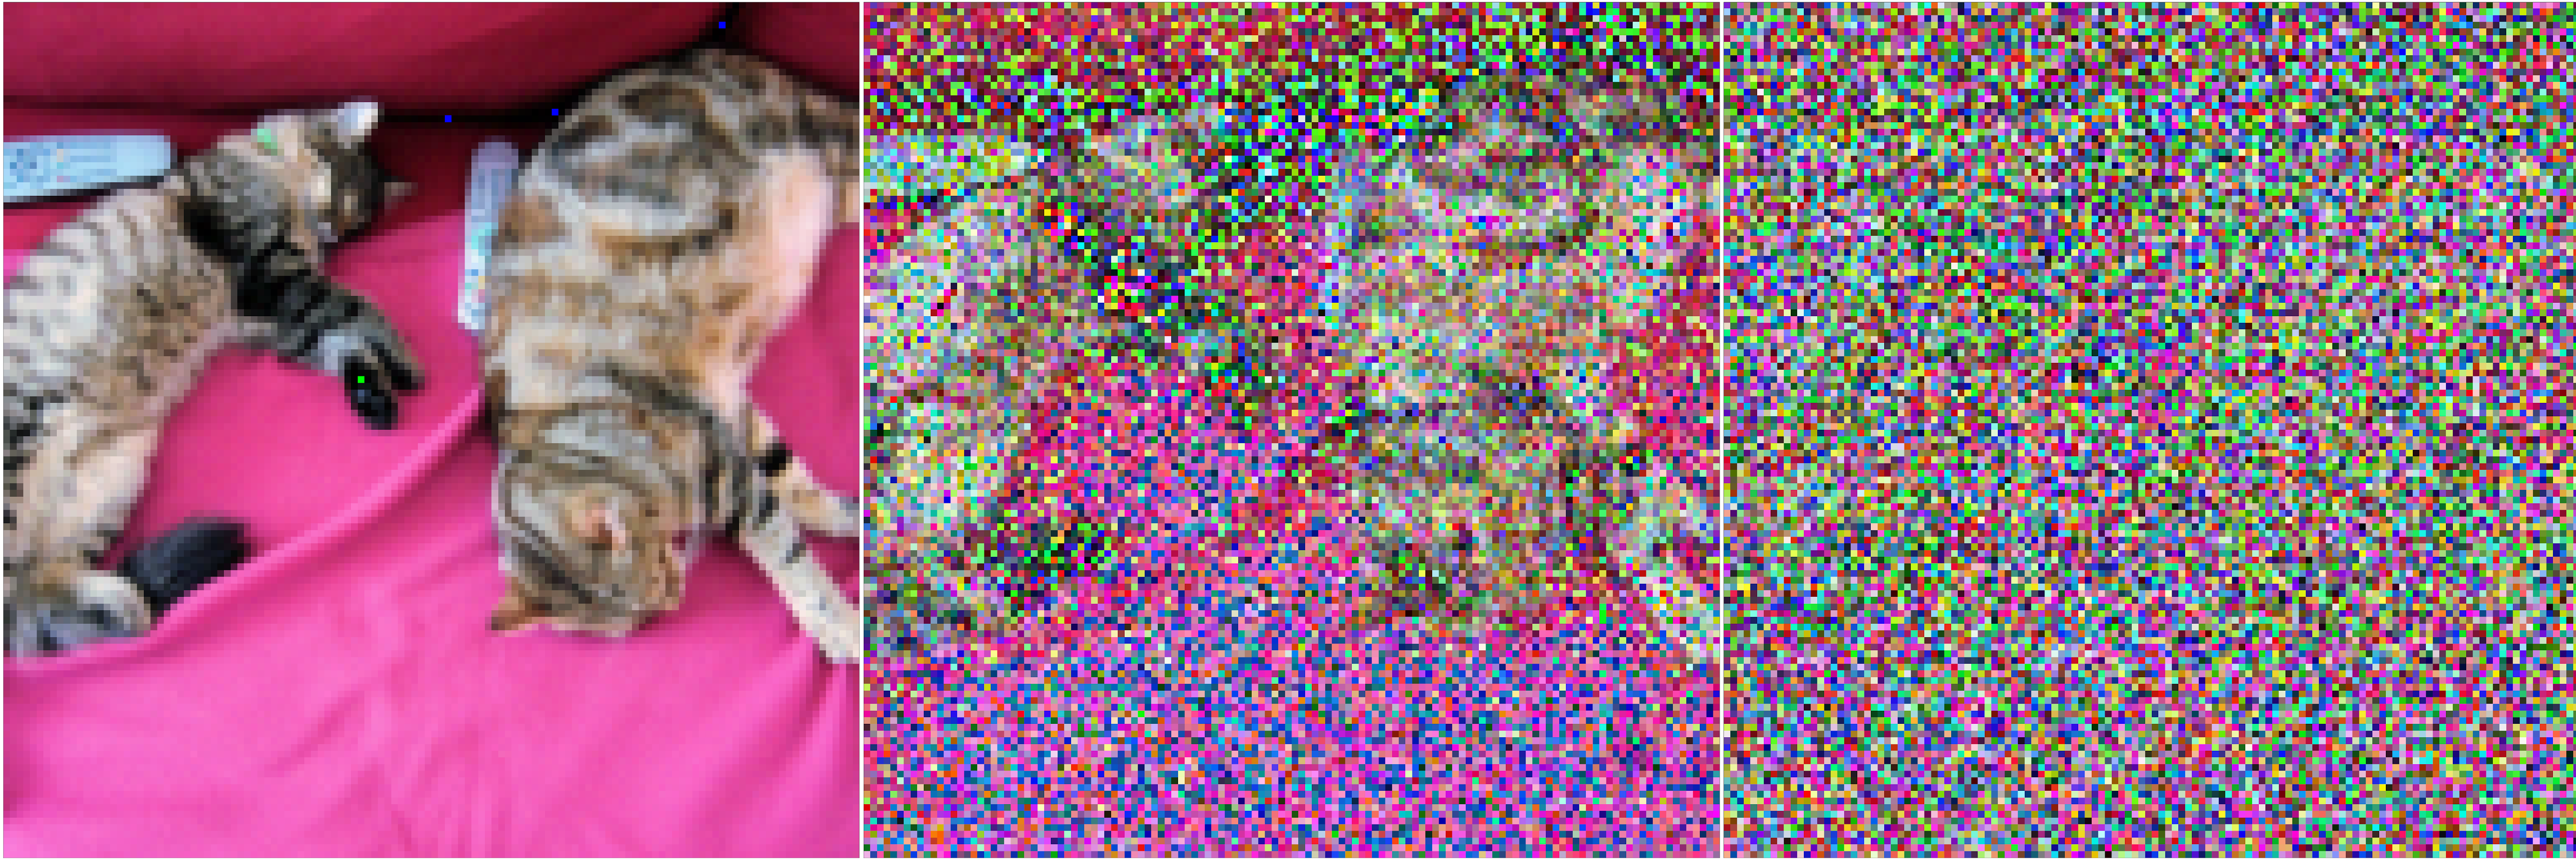
დენოიზინგ დიფუზიური ალბათური მოდელები (DDPM): კონცეფციიდან იმპლემენტაციამდე PyTorch-ში
ეს სტატია განიხილავს Ho et al.-ის (2020) ორიგინალური ნაშრომის მიხედვით დენოიზინგ დიფუზიურ ალბათურ მოდელებს (DDPM) და მათ ნაბიჯ-ნაბიჯ იმპლემენტაციას PyTorch-ში. იგი აშუქებს დიფუზიური მოდელების ისტორიულ კონტექსტს, მათ მათემატიკურ საფუძვლებს და ხსნის როგორც პირდაპირ, ასევე შებრუნებულ პროცესებს, რომლებიც საშუალებას აძლევს ნერვულ ქსელს გარდაქმნას ხმაურიანი მონაცემები რეალურ ნიმუშებად.
ჩვენ განვიხილავთ Ho et al.-ის (2020) ორიგინალურ DDPM ნაშრომს, ეტაპობრივად განვახორციელებთ მას PyTorch-ში, ფილ ვანგის იმპლემენტაციის საფუძველზე — რომელიც თავის მხრივ ეფუძნება ორიგინალურ TensorFlow იმპლემენტაციას. აღსანიშნავია, რომ გენერაციული მოდელირებისთვის დიფუზიის იდეა ფაქტობრივად უკვე შემოღებული იყო Sohl-Dickstein et al.-ის (2015) მიერ. თუმცა, მიდგომის დამოუკიდებელ გაუმჯობესებას დასჭირდა Song et al.-ის (2019) (სტენფორდის უნივერსიტეტი) და შემდეგ Ho et al.-ის (2020) (Google Brain) ნაშრომები. გაითვალისწინეთ, რომ დიფუზიური მოდელების შესახებ არსებობს რამდენიმე პერსპექტივა. აქ ჩვენ ვიყენებთ დისკრეტული დროის (ფარული ცვლადის მოდელი) პერსპექტივას, თუმცა აუცილებლად გაეცანით სხვა მიდგომებსაც. კარგი, დავიწყოთ!
პირველ რიგში დავაინსტალირებთ და შემოვიტანთ საჭირო ბიბლიოთეკებს (თუ PyTorch დაინსტალირებული გაქვთ). (დენოიზინგ) დიფუზიური მოდელი არც ისე კომპლექსურია, თუ მას შევადარებთ სხვა გენერაციულ მოდელებს, როგორიცაა Normalizing Flows, GANs ან VAEs: ყველა მათგანი გარდაქმნის ხმაურს მარტივი განაწილებიდან მონაცემთა ნიმუშად. ეს ასევე მოქმედებს აქაც, სადაც ნერვული ქსელი სწავლობს მონაცემების თანდათანობით დენოიზინგს სუფთა ხმაურიდან დაწყებული. გამოსახულებებისთვის უფრო დეტალურად, დაყენება შედგება 2 პროცესისგან:
როგორც პირდაპირი, ასევე შებრუნებული პროცესი, რომელიც ინდექსირებულია t-თი, ხდება სასრული დროის ნაბიჯების T რაოდენობისთვის (DDPM-ის ავტორები იყენებენ T=1000). თქვენ იწყებთ t=0-დან, სადაც იღებთ რეალურ გამოსახულებას x0-ს მონაცემთა განაწილებიდან (ვთქვათ, კატის გამოსახულება ImageNet-დან), და პირდაპირი პროცესი ყოველ t დროის ნაბიჯზე აგროვებს გარკვეულ ხმაურს გაუსის განაწილებიდან, რომელიც ემატება წინა დროის ნაბიჯის გამოსახულებას. საკმარისად დიდი T-ს და ხმაურის ყოველ ნაბიჯზე დამატების კარგად განსაზღვრული განრიგის გათვალისწინებით, თანდათანობითი პროცესის მეშვეობით, t=T-ზე მივიღებთ, რასაც იზოტროპულ გაუსის განაწილებას უწოდებენ. მოდით, ეს უფრო ფორმალურად ჩამოვწეროთ, რადგან საბოლოოდ გვჭირდება მოგებადი დანაკარგის ფუნქცია, რომლის ოპტიმიზაციაც ჩვენს ნერვულ ქსელს დასჭირდება. დაე, q(x0) იყოს რეალური მონაცემთა განაწილება, ვთქვათ, "რეალური გამოსახულებების". ჩვენ შეგვიძლია ავიღოთ ნიმუში ამ განაწილებიდან, რომ მივიღოთ გამოსახულება, x0∼q(x0). ჩვენ განვსაზღვრავთ პირდაპირ დიფუზიურ პროცესს q(xt∣xt−1), რომელიც ყოველ t დროის ნაბიჯზე ამატებს გაუსის ხმაურს, ცნობილი დისპერსიის განრიგის მიხედვით 0<β1<β2<...<βT<1, როგორც
q(xt∣xt−1)=N(xt;1−βtxt−1,βtI).
გავიხსენოთ, რომ ნორმალური განაწილება (ასევე გაუსის განაწილება) განისაზღვრება 2 პარამეტრით: საშუალო μ და დისპერსია σ2≥0. ძირითადად, ყოველი ახალი (ოდნავ უფრო ხმაურიანი) გამოსახულება t დროის ნაბიჯზე აღებულია პირობითი გაუსის განაწილებიდან μt=1−βtxt−1 და σt2=βt პარამეტრებით, რისი გაკეთებაც შეგვიძლია ϵ∼N(0,I) ნიმუშის აღებით და შემდეგ xt=1−βtxt−1+βtϵ დაყენებით. გაითვალისწინეთ, რომ βt არ არის მუდმივი ყოველ t დროის ნაბიჯზე (აქედან გამომდინარე ინდექსი) --- ფაქტობრივად, განისაზღვრება ე.წ. "დისპერსიის განრიგი", რომელიც შეიძლება იყოს წრფივი, კვადრატული, კოსინუსური და ა.შ., რასაც შემდგომში ვიხილავთ (ცოტათი სწავლის ტემპის განრიგის მსგავსად). ასე რომ, x0-დან დაწყებული, მივიღებთ x1,...,xt,...,xT-ს, სადაც xT არის სუფთა გაუსის ხმაური, თუ განრიგს შესაბამისად დავაყენებთ. ახლა, თუ ჩვენ გვეცოდინებოდა პირობითი განაწილება p(xt−1∣xt), მაშინ შეგვეძლო პროცესის შებრუნებით გაშვება: შემთხვევითი გაუსის ხმაურის xT-ის ნიმუშის აღებით, და შემდეგ თანდათანობით მისი "დენოიზინგით", რათა მივიღოთ ნიმუში რეალური განაწილებიდან x0. თუმცა, ჩვენ არ ვიცით p(xt−1∣xt). მისი გამოთვლა შეუძლებელია, რადგან მოითხოვს ყველა შესაძლო გამოსახულების განაწილების ცოდნას ამ პირობითი ალბათობის გამოსათვლელად. ამიტომ, ჩვენ გამოვიყენებთ ნერვულ ქსელს ამ პირობითი ალბათობის განაწილების მიახლოებისთვის (სწავლისთვის), მოდით ვუწოდოთ მას pθ(xt−1∣xt), სადაც θ არის ნერვული ქსელის პარამეტრები, რომლებიც განახლდება გრადიენტული დაშვების (gradient descent) გზით. კარგი, ასე რომ, ჩვენ გვჭირდება ნერვული ქსელი შებრუნებული პროცესის (პირობითი) ალბათობის განაწილების წარმოსადგენად. თუ ვივარაუდებთ, რომ ეს შებრუნებული პროცესიც გაუსისებურია, მაშინ გავიხსენოთ, რომ ნებისმიერი გაუსის განაწილება განისაზღვრება 2 პარამეტრით: ასე რომ, ჩვენ შეგვიძლია პროცესის პარამეტრიზაცია შემდეგნაირად მოვახდინოთ:
pθ(xt−1∣xt)=N(xt−1;μθ(xt,t),Σθ(xt,t))
თეგები:
#ხელოვნური ინტელექტი
#კვლევა
#მანქანური სწავლება
#ტექნოლოგია
#გენერაციული ai
#ნერვული ქსელები
#დიფუზიური მოდელები
#pytorch
#ddpm
წყარო: huggingface.co
AI-ით გადამუშავებული
მსგავსი სტატიები

ხელოვნური ინტელექტი
Anthropic-ის Claude-ის აღზევება Apple App Store-ის რეიტინგებში პენტაგონთან მოლაპარაკებების ფონზე

ხელოვნური ინტელექტი
ტრამპის ადმინისტრაცია Anthropic-ს სანქციებს უწესებს ხელოვნური ინტელექტის გამოყენებაზე უარის გამო: ექსპერტი ინდუსტრიის უსაფრთხოების ხარვეზებზე საუბრობს
ხელოვნური ინტელექტი