გაძლიერებითი სწავლის (RL) გამოყენება დიფუზიური მოდელების გასაუმჯობესებლად: DDPO-ს როლი ხელოვნური ინტელექტის მიერ შექმნილი გამოსახულებების ადამიანურ პრეფერენციებთან შესაბამისობაში
სტატია განიხილავს, თუ როგორ ხდება დიფუზიური მოდელების (მაგ. DALL-E 2, Stable Diffusion) ოპტიმიზაცია გაძლიერებითი სწავლის (RL) გამოყენებით, რათა მათ მიერ გენერირებული გამოსახულებები უკეთესად შეესაბამებოდეს ადამიანის პრეფერენციებსა და ესთეტიკას. ის მიმოიხილავს "შესაბამისობის პრობლემას" ხელოვნურ ინტელექტში და წარმოაჩენს Denoising Diffusion Policy Optimization (DDPO) მეთოდს, როგორც ეფექტურ გადაწყვეტას. DDPO, რომელიც იყენებს პოლიტიკის გრადიენტულ მეთოდებს (PPO) და დენოიზინგის პროცესს მარკოვის გადაწყვე
SegMoE მოდელების გამოშვება: როგორ გავაერთიანოთ დიფუზიური მოდელები მარტივად
SegMoE წარმოადგენს ახალ მიდგომას დიფუზიური მოდელების შექმნაში, რომელიც სტეიბლ დიფუჟენის არქიტექტურას ეფუძნება და Mixtral 8x7b-ის მსგავსად, რამდენიმე მოდელს ერთში აერთიანებს. ის Feed-Forward შრეებს ცვლის იშვიათი MoE შრით, რომელიც ექსპერტთა როუტერულ ქსელს იყენებს. SegMoE პაკეტით შესაძლებელია საკუთარი MoE მოდელების მარტივად შექმნა, რაც აუმჯობესებს პრომპტების გაგებას. მოდელი მხარს უჭერს Hugging Face-ისა და CivitAI-ის პლატფორმებს. თუმცა, მას აქვს შეზღუდვები, როგორიცაა ნელი სიჩქარე და VRAM-ის მაღალი მ
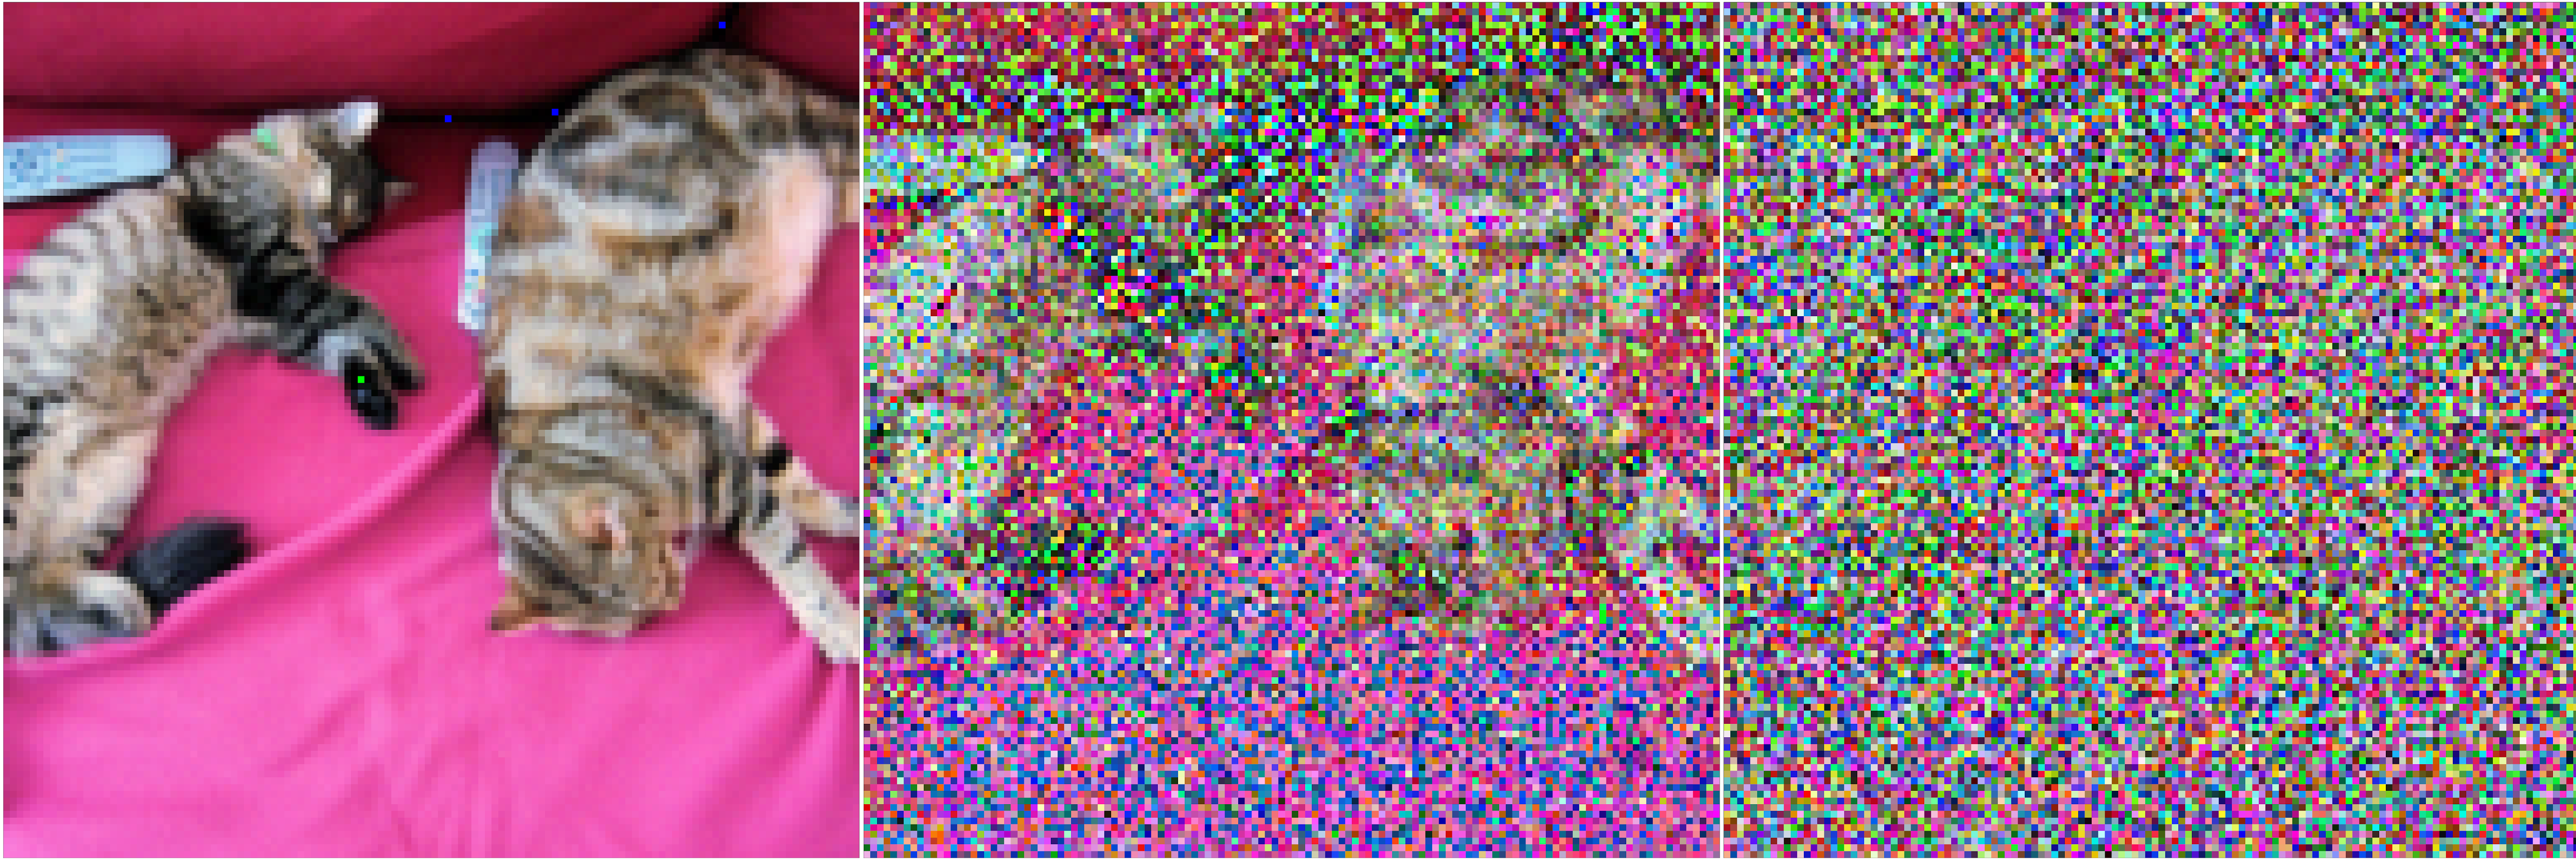
დენოიზინგ დიფუზიური ალბათური მოდელები (DDPM): კონცეფციიდან იმპლემენტაციამდე PyTorch-ში
ეს სტატია განიხილავს Ho et al.-ის (2020) ორიგინალური ნაშრომის მიხედვით დენოიზინგ დიფუზიურ ალბათურ მოდელებს (DDPM) და მათ ნაბიჯ-ნაბიჯ იმპლემენტაციას PyTorch-ში. იგი აშუქებს დიფუზიური მოდელების ისტორიულ კონტექსტს, მათ მათემატიკურ საფუძვლებს და ხსნის როგორც პირდაპირ, ასევე შებრუნებულ პროცესებს, რომლებიც საშუალებას აძლევს ნერვულ ქსელს გარდაქმნას ხმაურიანი მონაცემები რეალურ ნიმუშებად.

დიფუზიური მოდელების ეფექტური წვრილი დარეგულირება QLoRA-ით: 10 GB VRAM-ზე ნაკლები მოხმარება
წინა პოსტში კვანტიზაციის ტექნიკების განხილვის შემდეგ, ეს პოსტი ყურადღებას ამახვილებს დიფუზიური მოდელების, კერძოდ FLUX.1-dev-ის, ეფექტურ წვრილ დარეგულირებაზე (fine-tuning) QLoRA მეთოდის გამოყენებით. მიზანია, მივაღწიოთ 10 GB-ზე ნაკლებ VRAM მოხმარებას ერთ GPU-ზე, რაც ხელმისაწვდომს გახდის ამ პროცესს სამომხმარებლო აპარატურაზე. განიხილება ისეთი ტექნიკები, როგორიცაა 8-ბიტიანი AdamW ოპტიმიზატორი, გრადიენტის შემოწმება (gradient checkpointing) და ლატენტების ქეშირება (cache latents), რათა FLUX.1-dev-მა ალფ
გეპატიჟებით Stable Diffusion-ის შემქმნელებთან და ხელოვნური ინტელექტის მკვლევრებთან შეხვედრაზე!
ამ გამოშვებასთან ერთად, 30 ნოემბერს ვმართავთ ცოცხალ საზოგადოებრივ ღონისძიებას, რომელზეც გეპატიჟებით! პროგრამა მოიცავს საინტერესო მოხსენებებს Stable Diffusion-ის შემქმნელებისგან, Stability AI-ისა და Meta-ს მკვლევრებისგან, ასევე სხვა ექსპერტებისგან! რეგისტრაციისთვის, გთხოვთ, შეავსოთ ეს ფორმა. სპიკერებისა და მოხსენებების შესახებ დამატებითი დეტალები მოცემულია ქვემოთ. მოხსენებები ფოკუსირებული იქნება დიფუზიური მოდელების მაღალი დონის პრეზენტაციაზე და იმ ინსტრუმენტებზე, რომელთა გამოყენებაც შეგვიძლია მათ