Dreambooth-ის ოპტიმიზაცია: ექსპერიმენტული მიგნებები და რჩევები Stable Diffusion-ისთვის
ამ პოსტში წარმოდგენილია Dreambooth-ის პარამეტრების ანალიზის შედეგები Stable Diffusion-ის დახვეწისას. მოცემულია რჩევები საუკეთესო შედეგების მისაღებად, მათ შორის სწავლის ტემპისა და სწავლის ნაბიჯების ოპტიმიზაცია, 'prior preservation' ტექნიკის გამოყენება, შესაბამისი განრიგის (scheduler) არჩევა (როგორიცაა DDIM) და ტექსტის ენკოდერის დახვეწის მნიშვნელობა, განსაკუთრებით სახეების დამუშავებისას. ხაზგასმულია მეთოდის ეთიკური გამოყენების აუცილებლობა.
ჩვენ ჩავატარეთ მრავალი ექსპერიმენტი Dreambooth-ის სხვადასხვა პარამეტრების ეფექტის გასაანალიზებლად. ეს პოსტი წარმოადგენს ჩვენს მიგნებებს და რამდენიმე რჩევას, რათა გააუმჯობესოთ თქვენი შედეგები Stable Diffusion-ის Dreambooth-ით დახვეწისას. სანამ დავიწყებთ, გთხოვთ გაითვალისწინოთ, რომ ეს მეთოდი არასდროს არ უნდა იქნას გამოყენებული მავნე მიზნებისთვის, რაიმე სახის ზიანის მისაღებად, ან ადამიანების მათი ნებართვის გარეშე განსახიერებისთვის. მისით გაწვრთნილი მოდელები კვლავაც ექვემდებარებიან CreativeML Open RAIL-M ლიცენზიას, რომელიც არეგულირებს Stable Diffusion მოდელების დისტრიბუციას.
შენიშვნა: ამ პოსტის წინა ვერსია გამოქვეყნდა W&B მოხსენების სახით.
Dreambooth ძალიან სწრაფად მიდის 'overfit'-მდე (გადამეტებული მორგება). კარგი შედეგების მისაღებად, დაარეგულირეთ სწავლის ტემპი ('learning rate') და სწავლის ნაბიჯების რაოდენობა ('training steps') ისე, რომ ეს გამართლებული იყოს თქვენი მონაცემთა ნაკრებისთვის. ჩვენს ექსპერიმენტებში (დეტალურად ქვემოთ), ჩვენ დავხვეწეთ ოთხ სხვადასხვა მონაცემთა ნაკრებზე მაღალი და დაბალი სწავლის ტემპებით. ყველა შემთხვევაში, უკეთესი შედეგები მივიღეთ დაბალი სწავლის ტემპით. ყველა ჩვენი ექსპერიმენტი ჩატარდა train_dreambooth.py სკრიპტის გამოყენებით AdamW ოპტიმიზატორით 2x 40GB A100-ზე. ჩვენ გამოვიყენეთ ერთი და იგივე 'seed' და შევინარჩუნეთ ყველა ჰიპერპარამეტრი თანაბარი გაშვებებს შორის, გარდა LR-ისა, სწავლის ნაბიჯების რაოდენობისა და 'prior preservation'-ის გამოყენებისა.
პირველი 3 მაგალითისთვის (სხვადასხვა ობიექტები), ჩვენ დავხვეწეთ მოდელი ბATCH ზომით 4 (2 GPU-ზე) 400 ნაბიჯის განმავლობაში. ჩვენ გამოვიყენეთ მაღალი სწავლის ტემპი 5e-6 და დაბალი სწავლის ტემპი 2e-6. 'Prior preservation' არ გამოგვიყენებია. უკანასკნელი ექსპერიმენტი ცდილობს მოდელში ადამიანის სუბიექტის დამატებას. ამ შემთხვევაში, ჩვენ გამოვიყენეთ 'prior preservation' ბATCH ზომით 2 (1 GPU-ზე), 800 და 1200 ნაბიჯით. ჩვენ გამოვიყენეთ მაღალი სწავლის ტემპი 5e-6 და დაბალი სწავლის ტემპი 2e-6. გაითვალისწინეთ, რომ შეგიძლიათ გამოიყენოთ 8-ბიტიანი Adam, fp16 ტრენინგი ან გრადიენტის აკუმულაცია მეხსიერების მოთხოვნების შესამცირებლად და მსგავსი ექსპერიმენტების გასაშვებად 16 GB მეხსიერების მქონე GPU-ებზე.
მაღალი სწავლის ტემპი (5e-6)
დაბალი სწავლის ტემპი (2e-6)
მაღალი სწავლის ტემპი (5e-6). გაითვალისწინეთ, რომ ფერის არტეფაქტები ხმაურის ნარჩენებია – ინფერენსის მეტი ნაბიჯის გაშვება დაგვეხმარება ამ დეტალების ნაწილის გარკვევაში.
დაბალი სწავლის ტემპი (2e-6)
მაღალი სწავლის ტემპი (5e-6). გაითვალისწინეთ, რომ ფერის არტეფაქტები ხმაურის ნარჩენებია – ინფერენსის მეტი ნაბიჯის გაშვება დაგვეხმარება ამ დეტალების ნაწილის გარკვევაში.
დაბალი სწავლის ტემპი (2e-6)
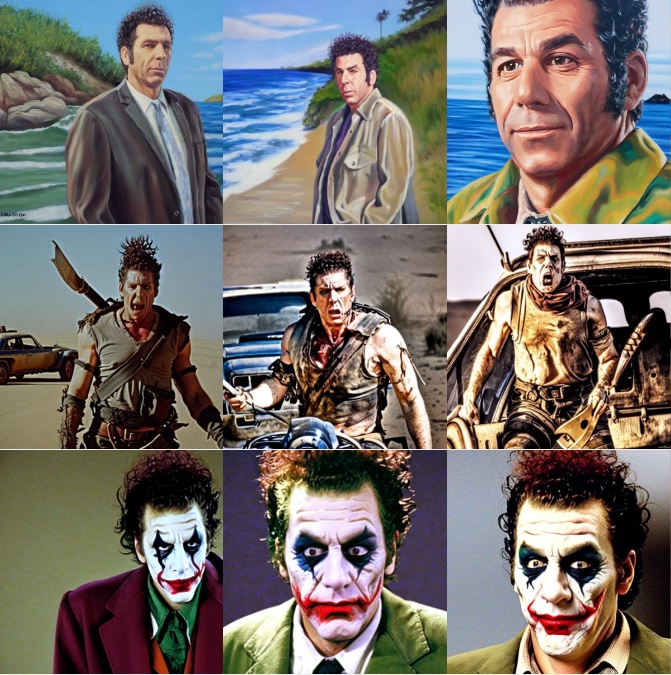
ჩვენ ვცადეთ Kramer-ის პერსონაჟის Seinfeld-დან Stable Diffusion-ში ჩართვა. როგორც აღვნიშნეთ, ჩვენ ვავარჯიშეთ მეტი ნაბიჯით, უფრო მცირე ბATCH ზომით. მიუხედავად ამისა, შედეგები გამორჩეული არ იყო. მოკლეობის გამო, ჩვენ გამოვტოვეთ ეს ნიმუში სურათები და მკითხველს გადავამისამართებთ შემდეგ სექციებზე, სადაც სახის ვარჯიში გახდა ჩვენი ძალისხმევის ფოკუსი.
კარგი შედეგების მისაღებად Stable Diffusion-ის Dreambooth-ით ვარჯიშისას, მნიშვნელოვანია სწავლის ტემპისა და სწავლის ნაბიჯების დარეგულირება თქვენი მონაცემთა ნაკრებისთვის. სახეების ვარჯიში უფრო რთულია. ჩვენს ექსპერიმენტებში, სწავლის ტემპი 2e-6 400 სწავლის ნაბიჯით კარგად მუშაობს ობიექტებისთვის, მაგრამ სახეებს დასჭირდა 1e-6 (ან 2e-6) ~1200 ნაბიჯით. გამოსახულების ხარისხი საგრძნობლად უარესდება, თუ მოდელი გადამეტებულად ერგება (overfits), და ეს ხდება თუ:
'Prior preservation' არის ტექნიკა, რომელიც იყენებს დამატებით სურათებს იმავე კლასიდან, რომელსაც ვცდილობთ გავწვრთნათ დახვეწის პროცესის ნაწილად. მაგალითად, თუ ვცდილობთ მოდელში ახალი ადამიანის ჩართვას, კლასი, რომლის შენარჩუნებაც გვსურს, შეიძლება იყოს ადამიანი. 'Prior preservation' ცდილობს შეამციროს გადამეტებული მორგება ახალი ადამიანის ფოტოების სხვა ადამიანების ფოტოებთან კომბინაციით. სასიამოვნოა ის, რომ ამ დამატებითი კლასის სურათების გენერირება შეგვიძლია თავად Stable Diffusion მოდელის გამოყენებით! ტრენინგის სკრიპტი ამას ავტომატურად უზრუნველყოფს, თუკი თქვენ გსურთ, მაგრამ ასევე შეგიძლიათ მიაწოდოთ საქაღალდე თქვენი საკუთარი 'prior preservation' სურათებით.
Prior preservation, 1200 ნაბიჯი, lr=2e-6.
Prior preservation-ის გარეშე, 1200 ნაბიჯი, lr=2e-6.
როგორც ხედავთ, შედეგები უკეთესია, როდესაც გამოიყენება 'prior preservation', მაგრამ მაინც არის ხმაურიანი ლაქები. დროა დამატებითი ხრიკებისთვის! წინა მაგალითებში, ჩვენ გამოვიყენეთ PNDM განრიგი ინფერენსის პროცესში სურათების შესარჩევად. ჩვენ დავაკვირდით, რომ როდესაც მოდელი გადამეტებულად ერგება, DDIM, როგორც წესი, ბევრად უკეთ მუშაობს, ვიდრე PNDM და LMSDiscrete. გარდა ამისა, ხარისხი შეიძლება გაუმჯობესდეს ინფერენსის მეტი ნაბიჯის გაშვებით: 100 ნაბიჯი კარგ არჩევანად ჩანს. დამატებითი ნაბიჯები ხელს უწყობს ხმაურის ზოგიერთი ლაქის გამოსახულების დეტალებად გარდაქმნას.
PNDM, Kramer-ის სახე
LMSDiscrete, Kramer-ის სახე. შედეგები საშინელია!
DDIM, Kramer-ის სახე. ბევრად უკეთესი
მსგავსი ქცევა შეიძლება შეინიშნოს სხვა სუბიექტებისთვისაც, თუმცა ნაკლები ხარისხით.
PNDM, Potato Head
LMSDiscrete, Potato Head
DDIM, Potato Head
Dreambooth-ის ორიგინალი ნაშრომი აღწერს მეთოდს UNet კომპონენტის დახვეწისთვის, მაგრამ ტექსტის ენკოდერს გაყინულ მდგომარეობაში ტოვებს. თუმცა, ჩვენ დავაკვირდით, რომ ენკოდერის დახვეწა უკეთეს შედეგებს იძლევა. ჩვენ ვცადეთ ეს მიდგომა მას შემდეგ, რაც ის სხვა Dreambooth იმპლემენტაციებში ვნახეთ, და შედეგები შთამბეჭდავია!
გაყინული ტექსტის ენკოდერი
დახვეწილი ტექსტის ენკოდერი
ტექსტის ენკოდერის დახვეწა იძლევა საუკეთესო შედეგებს, განსაკუთრებით სახეებთან მიმართებაში. ის წარმოქმნის უფრო რეალისტურ გამოსახულებებს, ნაკლებად მიდრეკილია გადამეტებული მორგებისკენ და ასევე აღწევს უკეთეს 'prompt'-ის ინტერპრეტაციას.
თეგები:
#ხელოვნური ინტელექტი
#მანქანური სწავლება
#გენერაციული ai
#დახვეწა
#stable diffusion
#dreambooth
#სწავლის ტემპი
#ტრენინგის ნაბიჯები
#prior preservation
#ტექსტის ენკოდერი
წყარო: huggingface.co
AI-ით გადამუშავებული
მსგავსი სტატიები

ხელოვნური ინტელექტი
Anthropic-ის Claude-ის აღზევება Apple App Store-ის რეიტინგებში პენტაგონთან მოლაპარაკებების ფონზე

ხელოვნური ინტელექტი
ტრამპის ადმინისტრაცია Anthropic-ს სანქციებს უწესებს ხელოვნური ინტელექტის გამოყენებაზე უარის გამო: ექსპერტი ინდუსტრიის უსაფრთხოების ხარვეზებზე საუბრობს
ხელოვნური ინტელექტი