
GNOME 50: ნელი ევოლუცია და მნიშვნელოვანი სიახლეები 'კაპოტის ქვეშ'
GNOME-ის ევოლუცია ნელი, თუმცა თანმიმდევრული პროცესია. GNOME 50-ის უახლესი ვერსია დრამატული ინტერფეისის ცვლილებების ნაცვლად, მნიშვნელოვან შიდა გაუმჯობესებებს გვთავაზობს. ძირითადი სიახლეები მოიცავს X11-ის ოფიციალურ ჩანაცვლებას Wayland-ით, ფრაქციულ სკალირებას, GPU-ს გაუმჯობესებულ დეტექციას, Orca ეკრანის წამკითხველის განახლებებს და systemd-homed-ის დანერგვას. გამოცემის ფილოსოფია არსებულის დახვეწასა და ძირითადი ფუნქციების გაუმჯობესებაზეა ორიენტირებული, რათა უზრუნველყოფილი იყოს უკეთესი წარმადობა, უსაფ
Stable Diffusion-ის დახვეწა Intel Sapphire Rapids CPU-ებზე: ახალი შესაძლებლობები ღრმა სწავლისთვის
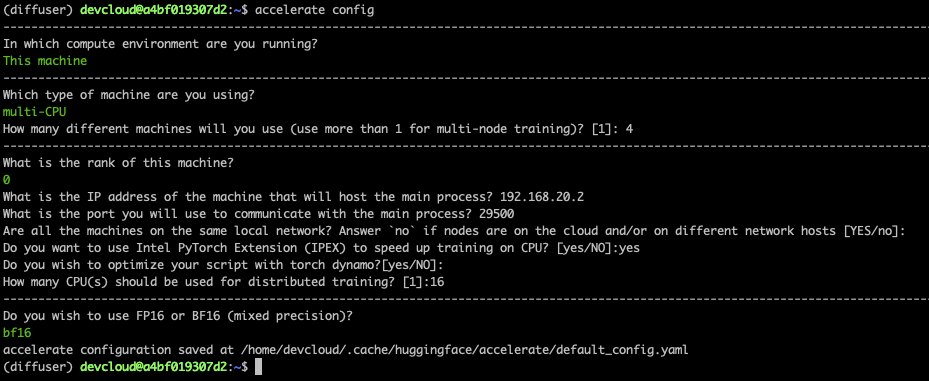
Intel-მა წარმოადგინა Xeon CPU-ების მეოთხე თაობა, Sapphire Rapids, რომელიც მოიცავს Intel Advanced Matrix Extensions (AMX) აჩქარებელს ღრმა სწავლისთვის. ეს სტატია დეტალურად აღწერს, თუ როგორ შეიძლება Stable Diffusion მოდელების დახვეწა (fine-tuning) Intel Sapphire Rapids CPU კლასტერზე, ტექსტური ინვერსიის გამოყენებით. პროცესი მოიცავს სისტემის დაყენებას Intel Developer Cloud-ზე, პროგრამული დამოკიდებულებების კონფიგურაციას (მათ შორის Intel-ის ბიბლიოთეკები oneCCL და IPEX) და განაწილებულ სწავლებას მინიმალუ

DeepSeek-R1 მოდელების გამოშვება და განთავსება AWS-სა და Hugging Face-ზე: ახალი შესაძლებლობები ხელოვნურ ინტელექტში
DeepSeek-მა გამოუშვა თავისი DeepSeek-R1 მოდელი, რომელიც მნიშვნელოვნად აუმჯობესებს მსჯელობითი ამოცანების გადაჭრას, როგორიცაა მათემატიკა და კოდირება, OpenAI-ის მსგავსად. Hugging Face, Amazon Web Services-თან თანამშრომლობით, დეველოპერებს სთავაზობს ამ მოდელების მარტივად განთავსებასა და დახვეწას AWS სერვისებზე, მათ შორის Inference Endpoints-სა და Amazon SageMaker-ზე. სტატია დეტალურად აღწერს განთავსების პროცესს Python SageMaker SDK-ისა და Jumpstart-ის გამოყენებით, ასევე Neuron ინსტანციებზე, რაც ხელს უ
პირდაპირი უპირატესობის ოპტიმიზაცია (DPO) LLM-ების დახვეწას ამარტივებს
ეს სტატია წარმოგიდგენთ პირდაპირი უპირატესობის ოპტიმიზაციის (DPO) მეთოდს, რომელიც მნიშვნელოვნად ამარტივებს დიდი ენობრივი მოდელების (LLM) დახვეწის პროცესს. ტრადიციული გაძლიერებითი სწავლისგან ადამიანის უკუკავშირით (RLHF) განსხვავებით, DPO გამორიცხავს ჯილდოს მოდელის შექმნის კომპლექსურ საფეხურს და RL ოპტიმიზაციას, პირდაპირ ახდენს ენობრივი მოდელის ოპტიმიზაციას უპირატესობის მონაცემებზე, ბინარული კროს-ენტროპიის დანაკარგის გამოყენებით. ეს მიდგომა ვარჯიშს უფრო ეფექტურს და ნაკლებად პრობლემურს ხდის, რაც შეს
Hugging Face Transformers-ისა და AWS SageMaker-ის ინტეგრაცია: მარტივი და სწრაფი AI მოდელების ტრენინგი
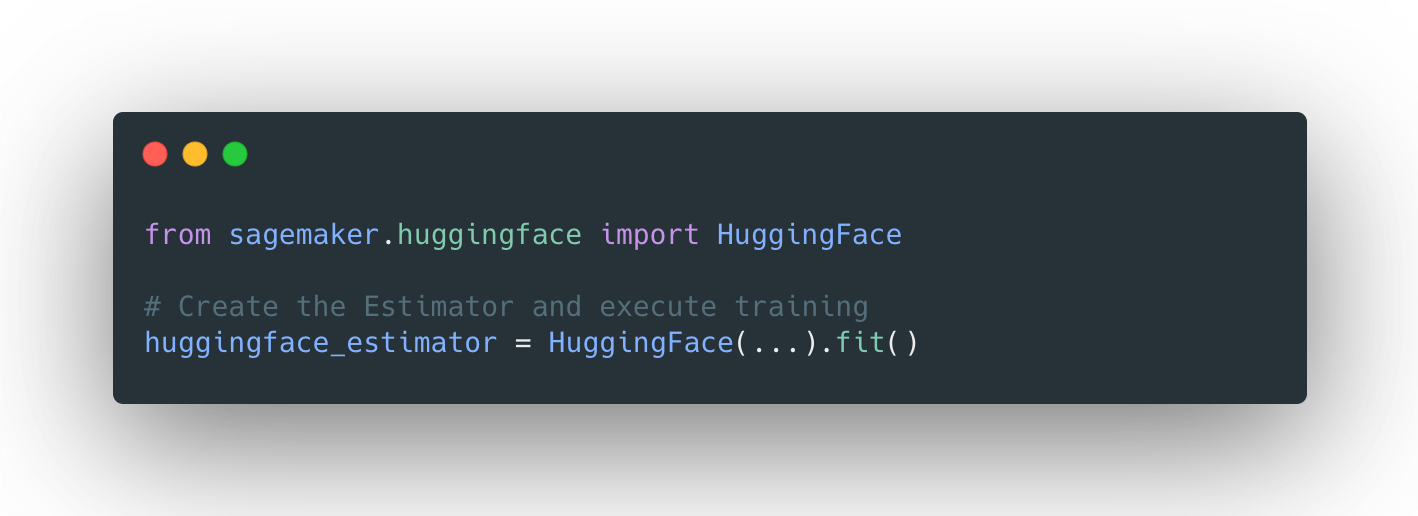
Hugging Face-ისა და AWS SageMaker-ის გუნდებმა ერთობლივად შექმნეს Transformers-ის ოპტიმიზებული ღრმა სწავლების კონტეინერები, რაც მნიშვნელოვნად აჩქარებს Transformers-ზე დაფუძნებული მოდელების ტრენინგს. ახალი HuggingFace estimator-ის წყალობით SageMaker Python SDK-ში, ტრენინგის დაწყება კოდის ერთი ხაზითაა შესაძლებელი. ეს ინტეგრაცია დეტალურად აღწერილია ბლოგ-პოსტში, რომელიც მოიცავს დაწყების მაგალითებსა და დოკუმენტაციას. სტატია განმარტავს, თუ როგორ ხდება Facebook-ის BART-large-cnn მოდელის დახვეწა Samsum მ

როგორ დავხვეწოთ Llama 2 70B PyTorch FSDP-ის გამოყენებით: საუკეთესო პრაქტიკები და გამოწვევების გადაჭრა
ეს ბლოგპოსტი დეტალურად განიხილავს Llama 2 70B მოდელის დახვეწას PyTorch FSDP-ის გამოყენებით. სტატია ფოკუსირებულია ძირითად გამოწვევებზე, როგორიცაა CPU RAM-ის გადატვირთვა, შუალედური ჩეკპოინტების შენახვის სირთულეები და VRAM-ის მოხმარების ოპტიმიზაცია. წარმოდგენილია გადაწყვეტები Hugging Face Transformers, Accelerate და TRL ინსტრუმენტების მეშვეობით, ასევე განხილულია Accelerate-ის გამოყენება SLURM-თან ერთად. მოცემულია საჭირო რესურსები და კონფიგურაციები შედეგების რეპროდუცირებისთვის.
Llama 2 70B-ის დახვეწა PyTorch FSDP-ის გამოყენებით: საუკეთესო პრაქტიკა და გამოწვევების გადაწყვეტა
ამ ბლოგ-პოსტში განხილულია Llama 2 70B მოდელის დახვეწის პროცესი PyTorch FSDP-ის გამოყენებით, Hugging Face Transformers, Accelerate და TRL ინსტრუმენტების მოშველიებით. დეტალურად არის აღწერილი FSDP-ის მოქმედების პრინციპი, რომელიც ოპტიმიზატორის მდგომარეობებს, გრადიენტებსა და პარამეტრებს მოწყობილობებს შორის ანაწილებს. ასევე, განხილულია ძირითადი გამოწვევები, როგორიცაა CPU RAM-ის მაღალი მოთხოვნები, შუალედური საკონტროლო წერტილების ნელი შენახვა და NCCL Timeout შეცდომები. სტატია გვთავაზობს გადაწყვეტებს ტრე
CLIP მოდელის დახვეწა სატელიტური გამოსახულებებისთვის: Hugging Face-ის საზოგადოებრივი კვირეულის პროექტი
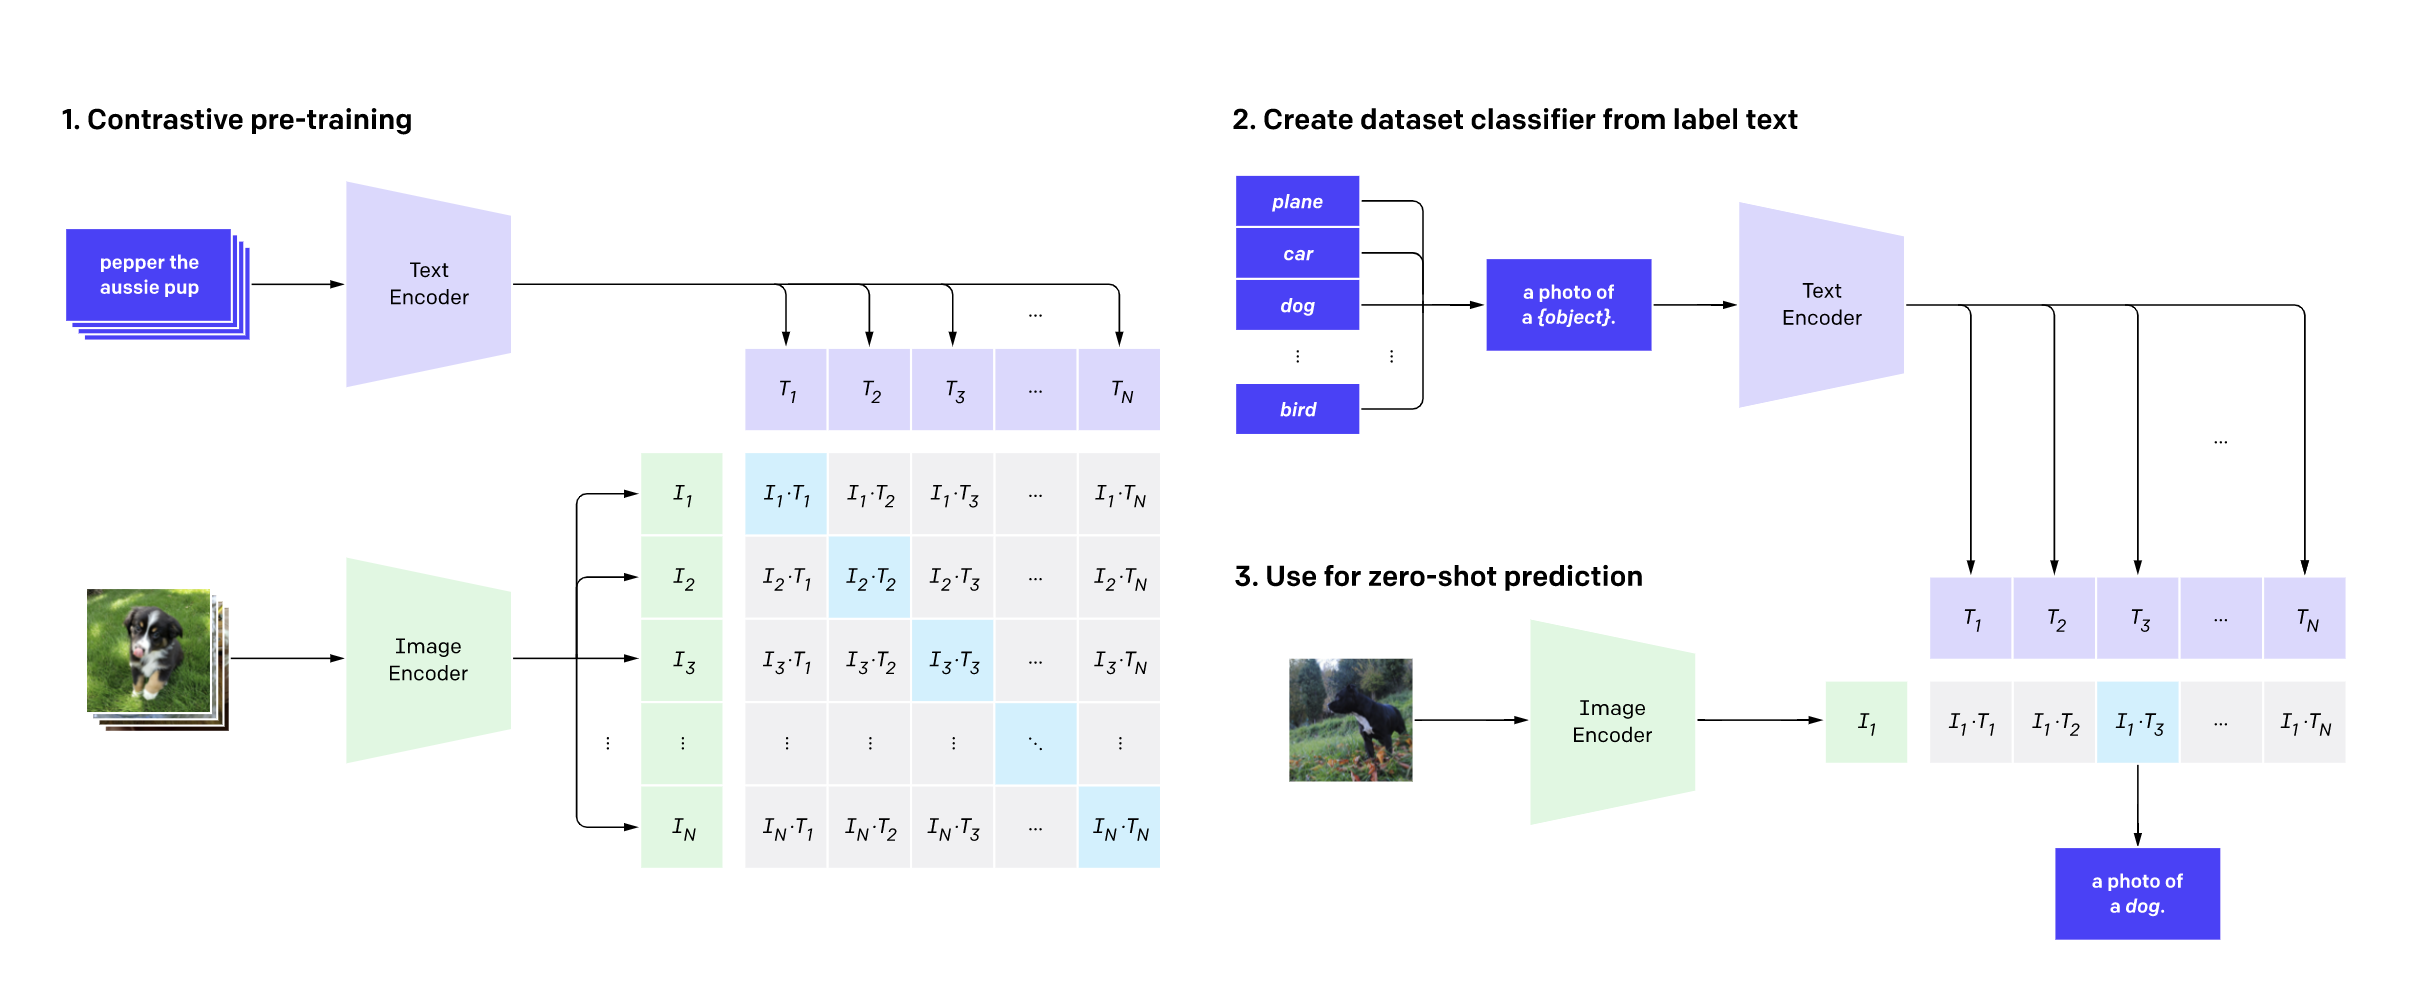
მიმდინარე წლის ივლისში Hugging Face-მა მოაწყო Flax/JAX საზოგადოებრივი კვირეული, სადაც მონაწილეებმა გამოიყენეს Tensor Processing Units (TPU) Flax-ისა და JAX-ის საშუალებით, რათა გაეწვრთნათ Hugging Face ტრანსფორმერების მოდელები ბუნებრივი ენის დამუშავებისა და კომპიუტერული ხედვის სფეროებში. ჩვენმა გუნდმა OpenAI-ის CLIP ქსელი დახვეწა RSICD, UCM და სიდნეის მონაცემთა ნაკრებებიდან მიღებული სატელიტური გამოსახულებებითა და აღწერებით. პროექტის მიზანი იყო სატელიტური გამოსახულებების დიდი კოლექციების ტექსტური მ
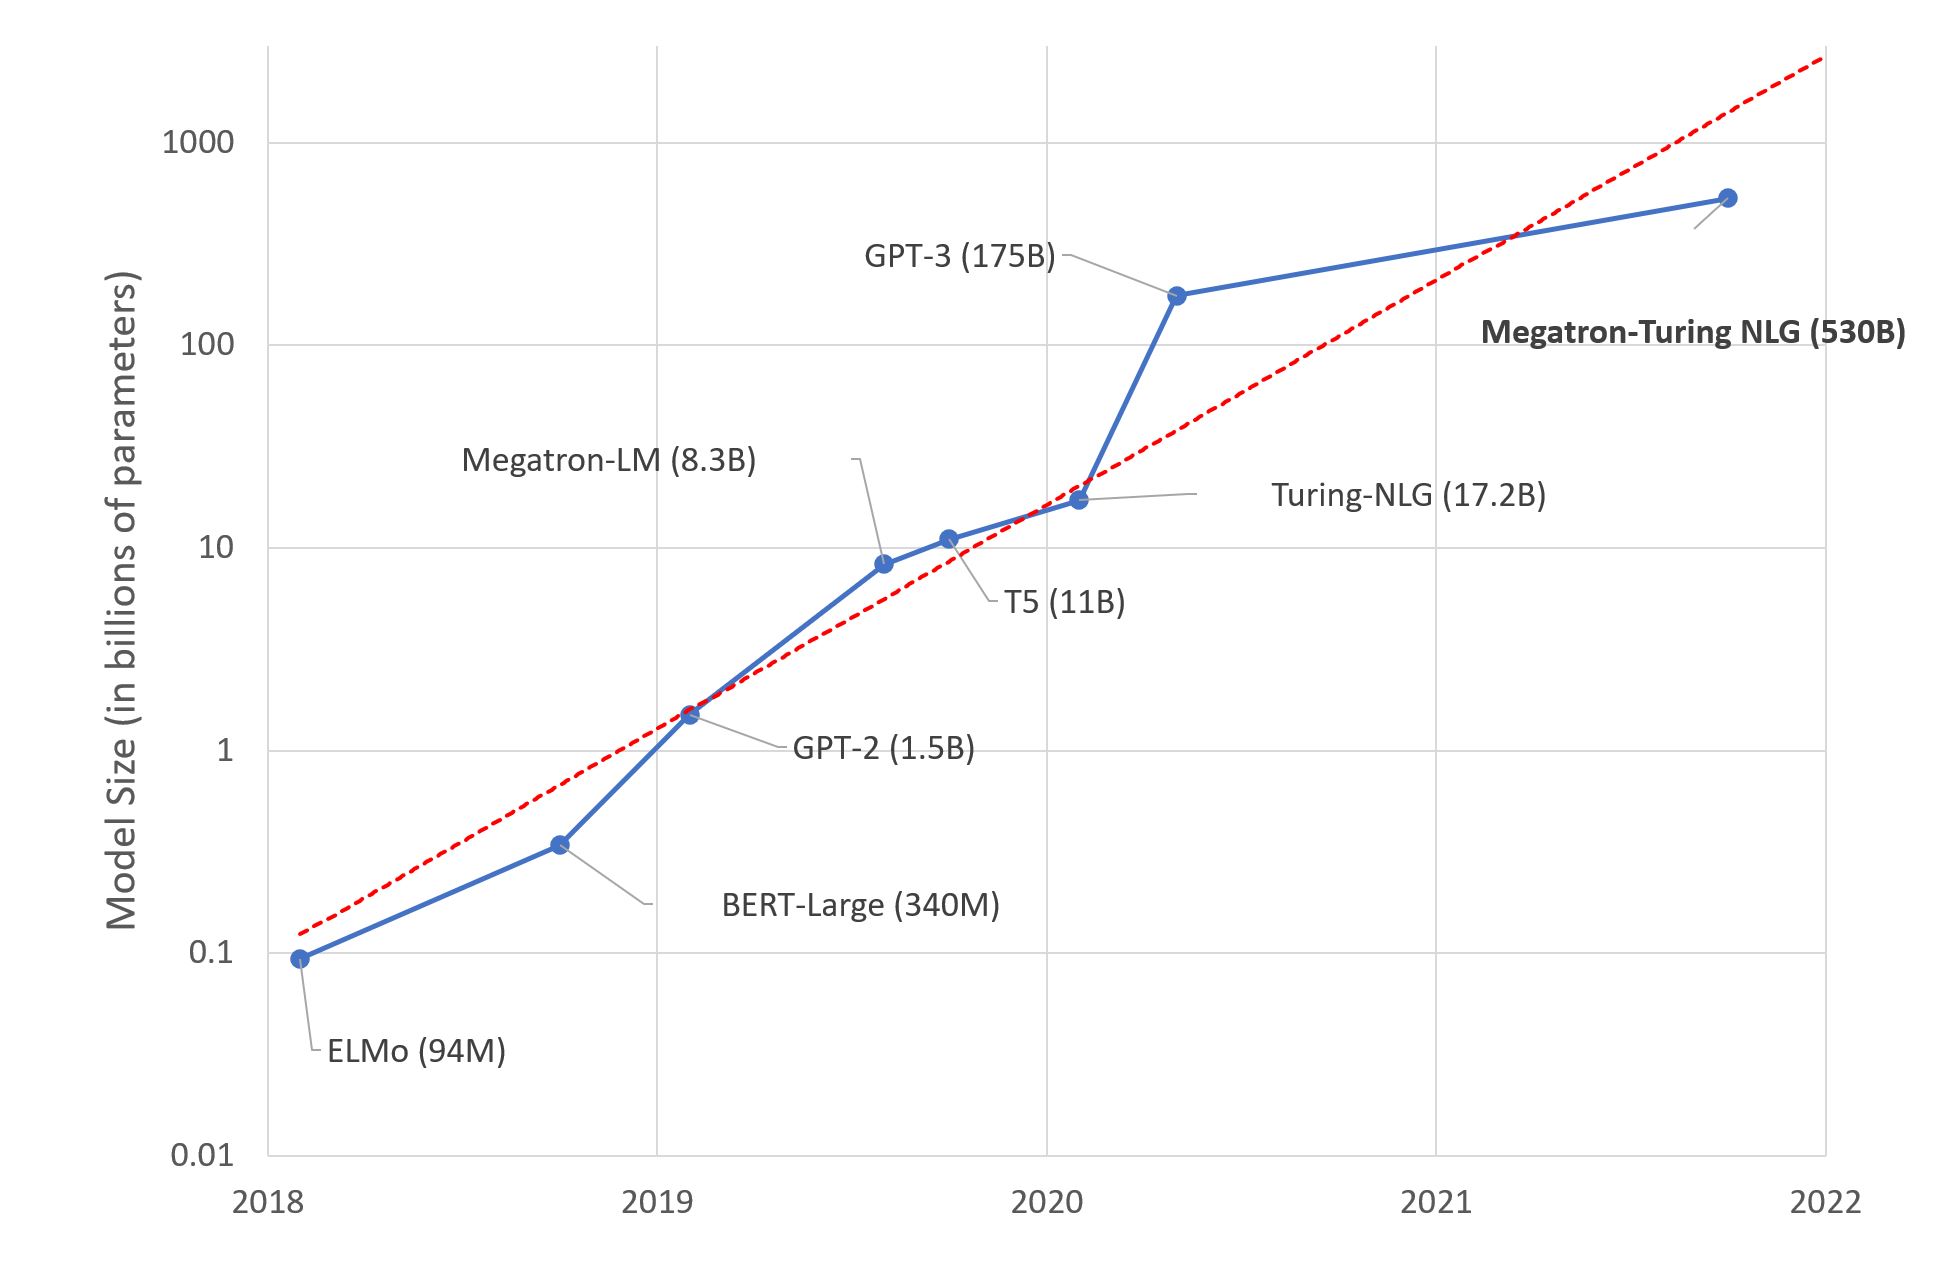
ხელოვნური ინტელექტის მეგა-მოდელები: ღირს კი ეს ხარჯი და ძალისხმევა?
სტატია აანალიზებს ხელოვნური ინტელექტის მეგა-მოდელების ტენდენციას და ეჭვქვეშ აყენებს მათ მიზანშეწონილობას მაღალი დანახარჯების, სირთულისა და გარემოზე ზემოქმედების გამო. ავტორი აღნიშნავს, რომ მიუხედავად ინჟინრული მიღწევებისა, უზარმაზარი მოდელების შექმნა, რომლებიც ადამიანის ტვინის ზომას უახლოვდება, შესაძლოა, გრძელვადიან პერსპექტივაში საუკეთესო მიდგომა არ იყოს. სანაცვლოდ, ის მხარს უჭერს პრაგმატულ გადაწყვეტილებებს, როგორიცაა წინასწარ გაწვრთნილი, უფრო მცირე ზომის მოდელების გამოყენება და მათი დახვეწა (f

Hugging Face-ის სასწავლო პლატფორმის მასშტაბური განახლება: NLP კურსი ახლა LLM კურსია
Hugging Face აცხადებს hf.co/learn პლატფორმის მასშტაბურ განახლებას, რომლის ფარგლებშიც პოპულარული NLP კურსი LLM კურსად გარდაიქმნა. ეს ცვლილება ასახავს ხელოვნური ინტელექტის სფეროში მიმდინარე სწრაფ განვითარებას, ამატებს ახალ თავებს დიდი ენობრივი მოდელების დახვეწასა და მსჯელობის მოდელების შექმნაზე, აფართოებს საზოგადოებასთან თანამშრომლობას და გეგმავს სერტიფიცირების პროგრამას მომავალში.

გამოსახულებების ტოკენიზაცია და ViT მოდელების დახვეწა გამოსახულების კლასიფიკაციისთვის
ეს სტატია განიხილავს, თუ როგორ ხდება გამოსახულებების ტოკენიზაცია ტრანსფორმატორის მოდელებისთვის, ნატურალური ენის დამუშავების (NLP) ამოცანების ანალოგიით. დეტალურად არის აღწერილი 🤗 datasets-ისა და 🤗 transformers-ის გამოყენებით ViT (Vision Transformer) მოდელის წინასწარი წვრთნა და დახვეწა გამოსახულების კლასიფიკაციის ამოცანებისთვის. მოცემულია ინსტრუქციები მონაცემთა ჩამოტვირთვის, დამუშავების, გამოსახულების ტრანსფორმაციებისა და წვრთნის კონვეიერის დაყენების შესახებ, მათ შორის ისეთი კომპონენტების, როგორიც
Unsloth: დააჩქარეთ LLM მოდელების დახვეწა Hugging Face-ის ეკოსისტემაში
Unsloth არის მსუბუქი ბიბლიოთეკა, რომელიც შექმნილია დიდი ენობრივი მოდელების (LLM) დახვეწის პროცესის დასაჩქარებლად. ის სრულად თავსებადია Hugging Face-ის ეკოსისტემასთან და აქტიურად ვითარდება Unsloth-ის გუნდისა და ღია წყაროს საზოგადოების მიერ. ბიბლიოთეკა მხარს უჭერს NVIDIA GPU-ებს, Llama-სა და Mistral-ის არქიტექტურებს, რაც უზრუნველყოფს მნიშვნელოვნად უფრო სწრაფ დახვეწას და მეხსიერების ნაკლებ გამოყენებას სტანდარტულ QLoRA-სთან შედარებით, სიზუსტის დაკარგვის გარეშე.

LLM-ების ოპტიმიზაცია: TRL-ის ახალი მიდგომა GRPO სწავლების მეხსიერების შესამცირებლად
დიდი ენობრივი მოდელების (LLM) დახვეწა განმტკიცებითი სწავლის (RL) გამოყენებით გადამწყვეტია რთული ქცევების მისაღწევად. ტრადიციულად ამისთვის გამოიყენება PPO ალგორითმი RLHF-თან ერთად, რაც, თუმცა, რესურსმომხმარებელია და მრავალი მოდელის მეხსიერებაში ჩატვირთვას მოითხოვს. DeepSeek-ის R1 მოდელთან ერთად პოპულარობას იძენს ჯგუფური შედარებითი პოლიტიკის ოპტიმიზაცია (GRPO), რომელიც იყენებს შემოწმებად ჯილდოს ფუნქციებს გარე ჯილდოს მოდელის გარეშე, რაც მნიშვნელოვან გაუმჯობესებას იძლევა. მიუხედავად ამისა, RL სწავლე
პერსონალიზებული AI მოდელები LLM-ების დახმარებით: დაზოგეთ ხარჯები და გაზარდეთ ეფექტურობა
სტატია განიხილავს პერსონალიზებული ხელოვნური ინტელექტის (AI) მოდელების დახვეწასა და LLM API-ების გამოყენებას შორის არსებულ დილემას, შემდეგ კი წარმოადგენს ინოვაციურ ჰიბრიდულ მიდგომას. ეს მეთოდი იყენებს ღია კოდის LLM-ებს მაღალი ხარისხის სინთეზური მონაცემების გენერირებისთვის, რათა მოამზადოს სპეციალიზებული მოდელები. შემთხვევის შესწავლა აჩვენებს ხარჯების, ენერგიის მოხმარების და დაყოვნების დროის მნიშვნელოვან გაუმჯობესებას GPT-4-ის მსგავს დიდ LLM API-ებთან შედარებით, პარალელურად ინარჩუნებს მსგავს ეფექტუ

მეჩხერი ჩაშენების მოდელების დახვეწა: ჰიბრიდული ძიება და სემანტიკური გაფართოება
ეს სტატია განმარტავს, თუ როგორ უნდა დავხვეწოთ მეჩხერი ენკოდერის/ჩაშენების მოდელები, რომლებიც განსაკუთრებით ეფექტურია ჰიბრიდული ძიებისა და მოძიებისა და ხელახალი რანჟირების სცენარებში. დეტალურად განიხილება მოდელის კომპონენტები, მონაცემთა ნაკრებები, დანაკარგის ფუნქციები, ტრენინგის არგუმენტები და შემფასებლები. ასევე მოცემულია შედარება მკვრივ ჩაშენებებთან და განხილულია მოთხოვნის/დოკუმენტის გაფართოების მნიშვნელობა, რაც ამ მოდელებს საშუალებას აძლევს, გაუმკლავდნენ სემანტიკურ შეუსაბამობებს და გააუმჯობესო

Hugging Face Optimum და Graphcore IPU-ები: ViT მოდელების ეფექტური დახვეწა
ეს ბლოგ-პოსტი აღწერს, თუ როგორ მარტივად შეიძლება წინასწარ გაწვრთნილი ტრანსფორმერული მოდელების, კერძოდ Vision Transformer (ViT) არქიტექტურის, დახვეწა Graphcore Intelligence Processing Units (IPU)-ზე Hugging Face Optimum ბიბლიოთეკის გამოყენებით. სტატია მოიცავს ViT-ის არქიტექტურას, მის უპირატესობებს კონვოლუციურ ნერვულ ქსელებთან (CNNs) შედარებით კომპიუტერულ ხედვაში, გამოყენების სფეროებს, განსაკუთრებით ჯანდაცვაში, და ხაზს უსვამს IPU-ების მიერ შეთავაზებულ ეფექტურობას.
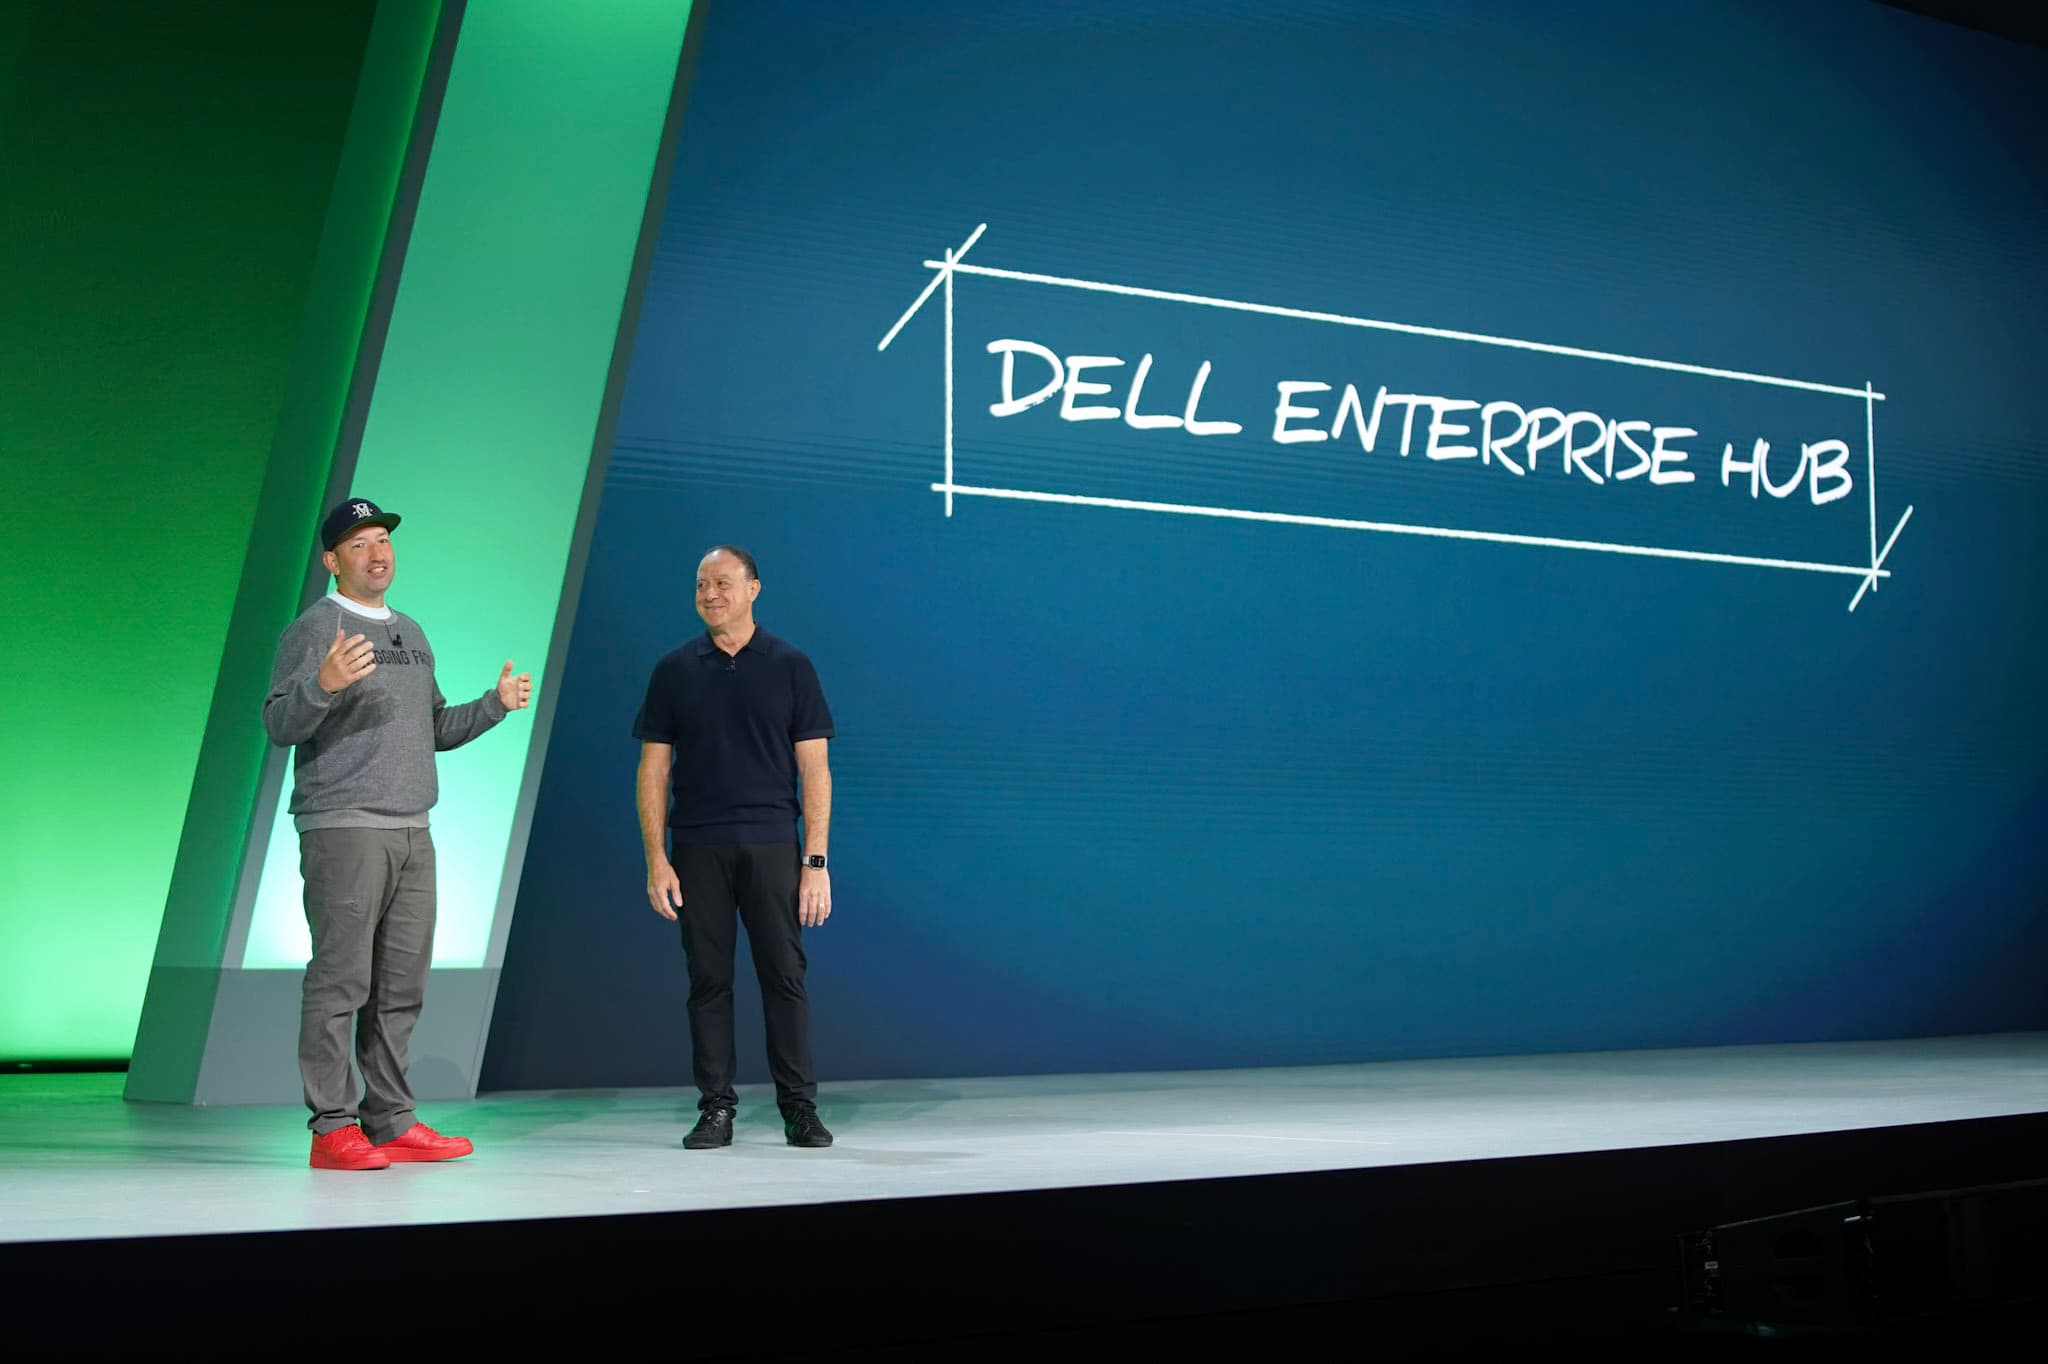
დღეს წარვადგენთ Dell Enterprise Hub-ს: ღია მოდელების მარტივი წვრთნა და განთავსება Dell-ის პლატფორმებზე
Dell Enterprise Hub, Hugging Face-ის ახალი შეთავაზება, ამარტივებს ღია ხელოვნური ინტელექტის მოდელების (როგორიცაა Llama 3 და Mixtral) ლოკალურ წვრთნასა და განთავსებას Dell-ის პლატფორმების გამოყენებით. ის კვირების საინჟინრო სამუშაოს წუთებამდე ამცირებს, გვთავაზობს შერჩეულ მოდელებს და უზრუნველყოფს უსაფრთხო, შესაბამის დახვეწასა და განთავსებას საწარმოს გარემოში.

AI აგენტების გაძლიერება მონაცემთა მეცნიერებაში: Jupyter Agent-იდან Kaggle-ის მაღალი ხარისხის მონაცემებამდე
სტატია დეტალურად აღწერს Jupyter Agent-ის შექმნასა და განვითარებას, ხელოვნური ინტელექტის აგენტის, რომელიც შექმნილია Jupyter Notebook-ებში კოდის უშუალო შესასრულებლად მონაცემთა ანალიზისა და მონაცემთა მეცნიერების ამოცანების გადასაჭრელად. ხაზგასმულია ძალისხმევა მცირე ენობრივი მოდელების გაძლიერებაზე აგენტური ამოცანებისთვის, რათა მათ კონკურენცია გაუწიონ დიდ მოდელებს. პროექტი მოიცავს მაღალი ხარისხის სავარჯიშო მონაცემების გენერირებას Kaggle-ის ნოუთბუქებიდან, მოდელების დახვეწას და მათ შეფასებას DABStep-ის

Together AI-ი და Hugging Face-ი LLM მოდელების დახვეწას რევოლუციურ ხდის
Together AI-ი და Hugging Face-ი აცხადებენ ინტეგრაციის შესახებ, რომელიც მნიშვნელოვნად ამარტივებს Hugging Face Hub-ზე არსებული LLM მოდელების დახვეწას Together AI-ის ინფრასტრუქტურის გამოყენებით, რაც ამცირებს სირთულეს, ღირებულებას და DevOps ექსპერტიზის საჭიროებას. ეს ახალი შესაძლებლობა გუნდებს საშუალებას აძლევს, სწრაფად მოახდინონ მოდელების პერსონალიზაცია კონკრეტული საჭიროებებისთვის.
OpenAI-ის „Whisper“: რევოლუცია მეტყველების ავტომატურ ამოცნობაში
OpenAI-ის Whisper, 2022 წლის სექტემბერში გამოქვეყნებული ავტომატური მეტყველების ამოცნობის (ამოკრ.) მოდელი, რევოლუციას ახდენს დარგში. წინამორბედებისგან განსხვავებით, ის გაწვრთნილია უპრეცედენტო მოცულობის, 680,000 საათის ეტიკეტირებულ აუდიო-ტრანსკრიფციის მონაცემებზე, მათ შორის 117,000 საათის მულტილინგვურ მონაცემებზე, რაც 96-ზე მეტი ენის მხარდაჭერას უზრუნველყოფს. ზედამხედველობითი წინასწარი გაწვრთნა საშუალებას აძლევს მას პირდაპირ ისწავლოს მეტყველებიდან ტექსტზე გადასვლა, რაც მინიმალურ დახვეწას მოითხოვს
Florence-2-ის დახვეწა DocVQA-სთვის: როგორ გავაუმჯობესოთ ვიზუალური კითხვა-პასუხის შესაძლებლობები
ეს სტატია განიხილავს Florence-2 მოდელის დახვეწის პროცესს DocVQA (დოკუმენტური ვიზუალური კითხვა-პასუხი) ამოცანებისთვის. მიუხედავად იმისა, რომ Florence-2 მხარს უჭერს მრავალ კომპიუტერული ხედვის ამოცანას, VQA ფუნქციონალი არ არის ჩაშენებული გამოშვებულ მოდელებში. სტატიაში დეტალურად არის აღწერილი Florence-2-ის არქიტექტურა, უნიკალური FLD-5B მონაცემთა ნაკრების შექმნის პროცესი, რომელიც მოდელის სიძლიერის საფუძველია, და სხვადასხვა დახვეწის მეთოდის ექსპერიმენტები. ლევენშტეინის მსგავსების მეტრიკის გამოყენებით,
ფლორენს-2 მოდელის დახვეწა DocVQA ამოცანისთვის: დეტალური მიმოხილვა
სტატიაში განხილულია Florence-2 ხელოვნური ინტელექტის მოდელის დახვეწის პროცესი დოკუმენტების ვიზუალური კითხვა-პასუხის (DocVQA) კონკრეტული ამოცანისთვის. მიუხედავად იმისა, რომ Florence-2 მრავალ ფუნქციას უშუალოდ ასრულებს, ვიზუალური კითხვა-პასუხის (VQA) შესაძლებლობა გამოცემულ მოდელებში არ შედის. ტექსტში აღწერილია მოდელის არქიტექტურა, მისი სიძლიერე უზარმაზარი FLD-5B მონაცემთა ნაკრებიდან, მონაცემთა ნაკრების ავტომატიზებული შექმნის პროცესი და ექსპერიმენტული შედეგები, რომლებიც აჩვენებს მუშაობის მნიშვნელოვან