Stable Diffusion-ის დახვეწა Intel Sapphire Rapids CPU-ებზე: ახალი შესაძლებლობები ღრმა სწავლისთვის
Intel-მა წარმოადგინა Xeon CPU-ების მეოთხე თაობა, Sapphire Rapids, რომელიც მოიცავს Intel Advanced Matrix Extensions (AMX) აჩქარებელს ღრმა სწავლისთვის. ეს სტატია დეტალურად აღწერს, თუ როგორ შეიძლება Stable Diffusion მოდელების დახვეწა (fine-tuning) Intel Sapphire Rapids CPU კლასტერზე, ტექსტური ინვერსიის გამოყენებით. პროცესი მოიცავს სისტემის დაყენებას Intel Developer Cloud-ზე, პროგრამული დამოკიდებულებების კონფიგურაციას (მათ შორის Intel-ის ბიბლიოთეკები oneCCL და IPEX) და განაწილებულ სწავლებას მინიმალუ
ტრანსფორმერის მოდელების მსგავსად, დიფუზიის მოდელების დახვეწა შესაძლებელია, რათა მათ შექმნან კონტენტი, რომელიც თქვენს ბიზნეს საჭიროებებს ემთხვევა. თავდაპირველად, დახვეწა მხოლოდ GPU ინფრასტრუქტურაზე იყო შესაძლებელი, მაგრამ სიტუაცია იცვლება! რამდენიმე თვის წინ, Intel-მა გამოუშვა Xeon CPU-ების მეოთხე თაობა, კოდური სახელწოდებით Sapphire Rapids. Sapphire Rapids წარმოგიდგენთ Intel Advanced Matrix Extensions (AMX)-ს, ღრმა სწავლის დატვირთვებისთვის შექმნილ ახალ აპარატურულ ამაჩქარებელს. ჩვენ უკვე ვაჩვენეთ AMX-ის უპირატესობები რამდენიმე ბლოგ პოსტში: NLP ტრანსფორმერების დახვეწა, ინფერენსი NLP ტრანსფორმერებით და ინფერენსი Stable Diffusion მოდელებით. ეს პოსტი გაჩვენებთ, თუ როგორ უნდა დახვეწოთ Stable Diffusion მოდელი Intel Sapphire Rapids CPU კლასტერზე. ჩვენ გამოვიყენებთ ტექსტურ ინვერსიას, ტექნიკას, რომელიც მხოლოდ მცირე რაოდენობის მაგალით სურათებს მოითხოვს. ჩვენ გამოვიყენებთ მხოლოდ ხუთს! დავიწყოთ.
ჩვენმა მეგობრებმა Intel-იდან მოგვაწოდეს ოთხი სერვერი, რომლებიც განთავსებულია Intel Developer Cloud (IDC)-ზე – სერვის პლატფორმაზე, Intel®-ისთვის ოპტიმიზებულ გარემოში დატვირთვების შესაქმნელად და გასაშვებად, უახლესი Intel პროცესორებითა და ოპტიმიზებული პროგრამული უზრუნველყოფის სტეკებით. თითოეული სერვერი იკვებება ორი Intel Sapphire Rapids CPU-თი, 56 ფიზიკური ბირთვითა და 112 ნაკადით. წარმოგიდგენთ lscpu-ის გამომავალს: პირველ რიგში, ჩამოვთვალოთ ჩვენი სერვერების IP მისამართები nodefile-ში. პირველი ხაზი ეხება ძირითად სერვერს. განაწილებული სწავლება მოითხოვს პაროლის გარეშე SSH კავშირს ძირითად და სხვა კვანძებს შორის. თუ არ იცნობთ ამ პროცესს, აქ არის კარგი სტატია, თუ როგორ უნდა გააკეთოთ ეს. შემდეგ, თითოეულ კვანძზე ვქმნით ახალ გარემოს და ვაყენებთ პროგრამულ დამოკიდებულებებს. ჩვენ ვაყენებთ ორ Intel ბიბლიოთეკას: oneCCL-ს, განაწილებული კომუნიკაციის სამართავად, და Intel Extension for PyTorch (IPEX)-ს, Sapphire Rapids-ში არსებული აპარატურული აჩქარების ფუნქციების გამოსაყენებლად. ასევე ვამატებთ gperftools-ს libtcmalloc-ის დასაყენებლად, მაღალეფექტური მეხსიერების გამოყოფის ბიბლიოთეკას.
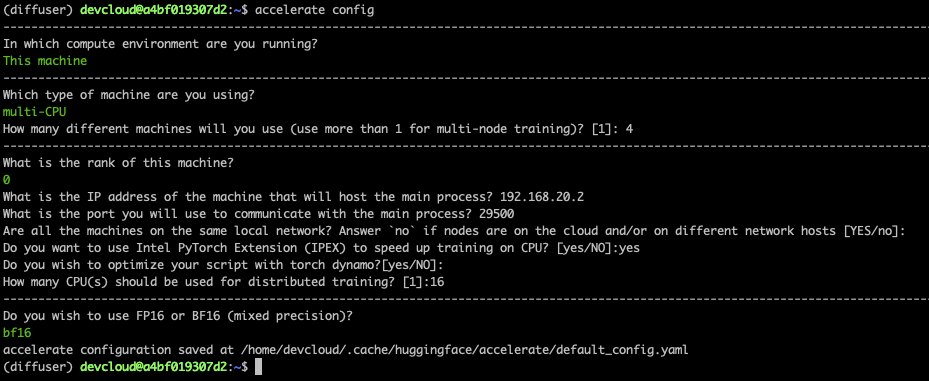
შემდეგ, თითოეულ კვანძზე ვახდენთ diffusers რეპოზიტორიის კლონირებას და ვაყენებთ მას საწყისი კოდიდან. ამის შემდეგ, IPEX-ს ვამატებთ დახვეწის სკრიპტს diffusers/examples/textual_inversion-ში. ჩვენ ვაიმპორტებთ IPEX-ს და ვაოპტიმიზებთ U-Net და Variable Auto Encoder მოდელებს. გთხოვთ, დარწმუნდეთ, რომ ეს გამოყენებულია ყველა კვანძზე. ბოლო ნაბიჯი არის სავარჯიშო სურათების ჩამოტვირთვა. იდეალურ შემთხვევაში, გამოვიყენებდით საერთო NFS საქაღალდეს, მაგრამ სიმარტივისთვის, სურათებს ჩამოვტვირთავთ თითოეულ კვანძზე. გთხოვთ, დარწმუნდეთ, რომ ისინი ყველა კვანძზე ერთსა და იმავე დირექტორიაშია (/home/devcloud/dicoo). წარმოგიდგენთ სურათებს: სისტემის დაყენება დასრულებულია. მოდით, დავაკონფიგურიროთ სავარჯიშო დავალება. Accelerate ბიბლიოთეკა აადვილებს განაწილებული სწავლების გაშვებას. ჩვენ უნდა გავუშვათ ის თითოეულ კვანძზე და ვუპასუხოთ მარტივ კითხვებს. წარმოგიდგენთ ძირითადი კვანძის ეკრანის ანაბეჭდს. სხვა კვანძებზე, თქვენ უნდა დააყენოთ რანკი 1, 2 და 3-ზე. ყველა სხვა პასუხი იდენტურია. საბოლოოდ, ჩვენ უნდა დავაყენოთ გარემო ძირითად კვანძზე. ის გავრცელდება სხვა კვანძებზე დახვეწის სამუშაოს დაწყებისას. პირველი ხაზი ადგენს ქსელის ინტერფეისის სახელს, რომელიც დაკავშირებულია ადგილობრივ ქსელთან, სადაც ყველა კვანძი მუშაობს. შესაძლოა დაგჭირდეთ ამის ადაპტირება ifconfig-ის გამოყენებით შესაბამისი ინფორმაციის მისაღებად. ახლა შეგვიძლია დავიწყოთ დახვეწის სამუშაო.
დახვეწის სამუშაოს ვიწყებთ mpirun-ით, რომელიც აწყობს განაწილებულ კომუნიკაციას nodefile-ში ჩამოთვლილ კვანძებზე. ჩვენ გავუშვებთ 16 დავალებას (-n) ოთხი დავალებით თითო კვანძზე (-ppn). Accelerate ავტომატურად აწყობს განაწილებულ სწავლებას ყველა დავალების მასშტაბით. აქ, ჩვენ ვავარჯიშებთ 200 ნაბიჯისთვის, რაც დაახლოებით ხუთ წუთს უნდა დასჭირდეს. წარმოგიდგენთ დატვირთული კლასტერის ეკრანის ანაბეჭდს: განაწილებული სწავლება შეიძლება რთული იყოს, განსაკუთრებით თუ ახალი ხართ ამ სფეროში. მცირე არასწორი კონფიგურაცია ერთ კვანძზე ყველაზე სავარაუდო პრობლემაა: დაკარგული დამოკიდებულება, სურათები ინახება სხვა ადგილას და ა.შ. თქვენ შეგიძლიათ სწრაფად იპოვოთ პრობლემის წყარო თითოეულ კვანძზე შესვლით და ლოკალურად სწავლებით. ჯერ დააყენეთ იგივე გარემო, როგორც ძირითად კვანძზე, შემდეგ გაუშვით: თუ სწავლება წარმატებით დაიწყო, შეაჩერეთ და გადადით შემდეგ კვანძზე. თუ სწავლება წარმატებით დაიწყო ყველა კვანძზე, დაუბრუნდით ძირითად კვანძს და ორჯერ შეამოწმეთ nodefile, გარემო და mpirun ბრძანება. არ ინერვიულოთ; პრობლემას იპოვით :) 5 წუთიანი ვარჯიშის შემდეგ, მოდელი ლოკალურად ინახება. ჩვენ შეგვეძლო მისი ჩატვირთვა სტანდარტული diffusers პაიპლაინით და პროგნოზირება. ამის ნაცვლად, გამოვიყენოთ Optimum Intel და OpenVINO მოდელის ოპტიმიზაციისთვის. როგორც წინა პოსტში იყო განხილული, ეს საშუალებას გაძლევთ შექმნათ გამოსახულება ერთ CPU-ზე 5 წამზე ნაკლებ დროში! აქ, ჩვენ ვტვირთავთ მოდელს, ვაოპტიმიზებთ მას სტატიკური ფორმისთვის და ვინახავთ: შემდეგ, ვტვირთავთ ოპტიმიზებულ მოდელს, ვქმნით ხუთ სხვადასხვა გამოსახულებას და ვინახავთ მათ: წარმოგიდგენთ გენერირებულ სურათს. შთამბეჭდავია, რომ მოდელს მხოლოდ ხუთი სურათი დასჭირდა იმის სასწავლად, რომ "dicoos"-ებს სათვალეები აქვთ! თუ გსურთ, შეგიძლიათ მოდელი კიდევ დახვეწოთ. წარმოგიდგენთ მშვენიერ მაგალითს, რომელიც გენერირებულია 3000-საფეხურიანი მოდელით (დაახლოებით ერთი საათი ვარჯიში). Hugging Face-ისა და Intel-ის წყალობით, ახლა შეგიძლიათ გამოიყენოთ Xeon CPU სერვერები მაღალი ხარისხის სურათების გენერირებისთვის, რომლებიც ადაპტირებულია თქვენს ბიზნეს საჭიროებებზე. ისინი, როგორც წესი, უფრო ხელმისაწვდომი და ფართოდ გავრცელებულია.
თეგები:
#ხელოვნური ინტელექტი
#ღრმა სწავლა
#hugging face
#stable diffusion
#sapphire rapids
#intel xeon
#openvino
#intel developer cloud
#მოდელის დახვეწა
#ტექსტური ინვერსია
წყარო: huggingface.co
AI-ით გადამუშავებული
მსგავსი სტატიები

ტექნოლოგიები
Honor Magic V6: უთხელესი დასაკეცი ტელეფონი? პირველი შთაბეჭდილებები
ტექნოლოგიები
Honor Magic V6: ყველაზე თხელი დასაკეცი სმარტფონი და მისი შთამბეჭდავი შესაძლებლობები

ტექნოლოგიები