
აგენტური AI-ის პოტენციალის განბლოკვა CPU-ზე: Intel Xeon და AMX-ის როლი
აგენტური ხელოვნური ინტელექტი (AI) AI-ის განვითარების შემდეგ ეტაპად მიიჩნევა, რომელიც LLM-ების მსჯელობის შესაძლებლობებს კონტექსტის ღრმა გაგებასთან აკავშირებს. თუმცა, არსებობს გამოწვევა 'მასპინძელი-აქსელერატორი' ტრაფიკის ზედმეტი დატვირთვის მხრივ, რადგან სისტემებში სულ უფრო მეტი CPU-ზე მომუშავე ხელსაწყო ინტეგრირდება. ამ პრობლემის გადასაჭრელად, მუშავდება მცირე ენობრივი მოდელები (SLM) და CPU-ები, როგორიცაა Intel Xeon-ის მე-4 და მე-5 თაობა, რომლებიც ინტეგრირებულ AMX ტექნოლოგიას გვთავაზობენ AI მუშაობის
Intel Xeon Ice Lake: AI ამოცანების ოპტიმიზაცია პროგრამული გაუმჯობესებებით
Intel-ის უახლესი Ice Lake თაობის Xeon პროცესორები მნიშვნელოვან გაუმჯობესებას გვთავაზობს ხელოვნური ინტელექტის (AI) ამოცანებისთვის, განსაკუთრებით პროგრამული ოპტიმიზაციების დახმარებით. სტატია დეტალურად განიხილავს, თუ როგორ უზრუნველყოფს Intel-ი მაღალ ეფექტურობას AVX512, VNNI და oneAPI კომპონენტების, როგორიცაა oneMKL და oneDNN, მეშვეობით, ასევე სპეციალიზებული ფრეიმვორკებით, როგორიცაა Intel TensorFlow და PyTorch Extension. მიმოხილულია აპარატურული და პროგრამული ინოვაციების კომბინაცია, რამაც Ice Lake-ს
Intel Xeon Ice Lake: პროგრამული ოპტიმიზაციები ხელოვნური ინტელექტის ამოცანებისთვის
ეს ბლოგპოსტი დეტალურად განიხილავს Intel-ის ახალი Ice Lake თაობის Xeon CPU-ების პროგრამულ ოპტიმიზაციებს, რომლებიც მიზნად ისახავს ხელოვნური ინტელექტის (AI) დატვირთვების ეფექტურობის გაზრდას. აღწერილია, თუ როგორ იყენებს Intel როგორც აპარატურულ, ასევე პროგრამულ გაუმჯობესებებს, რათა მიაღწიოს 75%-ით უფრო სწრაფ ინფერენციას NLP ამოცანებში. სტატია ხაზს უსვამს Intel-ის როლს წამყვანი AI ფრეიმვორკების (როგორიცაა TensorFlow და PyTorch) ოპტიმიზაციაში, oneAPI ბიბლიოთეკების მნიშვნელობას მაღალი წარმადობისთვის, და

ღრმა სწავლის დაჩქარება Intel Xeon CPU-ებზე: ტრანსფერული სწავლის ახალი შესაძლებლობები
გრაფიკული პროცესორების (GPU) ნაცვლად, ტრანსფერული სწავლის განვითარება ღრმა სწავლის მოდელების ოპტიმიზაციისთვის CPU-ზე დაფუძნებულ კლასტერებს საინტერესო ალტერნატივად აქცევს. ეს სტატია განმარტავს, თუ როგორ შეიძლება PyTorch-ის სასწავლო ამოცანების დაჩქარება Intel Xeon Scalable CPU სერვერების გამოყენებით, Ice Lake არქიტექტურაზე დაფუძნებული ვირტუალური მანქანების კლასტერის შექმნით და წარმადობაზე ოპტიმიზებული პროგრამული ბიბლიოთეკების ინსტალაციით, როგორიცაა Intel extension for PyTorch და oneCCL.
PyTorch-ის სწავლების აჩქარება Intel Xeon პროცესორებზე: ღრმა სწავლის ახალი მიდგომა
გრაფიკული პროცესორები (GPUs) დიდი ხანია ღრმა სწავლის მოდელების სწავლების დე ფაქტო არჩევანი იყო. თუმცა, ტრანსფერული სწავლის ზრდა ცვლის თამაშის წესებს. მოდელები ახლა იშვიათად სწავლება ნულიდან უზარმაზარ მონაცემთა ნაკრებებზე; ამის ნაცვლად, ისინი ხშირად ზუსტდება კონკრეტულ (და მცირე) მონაცემთა ნაკრებებზე, რათა შეიქმნას სპეციალიზებული მოდელები, რომლებიც უფრო ზუსტია კონკრეტული ამოცანებისთვის, ვიდრე საბაზისო მოდელი. რადგან ეს სწავლების ამოცანები ბევრად უფრო ხანმოკლეა, CPU-ზე დაფუძნებული კლასტერის გამოყენ
Hugging Face Infinity: ტრანსფორმერული მოდელების ოპტიმალური განთავსება Intel Xeon CPU-ებზე
Hugging Face Infinity არის კონტეინერიზებული გადაწყვეტა, რომელიც საშუალებას აძლევს კომპანიებს ეფექტურად განათავსონ ტრანსფორმერული მოდელები წარმოებაში დაბალი ლატენტურობითა და მაღალი გამტარუნარიანობით. ეს ბლოგ პოსტი წარმოადგენს დეტალურ წარმადობის შედეგებს Infinity-ის უახლესი თაობის Intel Xeon CPU-ებზე გაშვებისას (კერძოდ, Ice Lake-ზე დაფუძნებული EC2 C6i ინსტანსებზე), რაც უზრუნველყოფს ოპტიმალურ ღირებულებას, ეფექტურობასა და ლატენტურობას თქვენი Transformer-ის განთავსებისთვის.
Intel Xeon-ზე StarCoder-ის 7X-ზე მეტი დაჩქარება: LLM-ების ოპტიმიზაციის ახალი ეტაპი
კოდის გენერირების მოდელების მზარდი პოპულარობის ფონზე, ეს სტატია წარმოგიდგენთ დიდი ენობრივი მოდელების (LLM) ოპტიმიზაციის უახლეს შედეგებს Intel Xeon-ზე, განსაკუთრებული აქცენტით პოპულარულ StarCoder მოდელზე. ნაჩვენებია StarCoder-15B მოდელის 7-ჯერ მეტი ინფერენსის დაჩქარება Intel-ის მე-4 თაობის Xeon პროცესორებზე 8-ბიტიანი და 4-ბიტიანი კვანტიზაციისა და ასისტენტური გენერაციის ინტეგრაციის გზით. კვლევა ასევე ხაზს უსვამს SmoothQuant ალგორითმის გამოყენებას და მის დადებით გავლენას მოდელის სიზუსტესა და წარმად
დიდი ენობრივი მოდელების ოპტიმიზაცია Intel Xeon-ზე: StarCoder-ის აჩქარება კოდის გენერაციისთვის
სტატია მიმოიხილავს კოდის გენერაციის მოდელების, როგორიცაა StarCoder და Code Llama, მზარდ პოპულარობას და LLM-ების ოპტიმიზაციის ძალისხმევას ხელმისაწვდომობის გაზრდის მიზნით. ხაზგასმულია Intel-ის მიღწევა StarCoder-15B მოდელის 7-ჯერ მეტი ინფერენციის აჩქარებაში მე-4 თაობის Intel Xeon პროცესორებზე, 8-ბიტიანი და 4-ბიტიანი კვანტიზაციის ინტეგრაციით ასისტირებულ გენერაციასთან ერთად. განხილულია Intel AMX-ის როლი, SmoothQuant-ისა და WOQ კვანტიზაციის ტექნიკები, ასევე პროდუქტიულობის შეფასებები HumanEval-ისა და M
Xeon პროცესორებზე წარმადობის მნიშვნელოვანი ზრდა ჩაშენებული მოდელების ოპტიმიზაციით Optimum Intel-ისა და fastRAG-ის გამოყენებით
ეს ბლოგი დეტალურად აღწერს, თუ როგორ მივაღწიოთ წარმადობის მნიშვნელოვან ზრდას Intel Xeon-ზე დაფუძნებულ CPU-ებზე, ოპტიმიზებული ჩაშენების (embedding) მოდელების ინტეგრირებით არსებულ RAG კონვეიერებში fastRAG-ის გამოყენებით. განხილულია Optimum Intel ბიბლიოთეკის როლი მოდელების დასაჩქარებლად, ისეთი ტექნიკების გამოყენებით, როგორიცაა დაბალბიტიანი კვანტიზაცია და Intel-ის სპეციფიკური გაფართოებების (AVX-512, VNNI, AMX) გამოყენება. სტატია ყურადღებას ამახვილებს BGE მოდელებზე და წარმოგიდგენთ ნაბიჯ-ნაბიჯ სახელმძღ
Hugging Face-ის ინოვაციები: მანქანური სწავლის მოდელების განთავსების გამარტივებული გზები
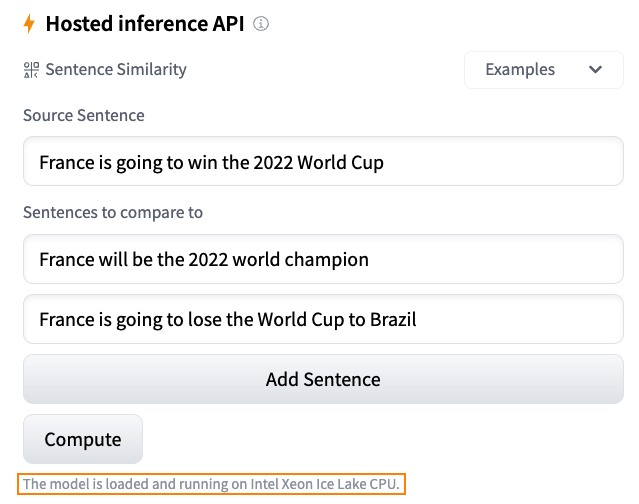
Hugging Face წარმოგიდგენთ ინოვაციურ გადაწყვეტილებებს მანქანური სწავლის (ML) განვითარებისა და ოპერაციების გასამარტივებლად, უმაღლესი ხარისხის სტანდარტების დათმობის გარეშე. სტატია მიმოიხილავს Inference Widget-ს, Inference API-ს, Inference Endpoints-სა და Spaces-ს, როგორც ინსტრუმენტებს ML მოდელების მარტივი ტესტირების, განთავსებისა და ოპტიმიზაციისთვის. ხაზგასმულია Intel-თან პარტნიორობა, რაც უზრუნველყოფს უფასო CPU-ზე დაფუძნებულ ინფერენსის გადაწყვეტილებებს და მომხმარებლებს Intel Xeon Ice Lake არქიტექტუ
Google Cloud C4 VM-ები Intel Xeon 6 პროცესორებით: AI-სთვის ოპტიმიზაცია და მფლობელობის ხარჯების 1.7x შემცირება
უახლესი კვლევის შედეგები აჩვენებს, რომ Google Cloud C4 VM ინსტანციები, რომლებიც Intel Xeon 6 პროცესორებითაა აღჭურვილი, 1.7-ჯერ აუმჯობესებს მფლობელობის საერთო ღირებულებას (TCO) წინა თაობის Google C3 VM-ებთან შედარებით. ეს შთამბეჭდავი წინსვლა მიღწეულია GPT OSS (Mixture of Experts – MoE) მოდელების ეფექტური მხარდაჭერით, Intel-ისა და Hugging Face-ის მიერ განხორციელებული ოპტიმიზაციების წყალობით, რაც უზრუნველყოფს გაუმჯობესებულ გამტარობას, შემცირებულ შეყოვნებას და ხარჯების ოპტიმიზაციას მსხვილი MoE ინფერ
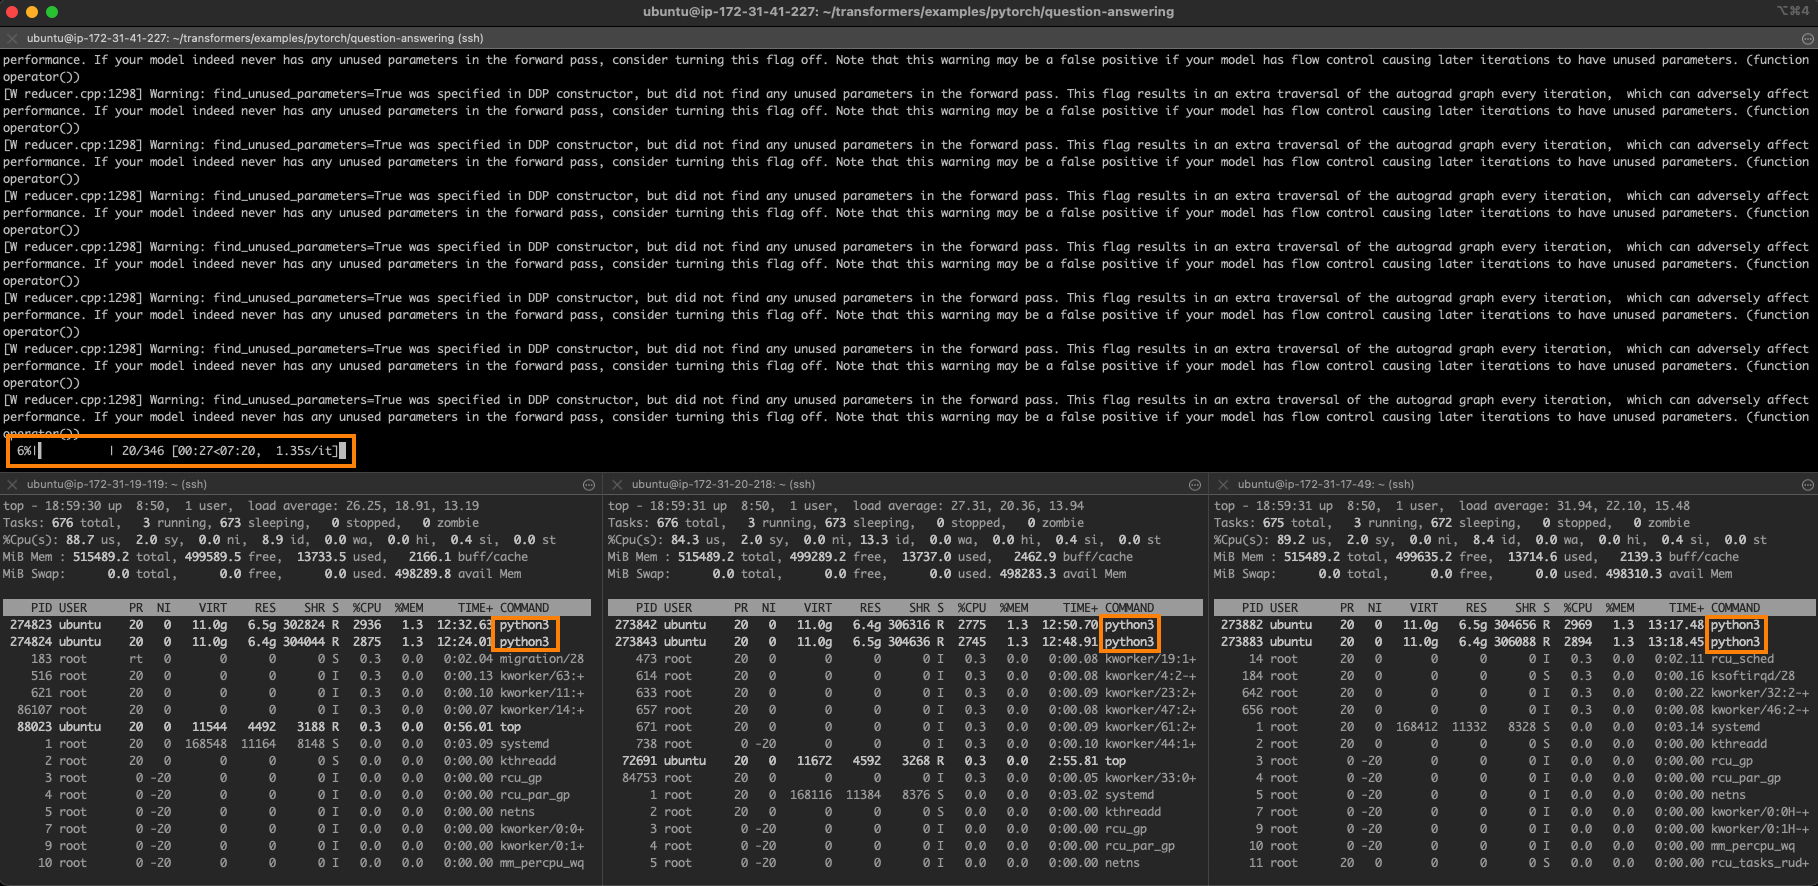
PyTorch-ის სწავლების დაჩქარება AWS-ზე Intel Sapphire Rapids პროცესორებით
ეს პუბლიკაცია განიხილავს, თუ როგორ შეიძლება PyTorch-ის ღრმა სწავლების სამუშაოების მნიშვნელოვნად დაჩქარება AWS-ზე განთავსებული Intel Sapphire Rapids სერვერების კლასტერის მეშვეობით. სტატია დეტალურად აღწერს Intel oneAPI Collective Communications Library (CCL) და Intel Extension for PyTorch (IPEX) ბიბლიოთეკების გამოყენებას გადანაწილებული სწავლებისთვის, რომლებიც სრულად ინტეგრირებულია Hugging Face transformers-თან. ხაზგასმულია Intel Xeon CPU-ების უპირატესობები ღრმა სწავლებისას, მათ შორის ხარჯთეფექტურო
PyTorch-ის ტრენინგის დაჩქარება AWS-ზე Sapphire Rapids სერვერებით
ეს პოსტი აღწერს, თუ როგორ უნდა დააჩქაროთ PyTorch-ის ტრენინგის სამუშაოები AWS-ზე Sapphire Rapids სერვერების კლასტერის გამოყენებით. სტატია დეტალურად განიხილავს Intel oneAPI Collective Communications Library (CCL) და Intel Extension for PyTorch (IPEX) ბიბლიოთეკების გამოყენებას განაწილებული ტრენინგისთვის და ახალი CPU ინსტრუქციების ოპტიმიზაციისთვის. ასევე ხაზგასმულია Intel Xeon CPU-ების ღირებულებითი ეფექტურობა, მასშტაბურობა და მოწინავე ფუნქციები (AVX-512, Hyper-Threading, AMX) ღრმა სწავლის მოდელების