PyTorch-ის სწავლების დაჩქარება AWS-ზე Intel Sapphire Rapids პროცესორებით
ეს პუბლიკაცია განიხილავს, თუ როგორ შეიძლება PyTorch-ის ღრმა სწავლების სამუშაოების მნიშვნელოვნად დაჩქარება AWS-ზე განთავსებული Intel Sapphire Rapids სერვერების კლასტერის მეშვეობით. სტატია დეტალურად აღწერს Intel oneAPI Collective Communications Library (CCL) და Intel Extension for PyTorch (IPEX) ბიბლიოთეკების გამოყენებას გადანაწილებული სწავლებისთვის, რომლებიც სრულად ინტეგრირებულია Hugging Face transformers-თან. ხაზგასმულია Intel Xeon CPU-ების უპირატესობები ღრმა სწავლებისას, მათ შორის ხარჯთეფექტურო
ამ პუბლიკაციაში თქვენ გაეცნობით, თუ როგორ დააჩქაროთ PyTorch-ის სწავლების სამუშაო AWS-ზე განთავსებული Sapphire Rapids სერვერების კლასტერის გამოყენებით. სამუშაოს გასანაწილებლად გამოვიყენებთ Intel oneAPI Collective Communications Library (CCL)-ს, ხოლო Intel Extension for PyTorch (IPEX) ბიბლიოთეკას – ახალი CPU ინსტრუქციების ავტომატურად ასამოქმედებლად. ვინაიდან ორივე ბიბლიოთეკა უკვე ინტეგრირებულია Hugging Face transformers ბიბლიოთეკასთან, ჩვენ შევძლებთ ჩვენი მაგალითის სკრიპტების გაშვებას დამატებითი კოდის შეცვლის გარეშე. მომდევნო პუბლიკაციაში განვიხილავთ Sapphire Rapids CPU-ებზე ინფერენსს და იმ წარმადობის გაუმჯობესებას, რასაც ისინი გვთავაზობენ.
ღრმა სწავლების (DL) მოდელის ვარჯიში Intel Xeon CPU-ებზე შეიძლება იყოს ხარჯთეფექტური და მასშტაბირებადი მიდგომა, განსაკუთრებით მაშინ, როდესაც გამოიყენება ისეთი ტექნიკები, როგორიცაა განაწილებული სწავლება და მცირე და საშუალო ზომის მონაცემთა ნაკრებებზე წვრილად დახვეწა (fine-tuning). Xeon CPU-ები მხარს უჭერენ მოწინავე ფუნქციებს, როგორიცაა Advanced Vector Extensions (AVX-512) და Hyper-Threading, რაც ხელს უწყობს DL მოდელების პარალელიზმისა და ეფექტურობის გაუმჯობესებას. ეს უზრუნველყოფს სწავლების უფრო სწრაფ დროს, ასევე აპარატურული რესურსების უკეთეს გამოყენებას. გარდა ამისა, Xeon CPU-ები ზოგადად უფრო ხელმისაწვდომია და ფართოდ არის გავრცელებული სპეციალიზებულ აპარატურასთან, როგორიცაა GPU-ები, რომელთა გამოყენებაც ჩვეულებრივ საჭიროა დიდი ღრმა სწავლების მოდელების ვარჯიშისთვის. Xeon CPU-ები ასევე ადვილად შეიძლება გადაკეთდეს სხვა საწარმოო ამოცანებისთვის, ვებ სერვერებიდან მონაცემთა ბაზებამდე, რაც მათ მრავალმხრივ და მოქნილ არჩევანს ხდის თქვენი IT ინფრასტრუქტურისთვის. და ბოლოს, ღრუბლოვანი მომხმარებლებს შეუძლიათ კიდევ უფრო შეამცირონ Xeon CPU-ებზე სწავლების ღირებულება Spot ინსტანციების გამოყენებით. Spot ინსტანციები აგებულია გამოუყენებელი გამოთვლითი სიმძლავრეებისგან და იყიდება შეღავათიან ფასად. მათ შეუძლიათ მნიშვნელოვანი ხარჯების დაზოგვა მოთხოვნილ ინსტანციებთან შედარებით, ზოგჯერ 90%-მდე. ბოლოს, მაგრამ არა ნაკლებ მნიშვნელოვანი, CPU Spot ინსტანციების მოპოვება ასევე ზოგადად უფრო ადვილია, ვიდრე GPU ინსტანციების.
ახლა განვიხილოთ Sapphire Rapids არქიტექტურის ახალი ინსტრუქციები. Sapphire Rapids არქიტექტურა წარმოგიდგენთ Intel Advanced Matrix Extensions (AMX)-ს DL დატვირთვების დასაჩქარებლად. მათი გამოყენება ისეთივე მარტივია, როგორც IPEX-ის უახლესი ვერსიის დაყენება. არ არის საჭირო რაიმე ცვლილების შეტანა თქვენს Hugging Face კოდში. AMX ინსტრუქციები აჩქარებს მატრიცების გამრავლებას, ოპერაციას, რომელიც ცენტრალურია DL მოდელების მონაცემთა პარტიებზე (data batches) ვარჯიშისთვის. ისინი მხარს უჭერენ როგორც Brain Floating Point (BF16), ასევე 8-ბიტიან მთელ რიცხვებს (INT8), რაც საშუალებას აძლევს დაჩქარებას სხვადასხვა სწავლების სცენარებისთვის. AMX წარმოგიდგენთ ახალ 2-განზომილებიან CPU რეგისტრებს, რომლებსაც tile registers ეწოდება. ვინაიდან ეს რეგისტრები უნდა შეინახოს და აღდგეს კონტექსტის შეცვლის დროს, მათ სჭირდებათ kernel-ის მხარდაჭერა: Linux-ზე დაგჭირდებათ v5.16 ან უფრო ახალი ვერსია.
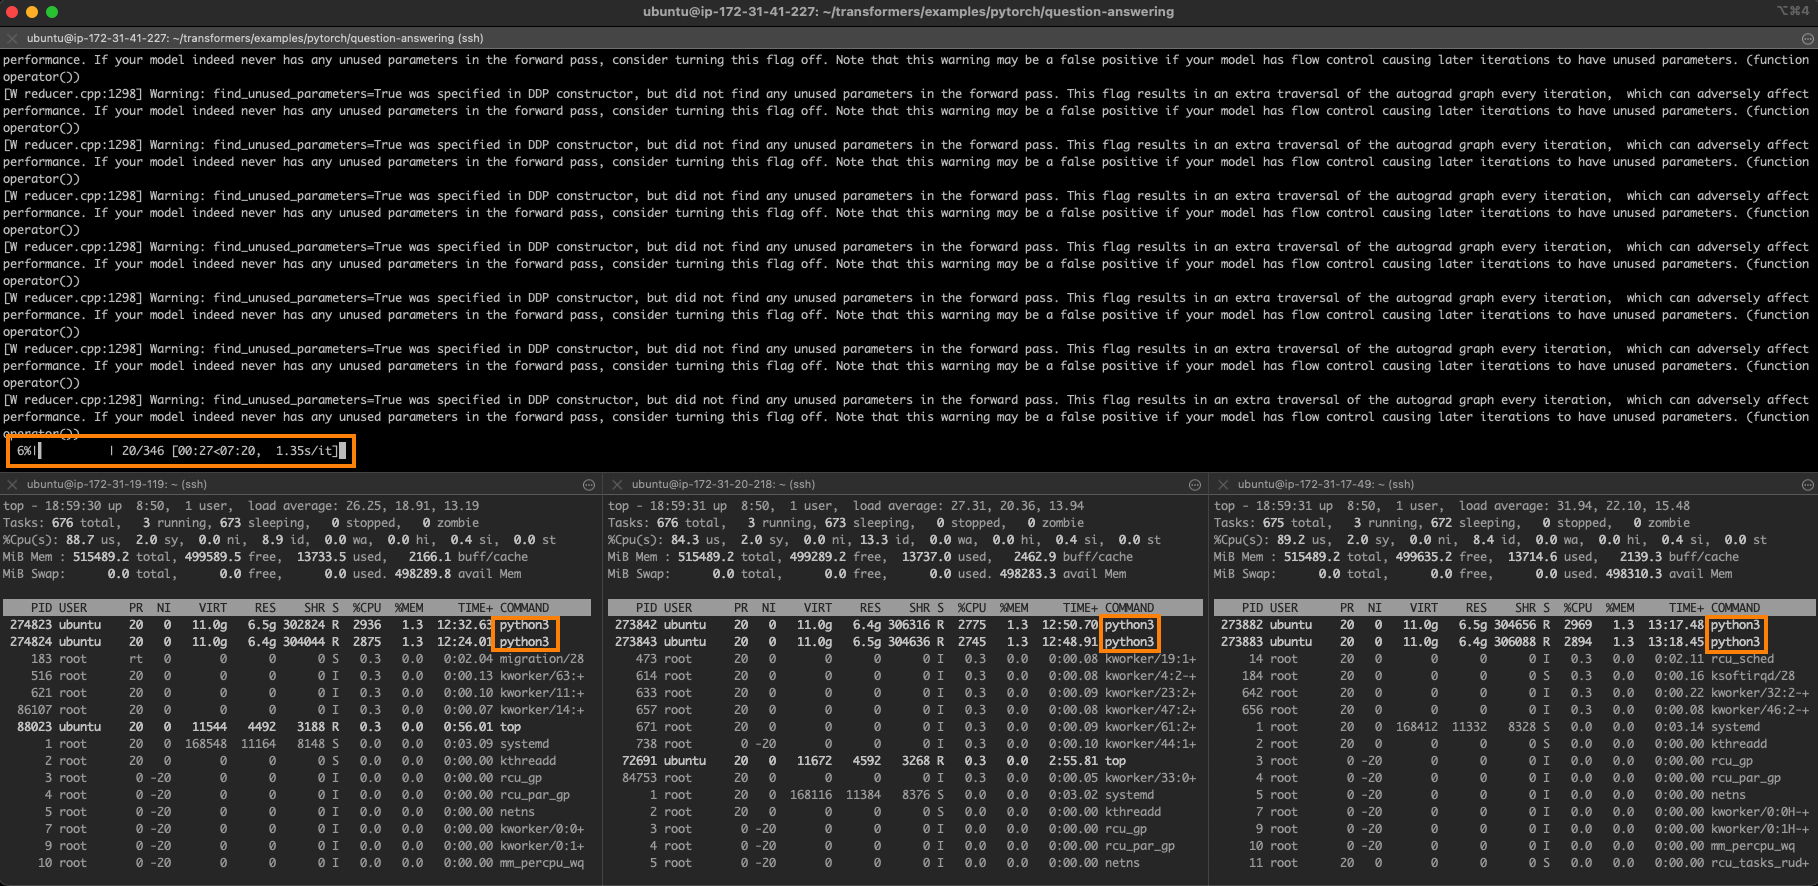
ახლა ვნახოთ, თუ როგორ შეგვიძლია Sapphire Rapids CPU-ების კლასტერის აშენება განაწილებული სწავლებისთვის. ამ სტატიის დაწერის მომენტში, Sapphire Rapids სერვერების მოპოვების უმარტივესი გზა არის Amazon EC2 R7iz ინსტანციების ახალი ოჯახის გამოყენება. ვინაიდან ის ჯერ კიდევ წინასწარ ხედვაშია (preview), წვდომის მისაღებად უნდა დარეგისტრირდეთ. გარდა ამისა, ვირტუალური სერვერები ჯერ არ უჭერენ მხარს AMX-ს, ამიტომ გამოვიყენებთ bare metal ინსტანციებს (r7iz.metal-16xl, 64 vCPU, 512GB RAM). იმისათვის, რომ თავიდან ავიცილოთ კლასტერში თითოეული კვანძის ხელით დაყენება, ჯერ დავაყენებთ მასტერ კვანძს (master node) და შევქმნით მისგან ახალ Amazon Machine Image (AMI)-ს. შემდეგ, ამ AMI-ს გამოვიყენებთ დამატებითი კვანძების გასაშვებად. ქსელური პერსპექტივიდან, დაგვჭირდება შემდეგი კონფიგურაცია: გახსენით პორტი 22 ssh წვდომისთვის ყველა ინსტანციაზე დაყენებისა და გამართვისთვის. დააკონფიგურირეთ password-less ssh მასტერ ინსტანციიდან (რომლიდანაც დაიწყებთ სწავლებას) ყველა სხვა ინსტანციაზე (მასტერის ჩათვლით). სხვა სიტყვებით, მასტერ კვანძის ssh საჯარო გასაღები ავტორიზებული უნდა იყოს ყველა კვანძზე. დაუშვით ყველა ქსელური ტრაფიკი კლასტერის შიგნით, რათა განაწილებულმა სწავლებამ შეუფერხებლად იმუშაოს. AWS უზრუნველყოფს უსაფრთხო და მოსახერხებელ გზას ამის გასაკეთებლად უსაფრთხოების ჯგუფების (security groups) საშუალებით. ჩვენ უბრალოდ უნდა შევქმნათ უსაფრთხოების ჯგუფი, რომელიც ნებას რთავს ყველა ტრაფიკს იმავე უსაფრთხოების ჯგუფით კონფიგურირებული ინსტანციებიდან და დავრწმუნდეთ, რომ ის მიმაგრებულია კლასტერის ყველა ინსტანციაზე. აი, როგორ გამოიყურება ჩემი დაყენება. მოდით, დავიწყოთ მუშაობა და ავაშენოთ კლასტერის მასტერ კვანძი. ჩვენ ჯერ ვქმნით მასტერ კვანძს r7iz.metal-16xl ინსტანციის გაშვებით Ubuntu 20.04 AMI-ით (ami-07cd3e6c4915b2d18) და ადრე შექმნილი უსაფრთხოების ჯგუფით. ეს AMI მოიცავს Linux v5.15.0-ს, მაგრამ Intel-მა და AWS-მა, საბედნიეროდ, შეასწორეს kernel AMX მხარდაჭერის დასამატებლად. ამრიგად, ჩვენ არ გვჭირდება kernel-ის v5.16-ზე განახლება. მას შემდეგ, რაც ინსტანცია ამუშავდება, ჩვენ ssh-ით ვუკავშირდებით მას და lscpu-ით ვამოწმებთ, რომ AMX ნამდვილად მხარდაჭერილია. თქვენ უნდა ნახოთ შემდეგი flags სექციაში: შემდეგ, ვამონტაჟებთ ნატიურ და Python დამოკიდებულებებს. ამის შემდეგ, ვქმნით ახალ ssh გასაღებების წყვილს, სახელწოდებით 'cluster', ssh-keygen-ით და ვინახავთ ნაგულისხმევ ადგილას (~/.ssh). საბოლოოდ, ვქმნით ახალ AMI-ს ამ ინსტანციიდან. როგორც კი AMI მზად იქნება, მას გამოვიყენებთ 3 დამატებითი r7iz.16xlarge-metal ინსტანციის გასაშვებად, ადრე შექმნილი უსაფრთხოების ჯგუფის მიმაგრების დავიწყების გარეშე. სანამ ეს ინსტანციები იწყება, ჩვენ ssh-ით ვუკავშირდებით მასტერ კვანძს ქსელის დაყენების დასასრულებლად. ჯერ ვარედაქტირებთ ssh კონფიგურაციის ფაილს ~/.ssh/config-ში, რომ ჩავრთოთ
თეგები:
#ხელოვნური ინტელექტი
#ღრუბლოვანი ტექნოლოგიები
#ღრმა სწავლება
#pytorch
#aws
#sapphire rapids
#amx
#intel
#განაწილებული სწავლება
#xeon
წყარო: huggingface.co
AI-ით გადამუშავებული


