
ZDNET-ის მიმოხილვა: Lenovo ThinkPad P1 (მე-8 თაობა) - პროფესიონალური სამუშაო სადგურის ეტალონი
ZDNET მკითხველებს სთავაზობს დამოუკიდებელ, ტესტირებასა და კვლევაზე დაფუძნებულ რეკომენდაციებს, მკაცრი სარედაქციო სტანდარტებით, რათა დაეხმაროს მათ ჭკვიანი შესყიდვების მიღებაში. ამ სტატიაში განხილულია Lenovo ThinkPad P1-ის მე-8 თაობა, მძლავრი და პორტატული სამუშაო სადგური, რომელიც აღჭურვილია Intel Core Ultra 9 255H CPU-ით, Nvidia RTX PRO 2000 GPU-ით და ინოვაციური LPCAMM2 მეხსიერებით. P1-მა მიიღო ZDNET-ის რედაქტორის არჩევანის ჯილდო თავისი 16-ინჩიანი OLED დისპლეის, მძლავრი აპარატურის, საწარმოსთვის განკ

როგორ ჩაწეროთ სატელეფონო ზარები iPhone-ზე iOS 18.1-ის გამოყენებით?
Apple-ის iOS 18.1 განახლებაში (რომელიც 2024 წლის ბოლოს გამოვა) დანერგილია სატელეფონო ზარების ჩაწერის ახალი ფუნქცია. ეს ფუნქცია მომხმარებლებს საშუალებას აძლევს პირდაპირ iPhone-ზე ჩაწერონ ზარები, შეინახონ ისინი 'ნოტების' აპლიკაციაში ტრანსკრიფციასთან ერთად და მიიღონ ხელოვნური ინტელექტით გენერირებული რეზიუმე (Apple Intelligence-ის მეშვეობით). სტატიაში მოცემულია დეტალური ინსტრუქციები, განხილულია ჩაწერის სამართლებრივი ასპექტები და ZDNET-ის სარედაქციო პრინციპები, რომლებიც უზრუნველყოფენ მასალის სიზუსტეს

Dell XPS 14 ტრიუმფალურად ბრუნდება: დეტალური განხილვა
ZDNET-ის დამოუკიდებელი განხილვის საფუძველზე, Dell-ის XPS ბრენდი ტრიუმფალურად დაბრუნდა CES 2026-ზე, წარუმატებელი რე-ბრენდინგის შემდეგ. ახალი XPS 14 გამოირჩევა გაუმჯობესებული დიზაინით, Intel-ის უახლესი პროცესორით, OLED ეკრანით და ხანგრძლივი ბატარეის ხანგრძლივობით, რაც მას იდეალურს ხდის ყოველდღიური გამოყენებისთვის, თუმცა ნაკლებად არის ორიენტირებული მძლავრ გრაფიკულ ამოცანებზე. სტატიაში დეტალურად არის აღწერილი ლეპტოპის პრემიუმ აშენება და დიზაინის ინოვაციები.

ZDNET-ის მიმოხილვა: Samsung Galaxy Book6 Ultra – გაუმჯობესება თუ იმედგაცრუება?
ZDNET-ის სარედაქციო გუნდი წარმოგიდგენთ Samsung-ის უახლესი ფლაგმანი ლეპტოპის, Galaxy Book6 Ultra-ს დეტალურ მიმოხილვას, რომელიც დაფუძნებულია მრავალსაათიან ტესტირებასა და კვლევაზე. სტატია განმარტავს ZDNET-ის მიუკერძოებელ სარედაქციო პრინციპებს და შემდეგ აფასებს Galaxy Book6 Ultra-ს, ხაზს უსვამს მის გაუმჯობესებულ მახასიათებლებს, როგორიცაა Intel-ის უახლესი პროცესორი, RTX 5070 GPU, განახლებული აუდიო სისტემა და შესანიშნავი AMOLED 3K დისპლეი, რომელიც წინა ვერსიიდან გადმოვიდა. მიუხედავად იმისა, რომ ლეპტოპ

ZDNET-ის რეკომენდაციები და System76 Thelio-ს მიმოხილვა: რატომ ავირჩიე AMD Intel-ის ნაცვლად
ZDNET-ის სტატია განმარტავს სარედაქციო პოლიტიკას, ტესტირების პროცესს და დამოუკიდებელ შეფასებებს, რომლებიც საფუძვლად უდევს მათ რეკომენდაციებს, ხაზს უსვამს რეკლამირებისგან დამოუკიდებლობას. ამასთანავე, წარმოდგენილია System76-ის კომპიუტერების, კერძოდ Thelio ხაზის, პირადი მიმოხილვა, რომელიც მოიცავს 2013 წლიდან დაწყებულ გამოცდილებას, მათ შორის Intel-ის პროცესორებიდან AMD Ryzen-ზე გადასვლას და ახალი მოდელის გაუმჯობესებულ მახასიათებლებსა და შესრულებას.

ZDNET მიმოხილვა: Acer Chromebook Plus 516 GE – ღრუბლოვანი თამაშები და გაუმჯობესებული შესაძლებლობები
ZDNET-ი პროდუქტების რეკომენდაციებს ეფუძნება ხანგრძლივ ტესტირებასა და კვლევას, რათა მომხმარებელს ზუსტი ინფორმაცია მიაწოდოს. სტატია დეტალურად განიხილავს Acer Chromebook Plus 516 GE-ს, Google-ის ახალი Chromebook Plus მოწყობილობების ნაწილს. ეს მოდელი გამოირჩევა მძლავრი Intel Core Ultra 5 120U პროცესორით, 16-დუიმიანი WQXGA 120Hz დისპლეით და Google Gemini-ს მეშვეობით ხელოვნური ინტელექტის მრავალი ფუნქციით. ის იდეალურია ღრუბლოვანი თამაშებისა და მულტიტასკინგისთვის, უზრუნველყოფს სწრაფ მუშაობას და შთამბეჭდ
ZDNET წარმოგიდგენთ: Acer Chromebook Plus 516 GE – ღრუბლოვანი გეიმინგის ახალი სტანდარტი?
ZDNET-ის რეკომენდაციები ეფუძნება საათობით ტესტირებას, კვლევასა და ბაზრის შედარებით ანალიზს, რათა მკითხველს მიაწოდოს ზუსტი და მიუკერძოებელი ინფორმაცია, სარედაქციო დამოუკიდებლობის შენარჩუნებით. უახლესი მიმოხილვის ცენტრშია Acer Chromebook Plus 516 GE, მძლავრი მოწყობილობა, რომელიც სპეციალურად არის შექმნილი ღრუბლოვანი თამაშებისთვის. ეს მოდელი გამოირჩევა გაუმჯობესებული აპარატურით, Google-ის Gemini AI ფუნქციონალით და Intel Core Ultra 5 პროცესორით, რაც უზრუნველყოფს შთამბეჭდავ შესრულებას და მრავალფუნქციუ

სტარტაპ Ricursive Intelligence-მა AI ჩიპების დიზაინით $4 მილიარდი შეფასება მოიპოვა
სტარტაპ Ricursive Intelligence-ის თანადამფუძნებლები, ანა გოლდი და აზალია მირჰოსეინი, რომლებიც Google Brain-სა და Anthropic-ში მუშაობდნენ, სწრაფად იპყრობენ ყურადღებას. მათი AI-ზე დაფუძნებული ხელსაწყოები ჩიპების დიზაინს დრამატულად აჩქარებს, რასაც წარსულში Alpha Chip-ის შექმნით დაამტკიცეს Google-ში. კომპანიამ ცოტა ხნის წინ $300 მილიონიანი Series A რაუნდი დახურა $4 მილიარდი შეფასებით, რომელსაც Lightspeed ხელმძღვანელობდა. Ricursive განსხვავდება სხვა AI ჩიპების სტარტაპებისგან იმით, რომ ის არ ქმნის თავ

აგენტური AI-ის პოტენციალის განბლოკვა CPU-ზე: Intel Xeon და AMX-ის როლი
აგენტური ხელოვნური ინტელექტი (AI) AI-ის განვითარების შემდეგ ეტაპად მიიჩნევა, რომელიც LLM-ების მსჯელობის შესაძლებლობებს კონტექსტის ღრმა გაგებასთან აკავშირებს. თუმცა, არსებობს გამოწვევა 'მასპინძელი-აქსელერატორი' ტრაფიკის ზედმეტი დატვირთვის მხრივ, რადგან სისტემებში სულ უფრო მეტი CPU-ზე მომუშავე ხელსაწყო ინტეგრირდება. ამ პრობლემის გადასაჭრელად, მუშავდება მცირე ენობრივი მოდელები (SLM) და CPU-ები, როგორიცაა Intel Xeon-ის მე-4 და მე-5 თაობა, რომლებიც ინტეგრირებულ AMX ტექნოლოგიას გვთავაზობენ AI მუშაობის
Stable Diffusion-ის დახვეწა Intel Sapphire Rapids CPU-ებზე: ახალი შესაძლებლობები ღრმა სწავლისთვის
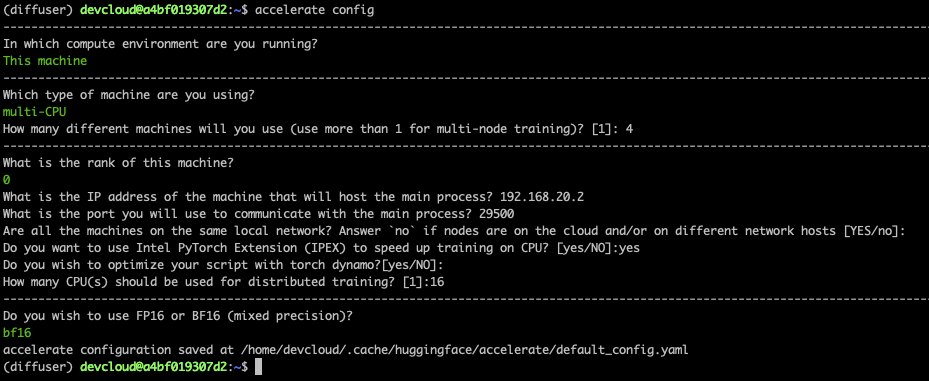
Intel-მა წარმოადგინა Xeon CPU-ების მეოთხე თაობა, Sapphire Rapids, რომელიც მოიცავს Intel Advanced Matrix Extensions (AMX) აჩქარებელს ღრმა სწავლისთვის. ეს სტატია დეტალურად აღწერს, თუ როგორ შეიძლება Stable Diffusion მოდელების დახვეწა (fine-tuning) Intel Sapphire Rapids CPU კლასტერზე, ტექსტური ინვერსიის გამოყენებით. პროცესი მოიცავს სისტემის დაყენებას Intel Developer Cloud-ზე, პროგრამული დამოკიდებულებების კონფიგურაციას (მათ შორის Intel-ის ბიბლიოთეკები oneCCL და IPEX) და განაწილებულ სწავლებას მინიმალუ

Physical Intelligence-ი წარმოგიდგენთ π0-ს და π0-FAST-ს: რობოტების მრავალმხრივი კონტროლისთვის
კომპანია Physical Intelligence-მა შექმნა π0 და π0-FAST – პროტოტიპული გენერალისტი რობოტ მოდელები, რომლებიც მიზნად ისახავს ხელოვნურ ინტელექტსა და ფიზიკურ სამყაროს შორის არსებული უფსკრულის ამოვსებას. ეს ხედვა-ენა-მოქმედების (VLA) მოდელები, რომლებიც გაწვრთნილია მრავალფეროვან რობოტულ მონაცემებზე, გამოირჩევიან მრავალმხრივი კონტროლით სხვადასხვა ამოცანასა და რობოტის ტიპებზე, ნაკადის შესაბამისობის (flow matching) მეთოდის გამოყენებით ეფექტური, რეალურ დროში მოქმედების გენერაციისთვის. ისინი სძლევენ ტრადიციუ
ფიზიკური ინტელექტის ინოვაცია: რობოტების გენერალისტი კონტროლის მოდელები π0 და π0-FAST
Physical Intelligence-მა წარმოადგინა π0 და π0-FAST, პროტოტიპული მოდელები და სასწავლო ფრეიმვორკები, რომლებიც შექმნილია რობოტების გენერალისტური კონტროლისთვის. ისინი მიზნად ისახავს ხიდის გადებას ხელოვნური ინტელექტის სისტემებსა და ფიზიკურ სამყაროს შორის არსებულ ხარვეზებს შორის, LLM-ებისა და VLM-ებისგან განსხვავებით, რომელთაც ფიზიკურ სამყაროსთან ურთიერთქმედება აკლიათ. π0, ხედვით-ენობრივ-მოქმედებითი (VLA) მოდელი, გაწვრთნილია 7 რობოტული პლატფორმისა და 68 უნიკალური ამოცანის მონაცემებზე, რაც მას საშუალებ
ტრანსფორმერული მოდელები წარმოებაში: გამოწვევები და Optimum-ის გადაწყვეტა
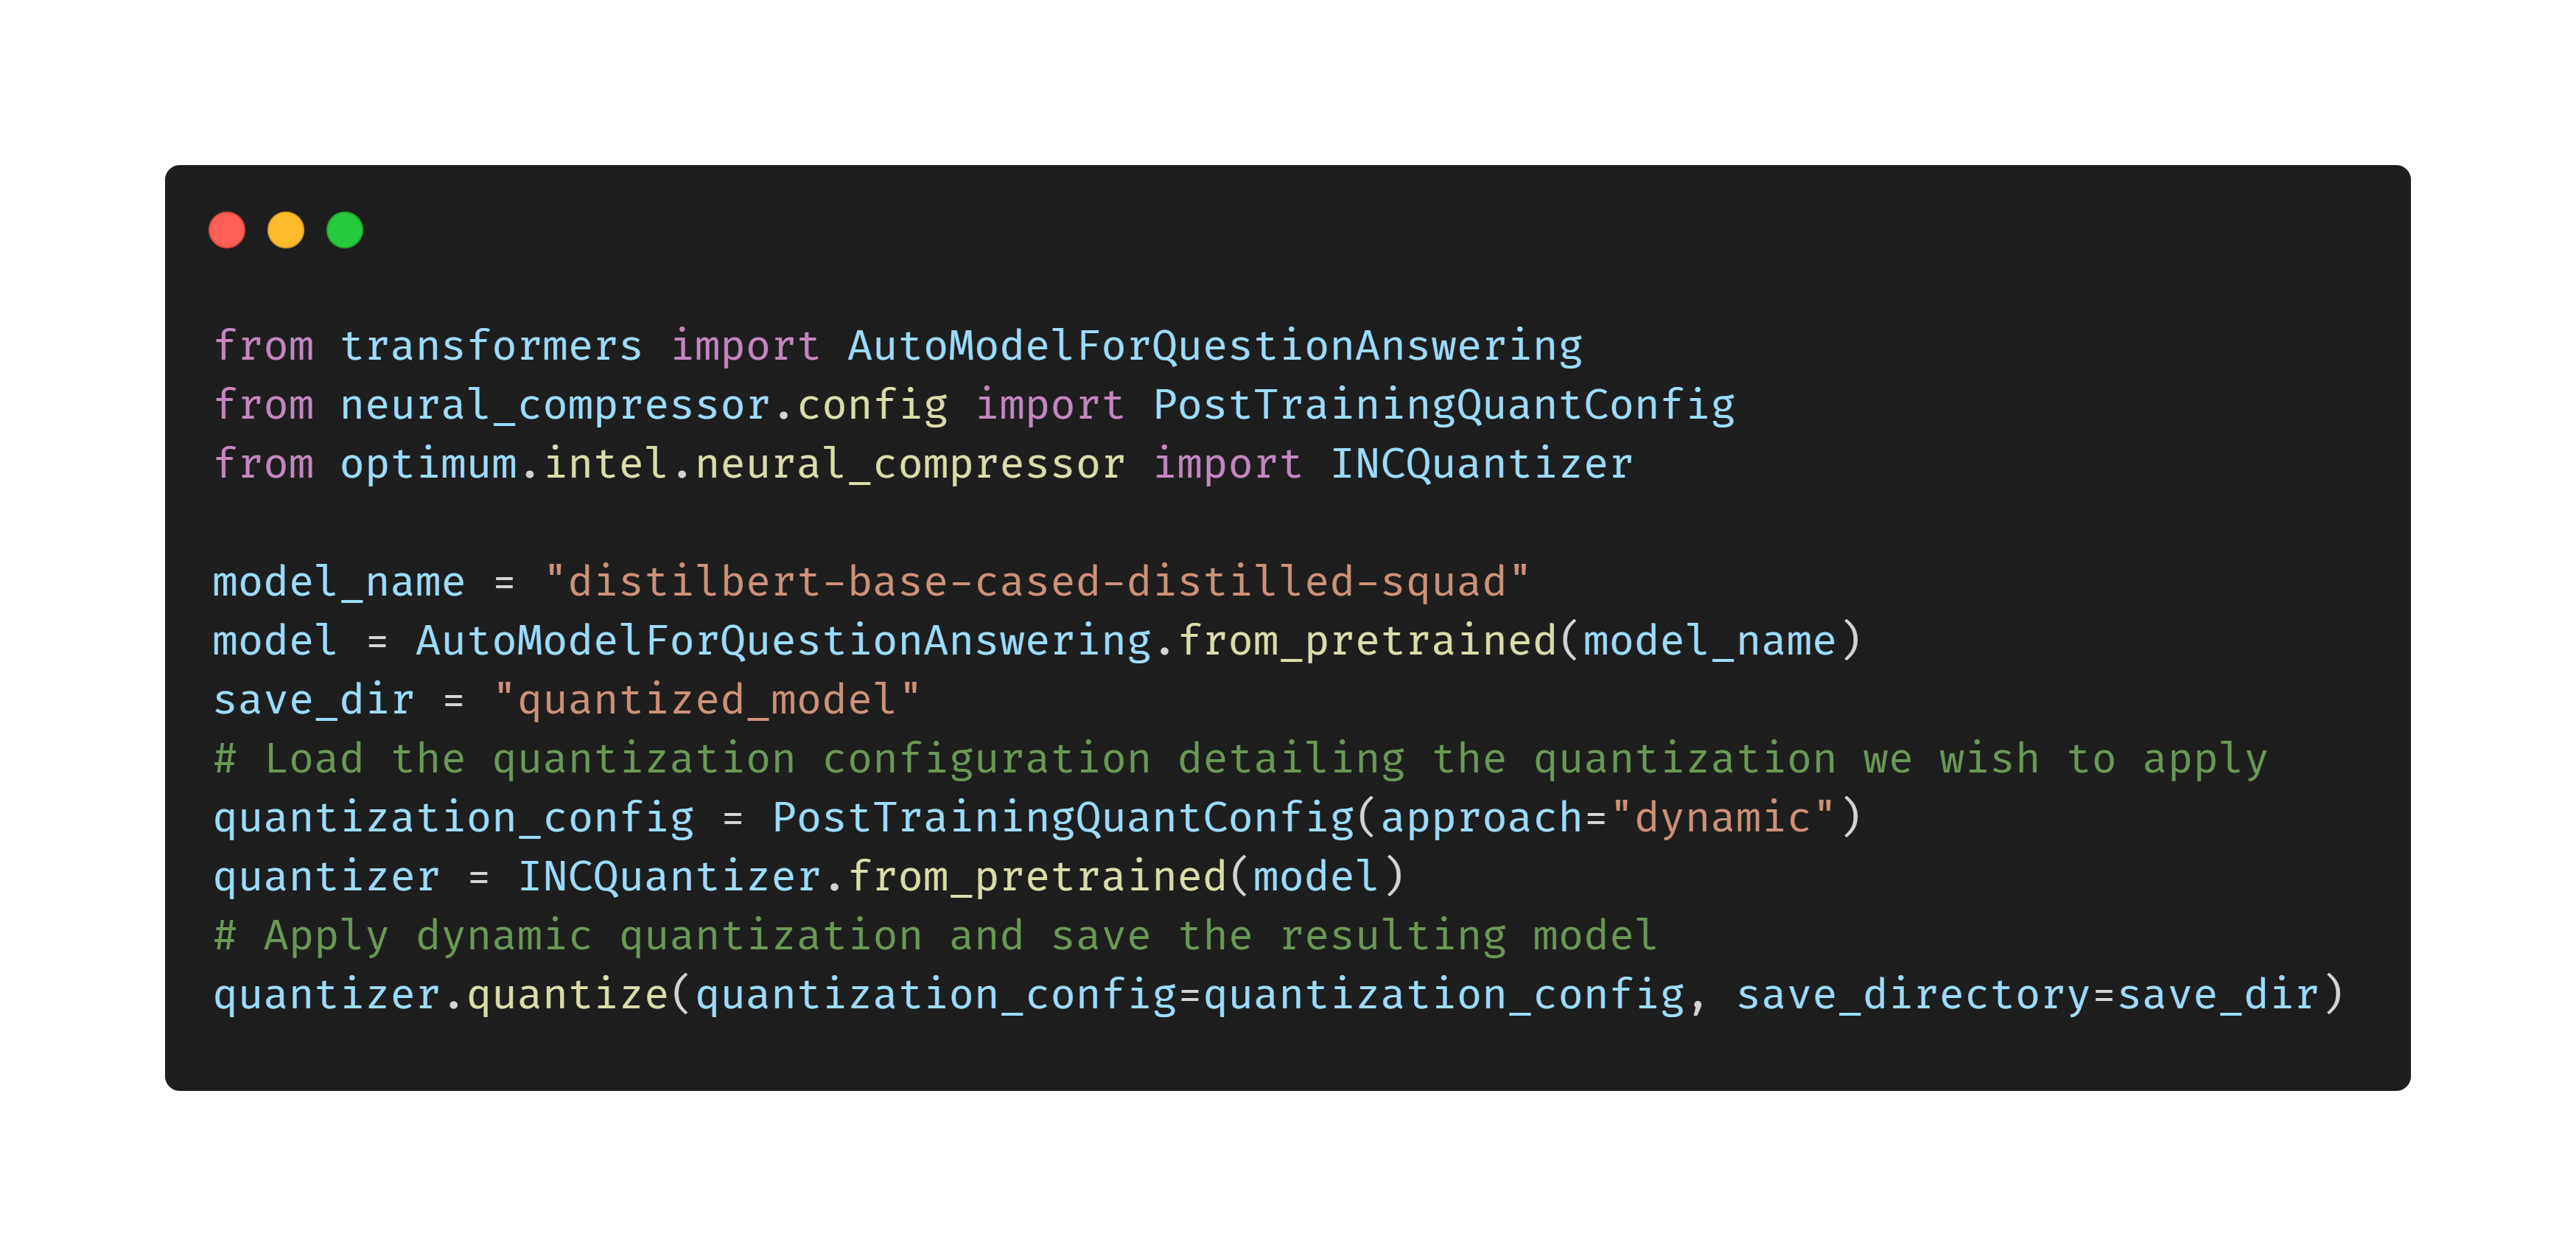
ტრანსფორმერული მოდელები, რომლებიც თანამედროვე ხელოვნური ინტელექტის განუყოფელი ნაწილია, ფართოდ გამოიყენება ტექნოლოგიური გიგანტების მიერ ისეთ სფეროებში, როგორიცაა ავტოპილოტი, ენის დამუშავება და ვიზუალური ამოცნობა. თუმცა, ამ მასიური მოდელების ეფექტურად წარმოებაში დანერგვა სერიოზულ გამოწვევებს აწყდება, განსაკუთრებით იმ გუნდებისთვის, რომლებსაც არ გააჩნიათ შეუზღუდავი რესურსები. Hugging Face-ის ახალი ღია კოდის ბიბლიოთეკა Optimum, Intel® Neural Compressor-თან თანამშრომლობით, მიზნად ისახავს ამ პროცესის გ
Intel Xeon Ice Lake: AI ამოცანების ოპტიმიზაცია პროგრამული გაუმჯობესებებით
Intel-ის უახლესი Ice Lake თაობის Xeon პროცესორები მნიშვნელოვან გაუმჯობესებას გვთავაზობს ხელოვნური ინტელექტის (AI) ამოცანებისთვის, განსაკუთრებით პროგრამული ოპტიმიზაციების დახმარებით. სტატია დეტალურად განიხილავს, თუ როგორ უზრუნველყოფს Intel-ი მაღალ ეფექტურობას AVX512, VNNI და oneAPI კომპონენტების, როგორიცაა oneMKL და oneDNN, მეშვეობით, ასევე სპეციალიზებული ფრეიმვორკებით, როგორიცაა Intel TensorFlow და PyTorch Extension. მიმოხილულია აპარატურული და პროგრამული ინოვაციების კომბინაცია, რამაც Ice Lake-ს
Intel Xeon Ice Lake: პროგრამული ოპტიმიზაციები ხელოვნური ინტელექტის ამოცანებისთვის
ეს ბლოგპოსტი დეტალურად განიხილავს Intel-ის ახალი Ice Lake თაობის Xeon CPU-ების პროგრამულ ოპტიმიზაციებს, რომლებიც მიზნად ისახავს ხელოვნური ინტელექტის (AI) დატვირთვების ეფექტურობის გაზრდას. აღწერილია, თუ როგორ იყენებს Intel როგორც აპარატურულ, ასევე პროგრამულ გაუმჯობესებებს, რათა მიაღწიოს 75%-ით უფრო სწრაფ ინფერენციას NLP ამოცანებში. სტატია ხაზს უსვამს Intel-ის როლს წამყვანი AI ფრეიმვორკების (როგორიცაა TensorFlow და PyTorch) ოპტიმიზაციაში, oneAPI ბიბლიოთეკების მნიშვნელობას მაღალი წარმადობისთვის, და

ღრმა სწავლის დაჩქარება Intel Xeon CPU-ებზე: ტრანსფერული სწავლის ახალი შესაძლებლობები
გრაფიკული პროცესორების (GPU) ნაცვლად, ტრანსფერული სწავლის განვითარება ღრმა სწავლის მოდელების ოპტიმიზაციისთვის CPU-ზე დაფუძნებულ კლასტერებს საინტერესო ალტერნატივად აქცევს. ეს სტატია განმარტავს, თუ როგორ შეიძლება PyTorch-ის სასწავლო ამოცანების დაჩქარება Intel Xeon Scalable CPU სერვერების გამოყენებით, Ice Lake არქიტექტურაზე დაფუძნებული ვირტუალური მანქანების კლასტერის შექმნით და წარმადობაზე ოპტიმიზებული პროგრამული ბიბლიოთეკების ინსტალაციით, როგორიცაა Intel extension for PyTorch და oneCCL.
PyTorch-ის სწავლების აჩქარება Intel Xeon პროცესორებზე: ღრმა სწავლის ახალი მიდგომა
გრაფიკული პროცესორები (GPUs) დიდი ხანია ღრმა სწავლის მოდელების სწავლების დე ფაქტო არჩევანი იყო. თუმცა, ტრანსფერული სწავლის ზრდა ცვლის თამაშის წესებს. მოდელები ახლა იშვიათად სწავლება ნულიდან უზარმაზარ მონაცემთა ნაკრებებზე; ამის ნაცვლად, ისინი ხშირად ზუსტდება კონკრეტულ (და მცირე) მონაცემთა ნაკრებებზე, რათა შეიქმნას სპეციალიზებული მოდელები, რომლებიც უფრო ზუსტია კონკრეტული ამოცანებისთვის, ვიდრე საბაზისო მოდელი. რადგან ეს სწავლების ამოცანები ბევრად უფრო ხანმოკლეა, CPU-ზე დაფუძნებული კლასტერის გამოყენ
Hugging Face Optimum და Graphcore IPU: Transformer მოდელების აჩქარება
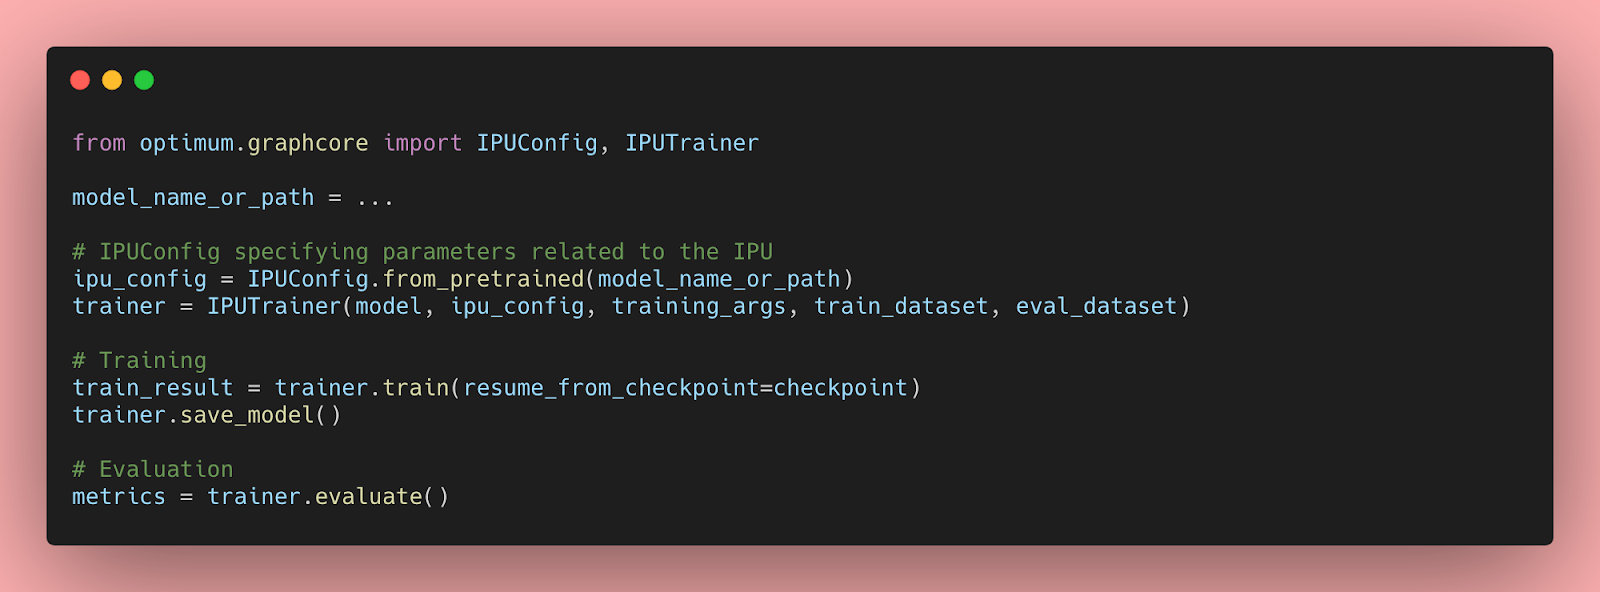
Hugging Face-მა წარმოადგინა Optimum, ღია კოდის ბიბლიოთეკა, რომელიც ამარტივებს Transformer მოდელების პროგნოზირების შეყოვნების შემცირებას სხვადასხვა აპარატურულ პლატფორმაზე. ეს ბლოგპოსტი გვიჩვენებს, თუ როგორ შეიძლება Transformer მოდელების დაჩქარება Graphcore Intelligence Processing Unit (IPU)-სთვის, რომელიც ხელოვნური ინტელექტის დატვირთვებისთვის შექმნილი მოქნილი პროცესორია. Graphcore-სა და Hugging Face-ს შორის პარტნიორობის ფარგლებში, BERT პირველი IPU-სთვის ოპტიმიზებული მოდელია. სტატია დეტალურად აღწე

TGI ახლა პირდაპირ მხარს უჭერს Intel Gaudi აპარატურას
გაცხადდა Intel Gaudi აპარატურის სრული ინტეგრაცია TGI-ის ძირითად კოდბაზაში, რაც გამორიცხავს ცალკეული „ფორკების“ საჭიროებას. ეს ახალი მრავალბექენდური არქიტექტურა ამარტივებს გამოყენებას, უზრუნველყოფს TGI-ის უახლეს ფუნქციებზე წვდომას და ოპტიმიზაციას უკეთებს დიდი ენობრივი მოდელების (LLMs) მუშაობას Gaudi მოწყობილობებზე. განცხადება ასევე ხაზს უსვამს მოწინავე ფუნქციებს, მოსალოდნელ მოდელებს და საზოგადოებისგან უკუკავშირის მიღების მოწვევას.
Hugging Face Infinity: ტრანსფორმერული მოდელების ოპტიმალური განთავსება Intel Xeon CPU-ებზე
Hugging Face Infinity არის კონტეინერიზებული გადაწყვეტა, რომელიც საშუალებას აძლევს კომპანიებს ეფექტურად განათავსონ ტრანსფორმერული მოდელები წარმოებაში დაბალი ლატენტურობითა და მაღალი გამტარუნარიანობით. ეს ბლოგ პოსტი წარმოადგენს დეტალურ წარმადობის შედეგებს Infinity-ის უახლესი თაობის Intel Xeon CPU-ებზე გაშვებისას (კერძოდ, Ice Lake-ზე დაფუძნებული EC2 C6i ინსტანსებზე), რაც უზრუნველყოფს ოპტიმალურ ღირებულებას, ეფექტურობასა და ლატენტურობას თქვენი Transformer-ის განთავსებისთვის.
SetFitABSA: ინოვაციური მიდგომა ასპექტზე დაფუძნებული სენტიმენტის ანალიზისთვის
SetFitABSA, Intel Labs-ისა და Hugging Face-ის მიერ წარმოდგენილი ფრეიმვორკი, წარმოადგენს ეფექტურ ტექნიკას ტექსტში კონკრეტული ასპექტების მიმართ სენტიმენტის აღმოსაჩენად. ის განკუთვნილია დომენის სპეციფიკური ABSA (ასპექტზე დაფუძნებული სენტიმენტის ანალიზი) მოდელების მცირე მონაცემებით (few-shot) წვრთნისთვის და კონკურენტუნარიანია, უმჯობესდება კიდეც გენერაციულ მოდელებს, როგორიცაა Llama2 და T5. მისი ძირითადი უპირატესობებია პრომპტების არარსებობა და სწრაფი წვრთნის შესაძლებლობა მცირე რაოდენობის ეტიკეტირებული

AutoRound: Intel-ის ინოვაციური მეთოდი ხელოვნური ინტელექტის მოდელების ოპტიმიზაციისთვის
AutoRound, Intel-ის მიერ შემუშავებული პოსტ-საწვრთნელი კვანტიზაციის (PTQ) მეთოდი, მნიშვნელოვნად აუმჯობესებს ხელოვნური ინტელექტის მოდელების ეფექტურობას მინიმალური სიზუსტის დაკარგვით. ის იყენებს ხელმოწერილ გრადიენტულ დაშვებას წონის დამრგვალებისა და ამოჭრის დიაპაზონების ოპტიმიზაციისთვის, რაც უზრუნველყოფს ზუსტ დაბალბიტიან კვანტიზაციას (INT2-INT8) და აღწევს 2.1-ჯერ მეტ ფარდობით სიზუსტეს INT2-ზე პოპულარულ ბაზისებთან შედარებით. მეთოდი სწრაფია, მსუბუქი და თავსებადია მრავალ LLM/VLM არქიტექტურასთან, რაც მა
Intel Xeon-ზე StarCoder-ის 7X-ზე მეტი დაჩქარება: LLM-ების ოპტიმიზაციის ახალი ეტაპი
კოდის გენერირების მოდელების მზარდი პოპულარობის ფონზე, ეს სტატია წარმოგიდგენთ დიდი ენობრივი მოდელების (LLM) ოპტიმიზაციის უახლეს შედეგებს Intel Xeon-ზე, განსაკუთრებული აქცენტით პოპულარულ StarCoder მოდელზე. ნაჩვენებია StarCoder-15B მოდელის 7-ჯერ მეტი ინფერენსის დაჩქარება Intel-ის მე-4 თაობის Xeon პროცესორებზე 8-ბიტიანი და 4-ბიტიანი კვანტიზაციისა და ასისტენტური გენერაციის ინტეგრაციის გზით. კვლევა ასევე ხაზს უსვამს SmoothQuant ალგორითმის გამოყენებას და მის დადებით გავლენას მოდელის სიზუსტესა და წარმად
დიდი ენობრივი მოდელების ოპტიმიზაცია Intel Xeon-ზე: StarCoder-ის აჩქარება კოდის გენერაციისთვის
სტატია მიმოიხილავს კოდის გენერაციის მოდელების, როგორიცაა StarCoder და Code Llama, მზარდ პოპულარობას და LLM-ების ოპტიმიზაციის ძალისხმევას ხელმისაწვდომობის გაზრდის მიზნით. ხაზგასმულია Intel-ის მიღწევა StarCoder-15B მოდელის 7-ჯერ მეტი ინფერენციის აჩქარებაში მე-4 თაობის Intel Xeon პროცესორებზე, 8-ბიტიანი და 4-ბიტიანი კვანტიზაციის ინტეგრაციით ასისტირებულ გენერაციასთან ერთად. განხილულია Intel AMX-ის როლი, SmoothQuant-ისა და WOQ კვანტიზაციის ტექნიკები, ასევე პროდუქტიულობის შეფასებები HumanEval-ისა და M