Intel Xeon Ice Lake: პროგრამული ოპტიმიზაციები ხელოვნური ინტელექტის ამოცანებისთვის
ეს ბლოგპოსტი დეტალურად განიხილავს Intel-ის ახალი Ice Lake თაობის Xeon CPU-ების პროგრამულ ოპტიმიზაციებს, რომლებიც მიზნად ისახავს ხელოვნური ინტელექტის (AI) დატვირთვების ეფექტურობის გაზრდას. აღწერილია, თუ როგორ იყენებს Intel როგორც აპარატურულ, ასევე პროგრამულ გაუმჯობესებებს, რათა მიაღწიოს 75%-ით უფრო სწრაფ ინფერენციას NLP ამოცანებში. სტატია ხაზს უსვამს Intel-ის როლს წამყვანი AI ფრეიმვორკების (როგორიცაა TensorFlow და PyTorch) ოპტიმიზაციაში, oneAPI ბიბლიოთეკების მნიშვნელობას მაღალი წარმადობისთვის, და
როგორც წინა ბლოგპოსტში დეტალურად აღვწერეთ, Intel Xeon CPU-ები გთავაზობთ ფუნქციების ერთობლიობას, რომელიც სპეციალურად შექმნილია ხელოვნური ინტელექტის (AI) დატვირთვებისთვის, როგორიცაა AVX512 ან VNNI (ვექტორული ნერვული ქსელის ინსტრუქციები), მთელრიცხოვნად კვანტიზებული ნერვული ქსელების გამოყენებით ეფექტური ინფერენციისთვის, და ასევე დამატებითი სისტემური ხელსაწყოები, რათა უზრუნველყოფილი იყოს სამუშაოს მაქსიმალურად ეფექტურად შესრულება.
ამ ბლოგპოსტში, ჩვენ ყურადღებას გავამახვილებთ პროგრამული უზრუნველყოფის ოპტიმიზაციებზე და წარმოგიდგენთ Intel-ის Xeon CPU-ების ახალი Ice Lake თაობის წარმადობის სურათს. ჩვენი მიზანია მოგაწოდოთ სრული ინფორმაცია იმის შესახებ, თუ რა არის ხელმისაწვდომი პროგრამული უზრუნველყოფის მხრივ, რათა მაქსიმალურად გამოიყენოთ თქვენი Intel-ის აპარატურა.
როგორც წინა ბლოგპოსტში, ჩვენ ვაჩვენებთ წარმადობას ბენჩმარკის შედეგებითა და დიაგრამებით, ასევე წარმოგიდგენთ ახალ ხელსაწყოებს, რათა ეს პარამეტრები და ფუნქციები მარტივი გამოსაყენებელი იყოს. აპრილში Intel-მა გამოუშვა Intel Xeon პროცესორების უახლესი თაობა, კოდური სახელწოდებით Ice Lake, რომელიც მიზნად ისახავს ხელოვნური ინტელექტის (AI) ამოცანების უფრო ეფექტურ და მაღალწარმადობას.
უფრო კონკრეტულად, Ice Lake Xeon CPU-ებს შეუძლიათ მიაღწიონ 75%-ით უფრო სწრაფ ინფერენციას სხვადასხვა NLP (ბუნებრივი ენის დამუშავების) ამოცანებში, წინა თაობის Cascade Lake Xeon პროცესორებთან შედარებით. ეს მიღწეულია როგორც აპარატურული, ასევე პროგრამული გაუმჯობესებების კომბინაციით, როგორიცაა ახალი ინსტრუქციები და PCIe 4.0, რომლებიც წარმოდგენილია ახალ Sunny Cove არქიტექტურაზე, მანქანური სწავლებისა და ღრმა სწავლების დატვირთვების მხარდასაჭერად.
და ბოლოს, Intel-მა იმუშავა სპეციალურ ოპტიმიზაციებზე სხვადასხვა ფრეიმვორკისთვის, რომლებიც ახლა Intel-ის ვერსიებით არის ხელმისაწვდომი, მაგალითად: Intel-ის გაფართოება Scikit Learn-ისთვის, Intel TensorFlow და Intel PyTorch Extension. ყველა ეს ფუნქცია ძალიან დაბალ დონეზეა, იმ ხელსაწყოების სტეკში, რომლებსაც მონაცემთა მეცნიერები და მანქანური სწავლების ინჟინრები ყოველდღიურად იყენებენ.
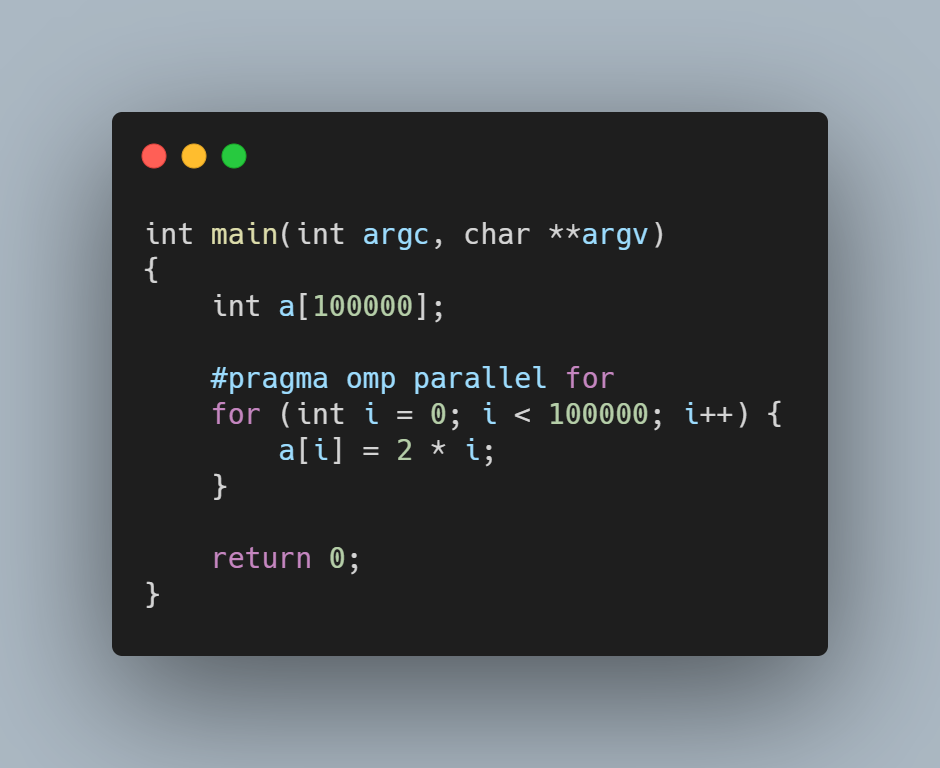
უმეტეს შემთხვევაში, უფრო გავრცელებულია მაღალი დონის ფრეიმვორკებსა და ბიბლიოთეკებზე დაყრდნობა მრავალგანზომილებიანი მასივების მანიპულირებისთვის, როგორიცაა PyTorch და TensorFlow, და მაღალოპტიმიზებული მათემატიკური ოპერატორების გამოყენება, როგორიცაა BLAS (ძირითადი ხაზოვანი ალგებრის ქვერუტინები), გამოთვლითი ნაწილისთვის. ამ სფეროში Intel არსებით როლს ასრულებს პროგრამული კომპონენტების მიწოდებით oneAPI ქოლგის ქვეშ, რაც ძალიან აადვილებს მაღალეფექტური ხაზოვანი ალგებრის რუტინების გამოყენებას Intel oneMKL-ის (მათემატიკური ბირთვის ბიბლიოთეკა), მაღალი დონის პარალელიზაციის ფრეიმვორკის – Intel OpenMP-ის, ან Threading Building Blocks (oneTBB)-ის მეშვეობით.
ასევე, oneAPI გთავაზობთ ზოგიერთ დომენის სპეციფიკურ ბიბლიოთეკას, როგორიცაა Intel oneDNN ღრმა ნერვული ქსელის პრიმიტივებისთვის (ReLU, სრულად დაკავშირებული და ა.შ.) ან oneCCL კოლექტიური კომუნიკაციისთვის, რაც განსაკუთრებით გამოსადეგია განაწილებული სისტემების გამოყენებისას, რათა მრავალ ჰოსტზე ეფექტური "all-reduce" ოპერაციები იყოს ხელმისაწვდომი. ზოგიერთი ამ ბიბლიოთეკიდან, განსაკუთრებით MKL ან oneDNN, ნატიურად არის ინტეგრირებული ისეთ ფრეიმვორკებში, როგორიცაა PyTorch და TensorFlow (ვერსია 2.5.0-დან), რათა ყველა წარმადობის გაუმჯობესება საბოლოო მომხმარებლისთვის ხელმისაწვდომი გახდეს დაუყოვნებლივ.
როდესაც მომხმარებელს სურს კონკრეტულ აპარატურულ მახასიათებლებზე ფოკუსირება, Intel გთავაზობთ ყველაზე გავრცელებული პროგრამული უზრუნველყოფის მორგებულ ვერსიებს, რომლებიც სპეციალურად Intel-ის პლატფორმისთვის არის ოპტიმიზებული. ეს ასეა, მაგალითად, TensorFlow-ის შემთხვევაში, რისთვისაც Intel უზრუნველყოფს ფრეიმვორკის მორგებულ, მაღალოპტიმიზებულ ვერსიებს, ან Intel PyTorch Extension (IPEX) ფრეიმვორკის შემთხვევაში, რომელიც შეიძლება განვიხილოთ, როგორც ფუნქციების ლაბორატორია PyTorch-ში ინტეგრაციამდე. როგორც ზემოთ აღინიშნა, ჩვენ განვიხილავთ ახალ რეგულირებად ელემენტებს ჩვენი AI აპლიკაციის წარმადობის გასაუმჯობესებლად. მაღალი დონის თვალსაზრისით, ყველა მანქანური სწავლებისა და ღრმა სწავლების ფრეიმვორკი შედგება ერთი და იგივე კომპონენტებისგან: ზემოთ ჩამოთვლილი პუნქტების გარდა, ღრმა სწავლების ფრეიმვორკები უზრუნველყოფენ მონაცემთა ნაკადის და დამოკიდებულებების წარმოდგენის გზებს გრადიენტების გამოსათვლელად. ეს სცილდება ამ ბლოგპოსტის ფარგლებს და იყენებს იმავე კომპონენტებს, რაც ზემოთ ჩამოთვლილია! ეს ბლოგპოსტი განზრახ გამოტოვებს პირველ პუნქტს მონაცემთა წარმოდგენის შესახებ, რადგან ეს საკმაოდ ფრეიმვორკ-სპეციფიკური საკითხია. ცნობისთვის, PyTorch იყენებს საკუთარ იმპლემენტაციას, სახელწოდებით ATen, ხოლო TensorFlow ამ მიზნით ეყრდნობა ღია კოდის ბიბლიოთეკა Eigen-ს. მიუხედავად იმისა, რომ ძალიან რთულია ზოგადი ოპტიმიზაციების გამოყენება სხვადასხვა ობიექტის სტრუქტურებსა და განლაგებაზე, არსებობს ერთი სფერო, სადაც ჩვენ შეგვიძლია გავლენის მოხდენა: მეხსიერების გამოყოფა. მოკლე შეხსენების სახით, მეხსიერების გამოყოფა აქ გულისხმობს ოპერაციული სისტემისთვის დინამიური (წინასწარ უცნობი) არეალის პროგრამულად მოთხოვნის პროცესს სისტემაზე, სადაც ჩვენ შევძლებთ ნივთების შენახვას, მაგალითად, malloc და მისი წარმოებულები C-ში, ან "new" ოპერატორი C++-ში. მეხსიერების ეფექტურობა, როგორც სიჩქარის, ასევე ფრაგმენტაციის თვალსაზრისით, არის ფართო სამეცნიერო და საინჟინრო საგანი მრავალი გადაწყვეტით, ამოცანისა და ქვედა დონის აპარატურის მიხედვით. გასული წლების განმავლობაში, ამ სფეროში სულ უფრო მეტი სამუშაო ვნახეთ, მათ შორის: თითოეული უბიძგებს სხვადასხვა მიდგომებს მეხსიერების გამოყოფისა და მართვის ასპექტების გასაუმჯობესებლად სხვადასხვა პროგრამულ უზრუნველყოფაში. ახლა, როცა გვაქვს მონაცემების ეფექტურად წარმოდგენის საშუალება, გვჭირდება გზა, რათა მაქსიმალურად გამოვიყენოთ ჩვენს ხელთ არსებული გამოთვლითი აპარატურა.
თეგები:
#ai
#ხელოვნური ინტელექტი
#მანქანური სწავლება
#ოპტიმიზაცია
#პროგრამული უზრუნველყოფა
#ღრმა სწავლება
#მეხსიერება
#pytorch
#tensorflow
#intel xeon
#cpu
#ice lake
#oneapi
წყარო: huggingface.co
AI-ით გადამუშავებული
მსგავსი სტატიები

ტექნოლოგიები
Honor Magic V6: უთხელესი დასაკეცი ტელეფონი? პირველი შთაბეჭდილებები
ტექნოლოგიები
Honor Magic V6: ყველაზე თხელი დასაკეცი სმარტფონი და მისი შთამბეჭდავი შესაძლებლობები

ტექნოლოგიები