BERT-ის ახალი სიჩქარე: ხელოვნური ინტელექტის მოდელების განთავსება TensorFlow Serving-ით
ტრანსფორმერების v4.2.0 ვერსიაში BERT-ის მოდელის გამოთვლითი წარმადობა მნიშვნელოვნად გაუმჯობესდა, რაც 10%-ით უფრო სწრაფია Google-ის ოფიციალურ იმპლემენტაციაზე და ორჯერ აღემატება v4.1.1-ის ვერსიას. სტატია დეტალურად აღწერს, თუ როგორ შეიძლება ამ გაუმჯობესებული წარმადობის გამოყენება საწარმოო გარემოში TensorFlow Serving-ის მეშვეობით BERT მოდელების განთავსებით. ის მოიცავს ნაბიჯ-ნაბიჯ ინსტრუქციებს SavedModel-ის შექმნის, Docker-ის გამოყენებით კონტეინერების გაშვების და REST/gRPC API-ების მეშვეობით მოდელთან
Hugging Face აუმჯობესებს BERT მოდელების ინფერენციის სიჩქარეს: დეტალური ბენჩმარკინგი და CPU ოპტიმიზაცია
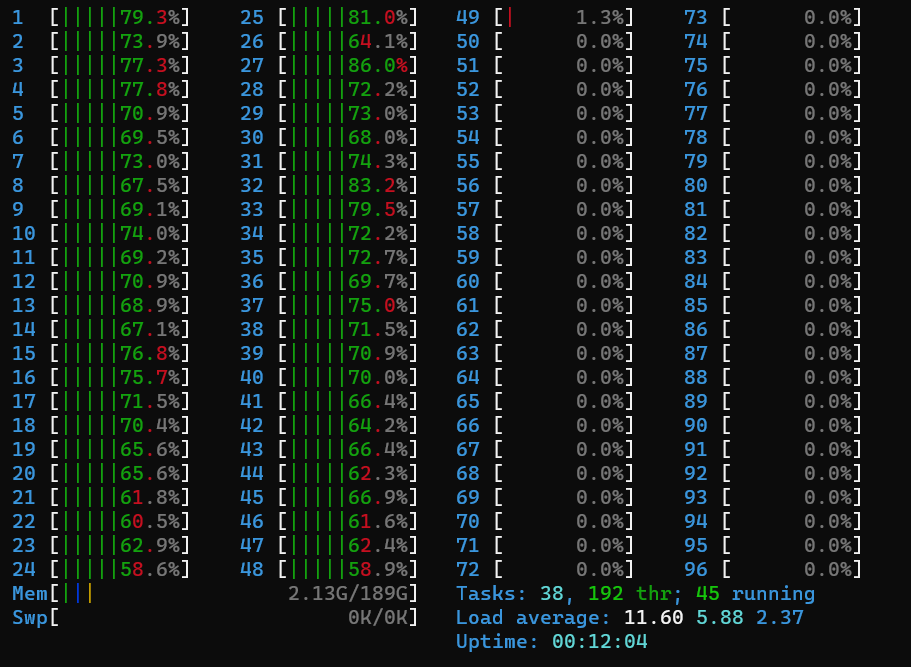
Hugging Face წარმოგიდგენთ განახლებულ ბენჩმარკინგის მეთოდოლოგიას და ახალ Inference API-ს, რათა ხელი შეუწყოს BERT-ის მსგავსი მოდელების ეფექტურ განლაგებასა და გაშვებას წარმოებაში. სტატია განიხილავს CPU-ზე დაფუძნებულ ტექნიკურ და პროგრამულ ოპტიმიზაციებს, აანალიზებს PyTorch-ისა და TensorFlow-ის მუშაობას და წარმოგიდგენთ მომავალ გაუმჯობესებებს, როგორიცაა კვანტიზაცია, დისტილაცია და პრუნინგი. მიზანია მომხმარებლებს გაუადვილდეს მოდელების ოპტიმიზებული სახით გამოყენება და ღირებულების შექმნაზე ფოკუსირება.
Intel Xeon Ice Lake: AI ამოცანების ოპტიმიზაცია პროგრამული გაუმჯობესებებით
Intel-ის უახლესი Ice Lake თაობის Xeon პროცესორები მნიშვნელოვან გაუმჯობესებას გვთავაზობს ხელოვნური ინტელექტის (AI) ამოცანებისთვის, განსაკუთრებით პროგრამული ოპტიმიზაციების დახმარებით. სტატია დეტალურად განიხილავს, თუ როგორ უზრუნველყოფს Intel-ი მაღალ ეფექტურობას AVX512, VNNI და oneAPI კომპონენტების, როგორიცაა oneMKL და oneDNN, მეშვეობით, ასევე სპეციალიზებული ფრეიმვორკებით, როგორიცაა Intel TensorFlow და PyTorch Extension. მიმოხილულია აპარატურული და პროგრამული ინოვაციების კომბინაცია, რამაც Ice Lake-ს
Intel Xeon Ice Lake: პროგრამული ოპტიმიზაციები ხელოვნური ინტელექტის ამოცანებისთვის
ეს ბლოგპოსტი დეტალურად განიხილავს Intel-ის ახალი Ice Lake თაობის Xeon CPU-ების პროგრამულ ოპტიმიზაციებს, რომლებიც მიზნად ისახავს ხელოვნური ინტელექტის (AI) დატვირთვების ეფექტურობის გაზრდას. აღწერილია, თუ როგორ იყენებს Intel როგორც აპარატურულ, ასევე პროგრამულ გაუმჯობესებებს, რათა მიაღწიოს 75%-ით უფრო სწრაფ ინფერენციას NLP ამოცანებში. სტატია ხაზს უსვამს Intel-ის როლს წამყვანი AI ფრეიმვორკების (როგორიცაა TensorFlow და PyTorch) ოპტიმიზაციაში, oneAPI ბიბლიოთეკების მნიშვნელობას მაღალი წარმადობისთვის, და
Vision Transformer მოდელის ლოკალურად განთავსება TensorFlow Serving-ის გამოყენებით
ეს პოსტი დეტალურად აღწერს, თუ როგორ უნდა მოხდეს Vision Transformer (ViT) მოდელის (გამოსახულების კლასიფიკაციისთვის) ლოკალურად განთავსება TensorFlow Serving-ის (TF Serving) მეშვეობით. ის განმარტავს მოდელის შენახვას SavedModel ფორმატში, წინასწარი და შემდგომი დამუშავების ნაბიჯების ინტეგრირებას გამოთვლით გრაფში და საბოლოოდ, მოდელის გაშვებას REST ან gRPC ენდპოინტებად TF Serving-ის გამოყენებით, რითაც შემცირდება დეველოპერების კოგნიტური დატვირთვა და გაუმჯობესდება სისტემის ეფექტურობა.

TensorFlow-ში ტექსტის გენერაციის დაჩქარება XLA-ს მეშვეობით
სტატია მიმოიხილავს დიდი ენობრივი მოდელების (LLM) განვითარებას და მათ ტექსტის გენერაციის შესაძლებლობებს. დეტალურად არის განხილული Hugging Face-ის `transformers` ბიბლიოთეკაში ტექსტის გენერაციის საფუძვლები TensorFlow-ს გამოყენებით, მათ შორის დეტერმინისტული და სტოქასტური მეთოდები, სემპლინგის კონტროლი და Beam Search. მთავარი აქცენტი გაკეთებულია TensorFlow-ში ტექსტის გენერაციის ოპტიმიზაციაზე XLA (Accelerated Linear Algebra) კომპაილერის მეშვეობით, რომელიც მნიშვნელოვნად აჩქარებს პროცესს და ამცირებს დაყო
Hugging Face Datasets: ახალი შესაძლებლობები აუდიო და გამოსახულების მონაცემებთან მუშაობისთვის
Hugging Face Datasets ბიბლიოთეკა აფართოებს თავის მხარდაჭერას ტექსტური მონაცემთა ნაკრებების მიღმა, რათა მოიცვას აუდიო და გამოსახულების ფორმატები. განახლებები მოიცავს ახალ ინსტრუმენტებს, როგორიცაა ImageFolder გამოსახულების მონაცემთა ნაკრებების მარტივად ჩატვირთვისა და მართვისთვის, to_tf_dataset ფუნქცია TensorFlow-თან ინტეგრაციის გასამარტივებლად და გაუმჯობესებულ დოკუმენტაციას სხვადასხვა მონაცემთა მოდალობასთან მუშაობისთვის. ეს ცვლილებები მიზნად ისახავს დეველოპერებისთვის მოდელების გაწვრთნისა და აპლიკა
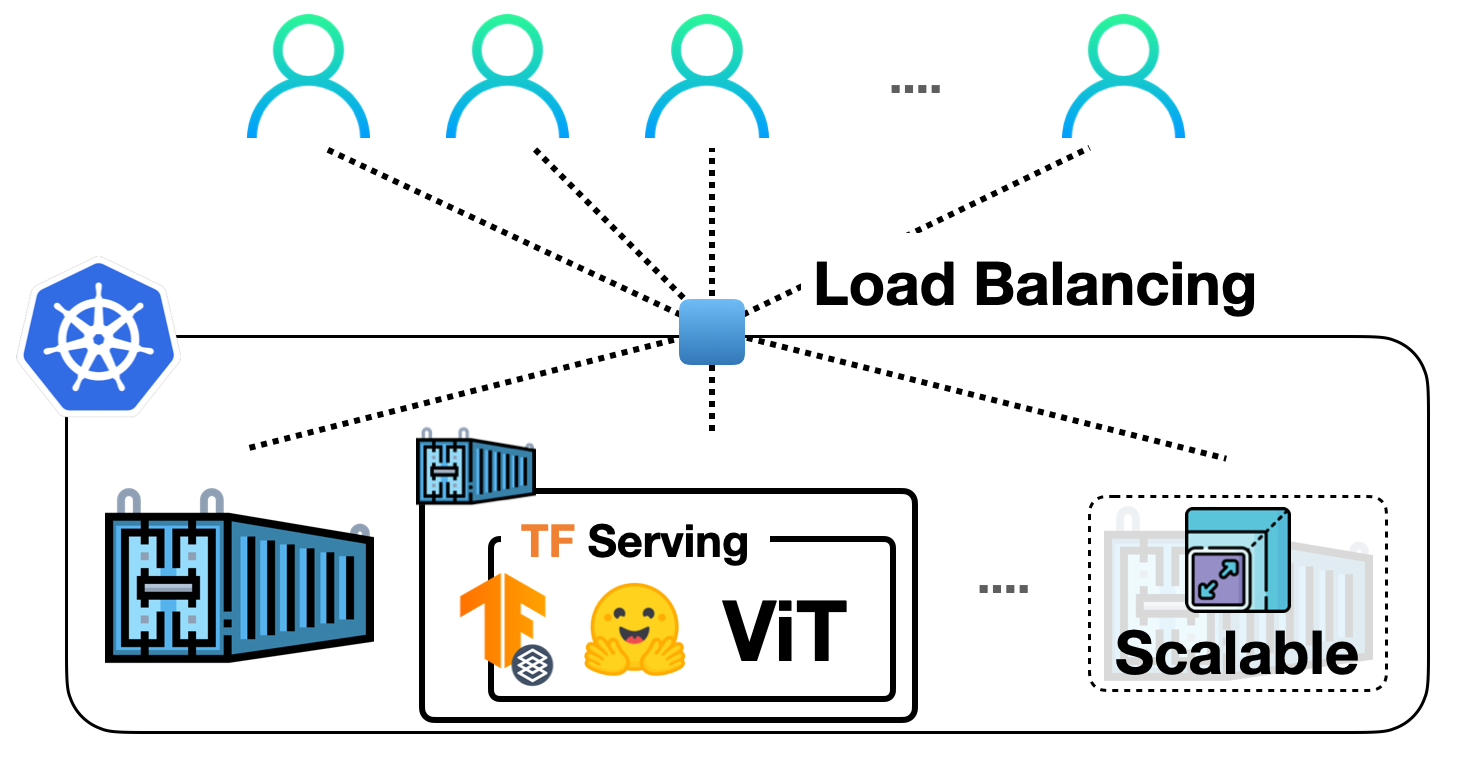
ML მოდელების მასშტაბირება Docker-ით და Kubernetes-ით: ლოკალურიდან სრულმასშტაბიან დეპლოიმენტამდე
ეს პოსტი გაწვდით დეტალურ სახელმძღვანელოს, თუ როგორ გადახვიდეთ მანქანური სწავლების მოდელების ლოკალური განთავსებიდან მასშტაბირებად, რეალურ პროექტებში გამოსაყენებელ სისტემებზე Docker-ისა და Kubernetes-ის გამოყენებით. სტატია აღწერს აპლიკაციის ლოგიკის კონტეინერიზაციას, Docker-ის კონტეინერების განთავსებას Kubernetes კლასტერზე (კერძოდ Google Kubernetes Engine-ზე - GKE), TensorFlow Serving-ის გამოყენებას მოდელების მომსახურებისთვის, მორგებული Docker გამოსახულებების შექმნას და მათ Google Container Registr
Hugging Face-ის მიდგომა: Transformers-ის ათვისება TensorFlow-ში Keras-ისა და ტრანსფერული სწავლების მეშვეობით
სტატია განიხილავს Hugging Face-ის ფილოსოფიას TensorFlow-ის ინჟინრებისთვის, რომლებიც იყენებენ Transformers-ის ბიბლიოთეკას. ის აკრიტიკებს Keras-ის მაღალდონიანი API-ის გვერდის ავლის გავრცელებულ პრაქტიკას და ხაზს უსვამს მის მნიშვნელობას. სტატია განმარტავს, თუ როგორ შეიძლება მძლავრი, წინასწარ გაწვრთნილი მოდელების გამოყენება ტრანსფერული სწავლების გზით, რაც ამცირებს მონაცემების საჭიროებას და ზრდის სიზუსტეს. ასევე, აღწერილია Hugging Face-ის მოდელების ინტეგრაცია ნაცნობ Keras-ის მეთოდებთან, როგორიცაა `fit
Hugging Face-ის ტრანსფორმატორები TensorFlow-ის ინჟინრებისთვის: გზამკვლევი
სტატია განიხილავს PyTorch-ის ინჟინრების მიერ TensorFlow-თან მიდგომის ხშირ შეცდომას, კერძოდ, Keras-ის მაღალი დონის API-ის უგულებელყოფას. ხაზგასმულია, რომ Keras-ის გამოყენება TensorFlow-სთან ოპტიმალურია. შემდეგ წარმოდგენილია Hugging Face-ის ტრანსფორმატორები, როგორც ძლიერი ინსტრუმენტები, რომლებიც TensorFlow-ის ინჟინრებს საშუალებას აძლევს, გამოიყენონ უახლესი მოდელები ნაცნობი Keras API-ის მეშვეობით. დეტალურად არის ახსნილი ტრანსფერული სწავლის (transfer learning) კონცეფცია, როგორც ML პრობლემების გადაჭრ
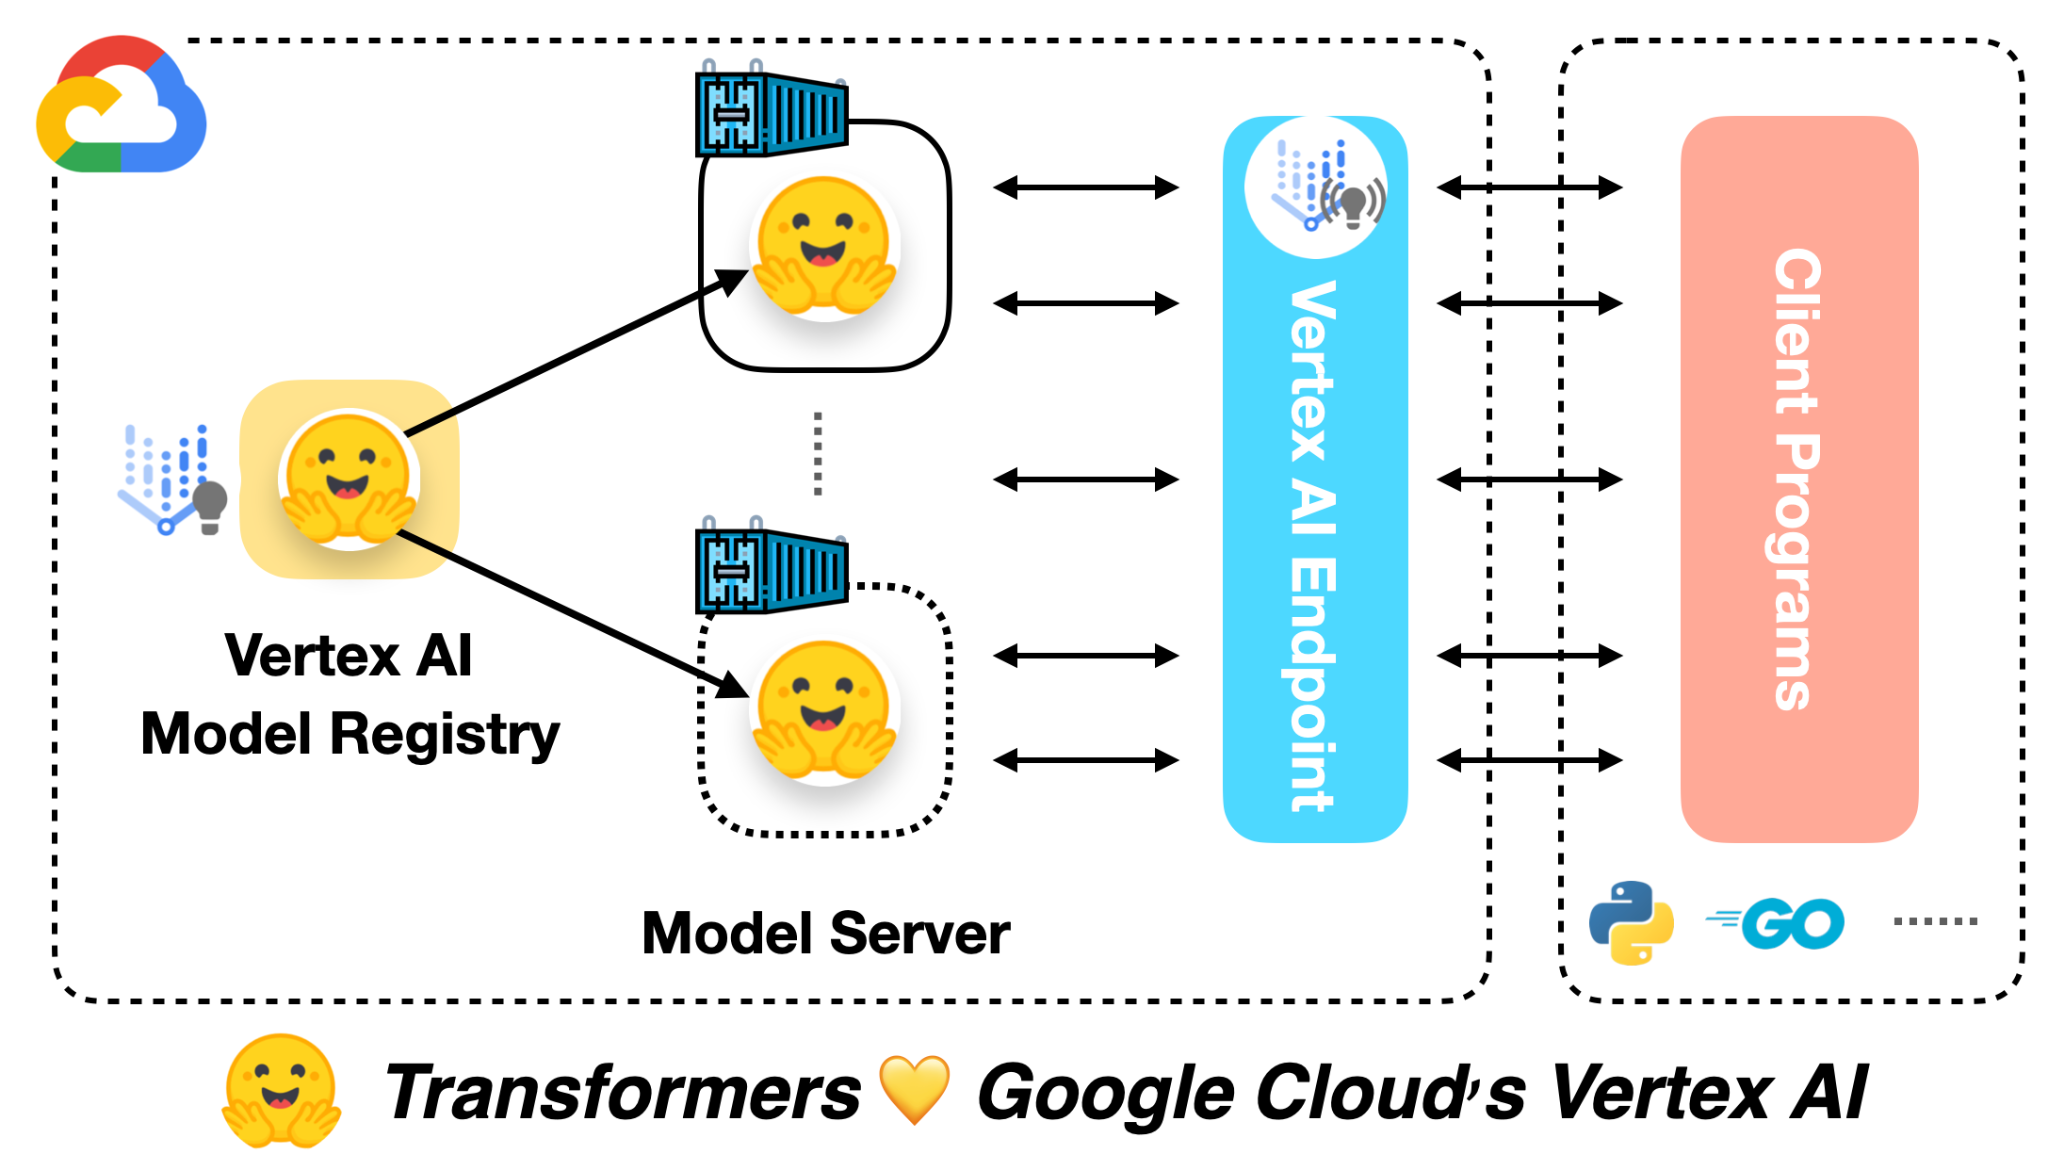
Vertex AI-ის გამოყენება ML მოდელების განლაგებისთვის: დეტალური მიმოხილვა
ეს პუბლიკაცია განიხილავს Google Cloud-ის Vertex AI პლატფორმის შესაძლებლობებს მანქანური სწავლის (ML) მოდელების განლაგებისთვის. ის მოიცავს ისეთ ფუნქციებს, როგორიცაა აუთენტიფიკაცია, ავტომატური სკალირება, მოდელის ვერსიონირება და მონიტორინგი, ასევე TensorFlow მოდელებთან მუშაობის სპეციფიკას. განმარტებულია Vertex AI Model Registry-ის და Endpoint-ის როლი, და მოცემულია განლაგების ნაბიჯ-ნაბიჯ ინსტრუქცია Python SDK-ის გამოყენებით.

KerasHub-ისა და Hugging Face-ის ინტეგრაცია: ხელმისაწვდომი ხდება 300 ათასზე მეტი AI მოდელი
KerasHub-მა და Hugging Face-მა მნიშვნელოვანი ნაბიჯი გადადგეს წინ, წარმოადგინეს მოდელების შენახვის საერთო ფორმატი, რომელიც KerasHub-ის მომხმარებლებს საშუალებას აძლევს პირდაპირ გამოიყენონ Transformers ბიბლიოთეკის 300 ათასზე მეტი მოდელი Hugging Face Hub-იდან. ეს ინტეგრაცია მნიშვნელოვნად აფართოებს მოდელების არჩევანსა და შესაძლებლობებს, მხარს უჭერს TensorFlow, JAX და PyTorch უკანა სისტემებს, რაც ამარტივებს AI მოდელების განთავსებას და კვლევას. თავდაპირველად ფოკუსირებულია Gemma (1 და 2), Llama 3 და Pal