Hugging Face აუმჯობესებს BERT მოდელების ინფერენციის სიჩქარეს: დეტალური ბენჩმარკინგი და CPU ოპტიმიზაცია
Hugging Face წარმოგიდგენთ განახლებულ ბენჩმარკინგის მეთოდოლოგიას და ახალ Inference API-ს, რათა ხელი შეუწყოს BERT-ის მსგავსი მოდელების ეფექტურ განლაგებასა და გაშვებას წარმოებაში. სტატია განიხილავს CPU-ზე დაფუძნებულ ტექნიკურ და პროგრამულ ოპტიმიზაციებს, აანალიზებს PyTorch-ისა და TensorFlow-ის მუშაობას და წარმოგიდგენთ მომავალ გაუმჯობესებებს, როგორიცაა კვანტიზაცია, დისტილაცია და პრუნინგი. მიზანია მომხმარებლებს გაუადვილდეს მოდელების ოპტიმიზებული სახით გამოყენება და ღირებულების შექმნაზე ფოკუსირება.
ოქტომბერში, 2019 წელს, ჩემმა კოლეგამ, ლისანდრე დებიუმ, გამოაქვეყნა ვრცელი (იმ დროისთვის) ბლოგ-პოსტი ინფერენციის შესრულების ბენჩმარკინგის შესახებ (1). მას შემდეგ, 🤗 transformers (2)-მა უამრავი ახალი არქიტექტურა მიიღო და ათასობით ახალი მოდელი დაემატა 🤗 hub-ს (3), რომელიც 2021 წლის პირველი კვარტლის მონაცემებით 9,000-ზე მეტ მოდელს ითვლის. რადგან NLP-ის (ბუნებრივი ენის დამუშავების) ლანდშაფტი სულ უფრო მეტად მიდის BERT-ის მსგავსი მოდელების პროდუქციაში გამოყენებისკენ, ამ არქიტექტურების ეფექტურად განლაგება და მასშტაბურად გაშვება კვლავ რთულ გამოწვევად რჩება. სწორედ ამიტომ, ჩვენ ცოტა ხნის წინ წარმოგიდგენთ ჩვენს 🤗 Inference API-ს: რათა მომხმარებლებისთვის ღირებულების შექმნაზე ფოკუსირდეთ, ნაცვლად იმისა, რომ ასეთი მოდელების გაშვების უაღრესად ტექნიკურ ასპექტებში ჩაეძიოთ.
ეს ბლოგ-პოსტი სერიის პირველი ნაწილია, რომელიც მოიცავს ტექნიკურ და პროგრამულ ოპტიმიზაციების უმეტესობას, რათა უკეთესად იქნას გამოყენებული პროცესორები (CPU) BERT მოდელების ინფერენციისთვის. ამ საწყისი ბლოგ-პოსტისთვის ჩვენ განვიხილავთ აპარატურულ ნაწილს: გადავწყვიტეთ ფოკუსირება მოვახდინოთ ყველაზე ცნობილ Transformer მოდელის არქიტექტურაზე, BERT-ზე (Delvin & al. 2018) (4). მიუხედავად იმისა, რომ სტატიის მოკლედ შენარჩუნების მიზნით, ამ ბლოგ-პოსტში აქცენტი გაკეთებულია BERT-ის მსგავს მოდელებზე, აღწერილი ყველა ტექნიკა შეიძლება გამოყენებულ იქნას Hugging Face-ის მოდელების ჰაბში არსებულ ნებისმიერ არქიტექტურაზე. ამ ბლოგ-პოსტში დეტალურად არ იქნება აღწერილი Transformer არქიტექტურა - ამის შესახებ ინფორმაციის მისაღებად ძალიან გირჩევთ ჯეი ალამარის (Jay Alammar) „ილუსტრირებული Transformer“ ბლოგ-პოსტს (5).
დღევანდელი მიზნებია მოგაწოდოთ ინფორმაცია, თუ სად ვართ ღია კოდის პერსპექტივიდან, PyTorch-სა და TensorFlow-ზე BERT-ის მსგავსი მოდელების ინფერენციის გამოყენებისას, ასევე რისი გამოყენება შეგიძლიათ მარტივად ინფერენციის დასაჩქარებლად. როდესაც საქმე ეხება Hugging Face-ის მოდელების ჰაბიდან BERT-ის მსგავსი მოდელების გამოყენებას, არსებობს მრავალი პარამეტრი, რომელთა დარეგულირება შესაძლებელია პროცესების დასაჩქარებლად. გარდა ამისა, იმისათვის, რომ შევაფასოთ, რას ნიშნავს „უფრო სწრაფად“, ჩვენ დავეყრდნობით ფართოდ მიღებულ მეტრიკებს: ეს ორი მეტრიკა დაგვეხმარება ამ ბლოგ-პოსტის განმავლობაში უპირატესობებისა და კომპრომისების გაგებაში.
ბენჩმარკინგის მეთოდოლოგია თავიდან იქნა დანერგილი, რათა ინტეგრირებულიყო transformers-ის მიერ მოწოდებული უახლესი ფუნქციები და ასევე, რათა საზოგადოებას უფრო მარტივი გზით შეეძლოს ბენჩმარკების გაშვება და გაზიარება. მთელი ფრეიმვორკი ახლა Facebook AI & Research-ის Hydra კონფიგურაციის ბიბლიოთეკას ეფუძნება, რაც საშუალებას გვაძლევს მარტივად მოვახსენოთ და თვალყური ვადევნოთ ყველა იმ კომპონენტს, რომელიც ბენჩმარკის გაშვებისას არის ჩართული, რითაც იზრდება საერთო რეპროდუცირებადობა. პროექტის სრული სტრუქტურის ნახვა შეგიძლიათ აქ. 2021 წლის ვერსიაში, წინა ბლოგის (1) მსგავსად, შევინარჩუნეთ ინფერენციის დატვირთვის გაშვების შესაძლებლობა PyTorch-სა და TensorFlow-ს მეშვეობით, მათ ტრეისირებულ ანალოგებთან, TorchScript-თან (6) და Google Accelerated Linear Algebra (XLA) (7)-თან ერთად. გარდა ამისა, გადავწყვიტეთ ONNX Runtime (8)-ის მხარდაჭერის ჩართვა, რადგან ის უზრუნველყოფს მრავალ ოპტიმიზაციას, რომლებიც კონკრეტულად transformers-ზე დაფუძნებულ მოდელებს ესახება მიზნად, რაც მას ძლიერ კანდიდატად აქცევს შესრულების განხილვისას. და ბოლოს, ეს ახალი ერთიანი ბენჩმარკინგის გარემო საშუალებას მოგვცემს მარტივად გავუშვათ ინფერენცია სხვადასხვა სცენარისთვის, როგორიცაა კვანტიზებული მოდელები (Quantized Models) (Zafrir & al.) (9) ნაკლებად ზუსტი რიცხვითი წარმოდგენების (float16, int8, int4) გამოყენებით. ეს მეთოდი, ცნობილი როგორც კვანტიზაცია, სულ უფრო ფართოდ არის მიღებული ყველა ძირითადი აპარატურის მიმწოდებლის მიერ. უახლოეს მომავალში, გვსურს ინტეგრირება გავუკეთოთ დამატებით მეთოდებს, რომლებზეც აქტიურად ვმუშაობთ Hugging Face-ში, კერძოდ: დისტილაცია (Distillation), პრუნინგი (Pruning) და სპარსიფიკაცია (Sparsificaton).
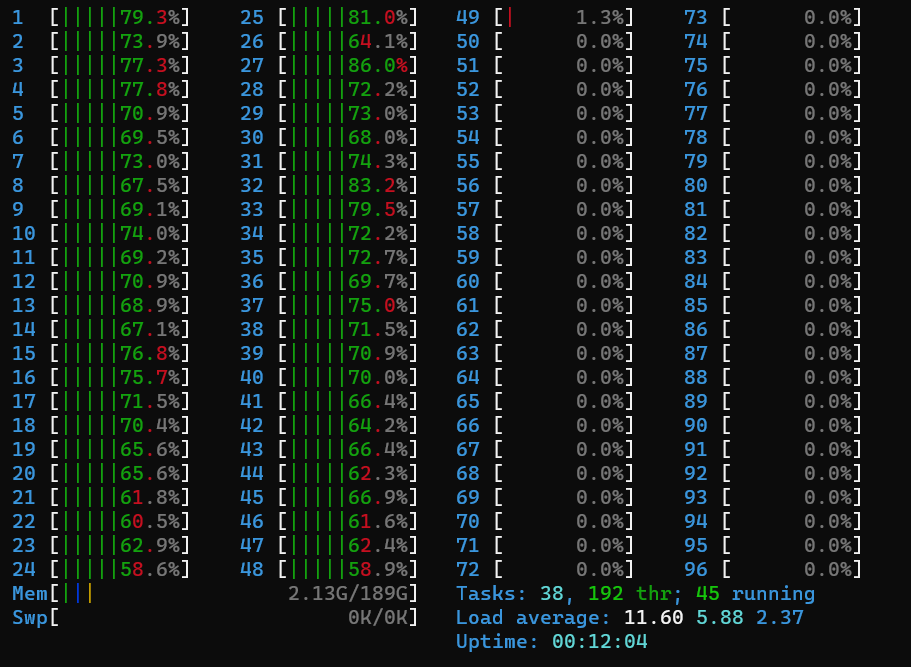
ყველა ქვემოთ მოცემული შედეგი მიღებული იქნა Amazon Web Services (AWS) c5.metal ინსტანციაზე, Intel Xeon Platinum 8275 CPU-ის (48 ბირთვი/96 თრედი) გამოყენებით. ამ ინსტანციის არჩევა უზრუნველყოფს CPU-ს ყველა სასარგებლო ფუნქციას ღრმა სწავლის (Deep Learning) სამუშაო დატვირთვების დასაჩქარებლად, როგორიცაა: „მეტალ“ ინსტანციის გამოყენების არჩევანი განპირობებულია ვირტუალიზაციის ნებისმიერი პრობლემის თავიდან აცილებით, რომელიც შეიძლება წარმოიშვას ღრუბლოვანი სერვისის მიმწოდებლების გამოყენებისას. ეს გვაძლევს აპარატურის სრულ კონტროლს, განსაკუთრებით NUMA (არათანაბარი მეხსიერების არქიტექტურა) კონტროლერზე ფოკუსირებისას, რასაც ამ პოსტის შემდგომ ნაწილში განვიხილავთ. ოპერაციული სისტემა იყო Ubuntu 20.04 (LTS) და ყველა ექსპერიმენტი ჩატარდა Hugging Face transformers-ის ვერსია 4.5.0, PyTorch 1.8.1 და Google TensorFlow 2.4.0-ის გამოყენებით.
პირდაპირ სათქმელად, ქარხნული პარამეტრებით, PyTorch აჩვენებს ინფერენციის უკეთეს შედეგებს, ვიდრე TensorFlow, ყველა აქ გამოცდილი კონფიგურაციისთვის. მნიშვნელოვანია აღინიშნოს, რომ ქარხნული პარამეტრების შედეგები შეიძლება არ ასახავდეს „ოპტიმალურ“ დაყენებას როგორც PyTorch-ისთვის, ასევე TensorFlow-სთვის და, შესაბამისად, აქ შეიძლება შეცდომაში შემყვანად გამოიყურებოდეს. ამ ორ ფრეიმვორკს შორის ასეთი განსხვავების შესაძლო ახსნა შეიძლება იყოს ოპერატორებში პარალელური სექციების შესასრულებელი საბაზისო ტექნოლოგია. PyTorch შიდად იყენებს OpenMP-ს (10) Intel MKL-თან (ახლა oneDNN) (11) ერთად ეფექტური წრფივი ალგებრის გამოთვლებისთვის, ხოლო TensorFlow ეყრდნობა Eigen-ს და მის საკუთარ თრედინგის იმპლემენტაციას. არსებობს მრავალი გზა, რათა გაუმჯობესდეს ლატენტურობა და გამტარუნარიანობა ისეთი ამოცანებისთვის, როგორიცაა BERT ინფერენცია. გაუმჯობესება და ოპტიმიზაცია შეიძლება განხორციელდეს სხვადასხვა დონეზე, ოპერაციული სისტემის ფუნქციების ჩართვიდან, დამოკიდებული ბიბლიოთეკების უფრო პროდუქტიულით ჩანაცვლებიდან, ფრეიმვორკის თვისებების ფრთხილი რეგულირებიდან და, ბოლოს
თეგები:
#ai
#hugging face
#pytorch
#tensorflow
#nlp
#bert
#deep learning
#ინფერენცია
#ბენჩმარკინგი
#cpu ოპტიმიზაცია
#quantization
წყარო: huggingface.co
AI-ით გადამუშავებული


