Bark TTS მოდელის ოპტიმიზაცია Hugging Face ეკოსისტემით: მეხსიერება და ინფერენსის გაუმჯობესება
ეს სტატია წარმოგიდგენთ 'Bark' ტექსტიდან მეტყველებად გარდამქმნელი (TTS) მოდელის ოპტიმიზაციის პრაქტიკულ სახელმძღვანელოს Hugging Face-ის 'Transformers', 'Optimum' და 'Accelerate' ბიბლიოთეკების გამოყენებით. დეტალურად განიხილება მეხსიერების მოხმარების შემცირებისა და ინფერენსის სიჩქარის გაუმჯობესების სამი მარტივი მეთოდი, მათ შორის 'Better Transformer' და 'Flash Attention'. ასევე ნაჩვენებია ოპტიმიზებული და არაოპტიმიზებული მოდელების წარმადობის შედარებისა და ბენჩმარკინგის პროცესი.

AI მოდელების მასშტაბური ინფერენციის ოპტიმიზაცია: ხარჯი და შეყოვნება
ეს სტატია დეტალურად აღწერს მეთოდოლოგიას ენკოდერული მოდელების გამოყენებით მასშტაბური კლასიფიკაციისა და ემბედინგის ამოცანებისთვის ხარჯებისა და შეყოვნების გამოსათვლელად და ოპტიმიზაციისთვის. განხილულია მოდელების არქიტექტურები, აპარატურული ხარჯების ბენჩმარკინგი და ოპტიმიზაციის ჩარჩო. გამოყენებულია ისეთი ინსტრუმენტები, როგორიცაა Inference Endpoints აპარატურის შერჩევისთვის, Hugging Face Hub განთავსებისთვის, Infinity ინფერენციის სერვერისთვის და Grafana-ს k6 დატვირთვის ტესტირებისთვის. მოცემულია პრაქტიკულ
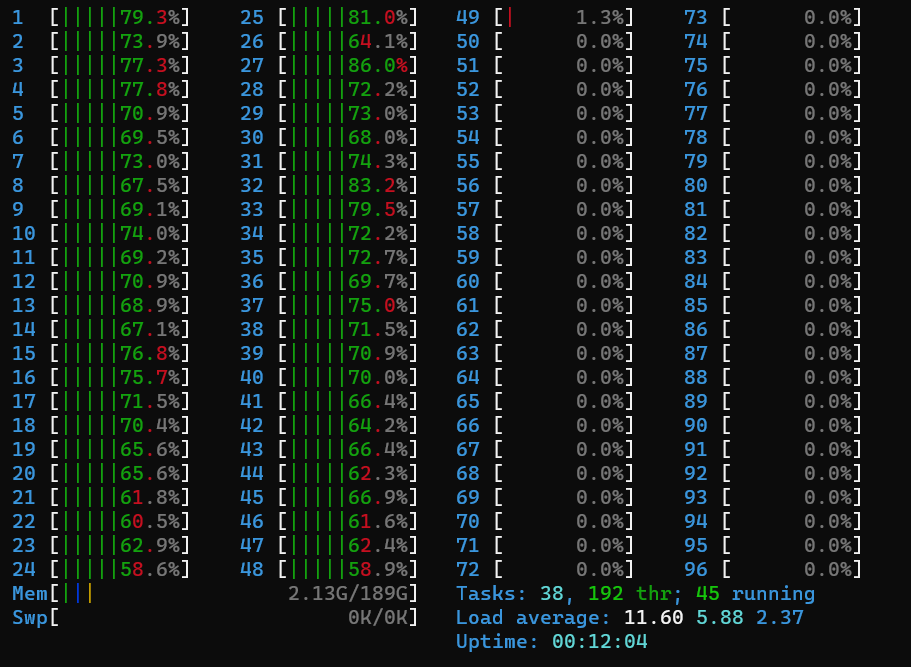
Hugging Face აუმჯობესებს BERT მოდელების ინფერენციის სიჩქარეს: დეტალური ბენჩმარკინგი და CPU ოპტიმიზაცია
Hugging Face წარმოგიდგენთ განახლებულ ბენჩმარკინგის მეთოდოლოგიას და ახალ Inference API-ს, რათა ხელი შეუწყოს BERT-ის მსგავსი მოდელების ეფექტურ განლაგებასა და გაშვებას წარმოებაში. სტატია განიხილავს CPU-ზე დაფუძნებულ ტექნიკურ და პროგრამულ ოპტიმიზაციებს, აანალიზებს PyTorch-ისა და TensorFlow-ის მუშაობას და წარმოგიდგენთ მომავალ გაუმჯობესებებს, როგორიცაა კვანტიზაცია, დისტილაცია და პრუნინგი. მიზანია მომხმარებლებს გაუადვილდეს მოდელების ოპტიმიზებული სახით გამოყენება და ღირებულების შექმნაზე ფოკუსირება.
Llama 2-ის განლაგების ბენჩმარკინგი Amazon SageMaker-ზე: ოპტიმალური სტრატეგიები წარმადობისა და ხარჯთეფექტურობისთვის
დიდი ენობრივი მოდელების (LLM) განლაგება, როგორიცაა Llama 2, კომპლექსური გამოწვევაა. Amazon Web Services-მა ჩაატარა მასშტაბური ბენჩმარკინგი, შეაფასა Llama 2-ის 60-ზე მეტი კონფიგურაცია Amazon SageMaker-ზე, Hugging Face LLM დასკვნის კონტეინერის გამოყენებით. კვლევამ გააანალიზა შეყოვნება და გამტარობა Llama 2-ის სხვადასხვა ზომისა და EC2 ინსტანციების მიხედვით, რათა შეემუშავებინა ოპტიმალური რეკომენდაციები ხარჯთეფექტურობის, მაქსიმალური გამტარობისა და მინიმალური შეყოვნებისთვის. ძირითადი აღმოჩენები მოიცავს

BLOOM ინფერენსის ოპტიმიზაცია GPU-ებზე: წარმადობის ბენჩმარკინგი
ეს სტატია განიხილავს BLOOM ხელოვნური ინტელექტის მოდელის ინფერენსის ოპტიმიზაციას სხვადასხვა GPU კონფიგურაციებზე. მოცემულია აპარატურული მოთხოვნები 352GB bf16 წონებისთვის, სადაც რეკომენდებულია 8x80GB A100 GPU-ები, თუმცა განიხილება ალტერნატივებიც. სტატია აანალიზებს მოდელის ჩატვირთვის დროს და ტოკენების გენერირების წარმადობას (throughput) ისეთი გადაწყვეტების გამოყენებით, როგორიცაა Deepspeed-Inference და Accelerate, ასევე 8-ბიტიანი კვანტიზაცია მეხსიერების შესამცირებლად. ბენჩმარკინგის შედეგები აჩვენებს
MTEB: საუკეთესო ტექსტური ემბედინგის მოდელების ყოვლისმომცველი პლატფორმა და შეფასება
MTEB არის ყოვლისმომცველი ლიდერბორდი და ბენჩმარკინგის პლატფორმა, რომელიც აფასებს ტექსტური ემბედინგის მოდელებს მრავალფეროვან ამოცანებსა და მონაცემთა ნაკრებებზე. ის ეხმარება მომხმარებლებს იპოვონ საუკეთესო მოდელი მათი საჭიროებებისთვის, გამოირჩევა მასიურობით (56 მონაცემთა ნაკრები 8 ამოცანაში), მრავალენოვნებით (112-მდე ენა) და გაფართოებადობით. სტატია განმარტავს ტექსტური ემბედინგის მნიშვნელობას, MTEB-ის მახასიათებლებს და მოდელების შერჩევის კრიტერიუმებს, სიჩქარისა და შესრულების ჩათვლით.

Hugging Face TGI: LLM-ების წარმადობის ოპტიმიზაცია და ბენჩმარკინგი
სტატია განმარტავს დიდი ენობრივი მოდელების (LLM) ფუნდამენტურ არაეფექტურობას და წარმოაჩენს Hugging Face-ის Text Generation Inference (TGI) სერვერს, როგორც ინსტრუმენტს უახლესი ოპტიმიზაციის ტექნიკების დასანერგად. ის ხაზს უსვამს ბენჩმარკინგის მნიშვნელობას სხვადასხვა გამოყენების შემთხვევებისთვის, როგორიცაა RAG და ჩატბოტები, და განმარტავს ლატენტურობისა და გამტარუნარიანობის, როგორც ორთოგონალური მეტრიკების, როლს. ავტორი გვიჩვენებს, თუ როგორ შეიძლება TGI ბენჩმარკინგის ინსტრუმენტის გამოყენება Hugging Face
LLM ინფერენსის ოპტიმიზაცია: Hugging Face TGI ბენჩმარკინგი
ეს სტატია განმარტავს, თუ როგორ ხდება დიდი ენობრივი მოდელების (LLM) ინფერენსის ოპტიმიზაცია Hugging Face-ის მაღალეფექტური ტექსტის გენერაციის ინფერენსის (TGI) სერვერის გამოყენებით. დეტალურად განიხილება LLM-ების თანდაყოლილი არაეფექტურობა, ინდუსტრიის მიერ მიღწეული გაუმჯობესებები მუშაობის ოპტიმიზაციაში, ასევე ბენჩმარკინგის მნიშვნელობა სხვადასხვა გამოყენების შემთხვევებისთვის, როგორიცაა RAG და ჩატი. სახელმძღვანელო განმარტავს ძირითად მეტრიკებს, როგორიცაა ლატენტურობა და გამტარუნარიანობა, და გვიჩვენებს, თუ