ML მოდელების მასშტაბირება Docker-ით და Kubernetes-ით: ლოკალურიდან სრულმასშტაბიან დეპლოიმენტამდე
ეს პოსტი გაწვდით დეტალურ სახელმძღვანელოს, თუ როგორ გადახვიდეთ მანქანური სწავლების მოდელების ლოკალური განთავსებიდან მასშტაბირებად, რეალურ პროექტებში გამოსაყენებელ სისტემებზე Docker-ისა და Kubernetes-ის გამოყენებით. სტატია აღწერს აპლიკაციის ლოგიკის კონტეინერიზაციას, Docker-ის კონტეინერების განთავსებას Kubernetes კლასტერზე (კერძოდ Google Kubernetes Engine-ზე - GKE), TensorFlow Serving-ის გამოყენებას მოდელების მომსახურებისთვის, მორგებული Docker გამოსახულებების შექმნას და მათ Google Container Registr
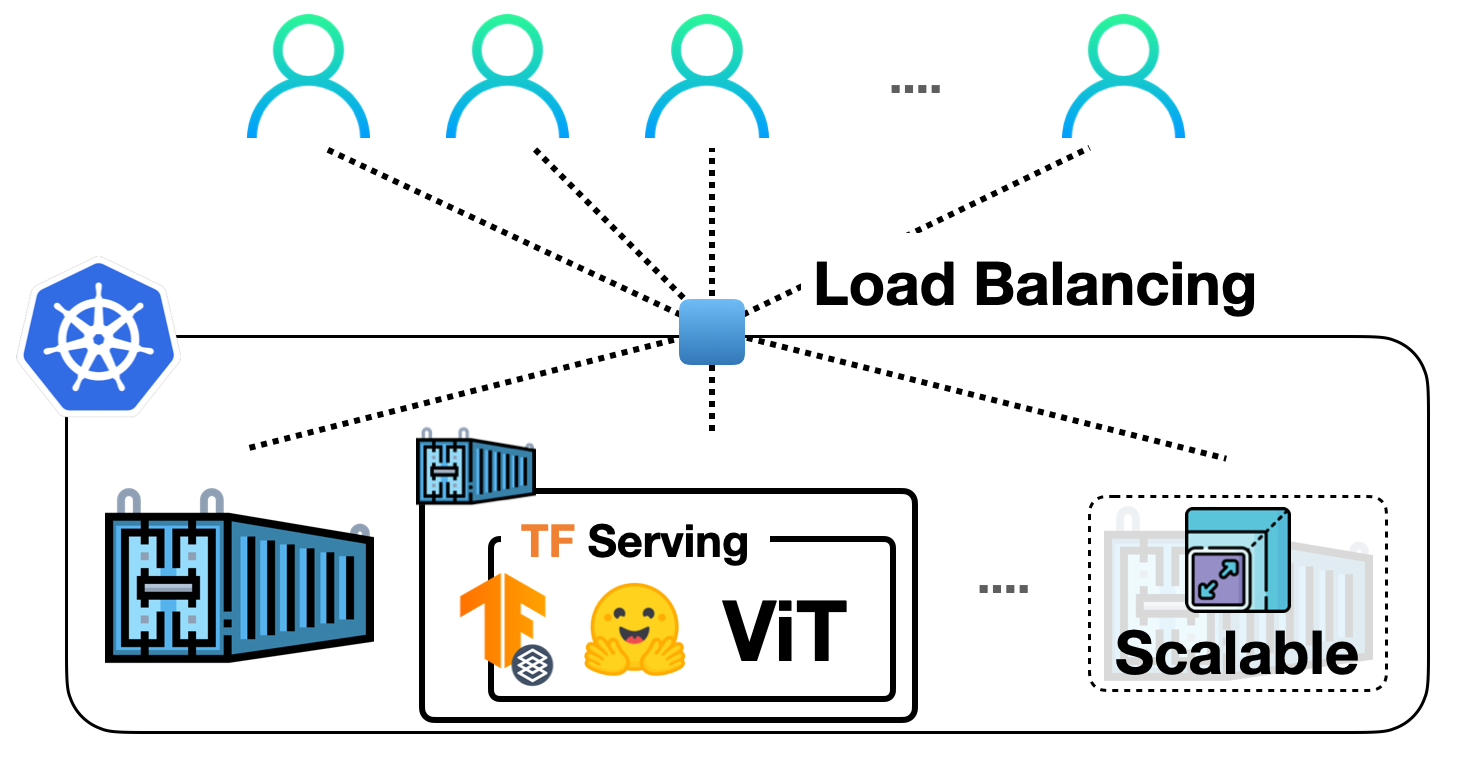
მიუხედავად იმისა, რომ ლოკალური დეპლოიმენტი შესანიშნავი საწყისი წერტილია რაიმე სასარგებლოს შესაქმნელად, რეალურ პროექტებში დაგჭირდებათ დეპლოიმენტები, რომლებსაც მრავალი მომხმარებლის მომსახურება შეუძლიათ. ამ პოსტში თქვენ შეისწავლით, თუ როგორ უნდა მოახდინოთ წინა პოსტის ლოკალური დეპლოიმენტის მასშტაბირება Docker-ისა და Kubernetes-ის გამოყენებით. შესაბამისად, ვივარაუდებთ, რომ გარკვეულწილად იცნობთ Docker-სა და Kubernetes-ს. ეს პოსტი ეყრდნობა წინა პოსტს, ამიტომ გირჩევთ, რომ ჯერ ის წაიკითხოთ. ამ პოსტში განხილული ყველა კოდი შეგიძლიათ იხილოთ ამ რეპოზიტორიუმში.
ჩვენი მსგავსი დეპლოიმენტის მასშტაბირების ძირითადი სამუშაო პროცესი მოიცავს შემდეგ ნაბიჯებს:
* აპლიკაციის ლოგიკის კონტეინერიზაცია: აპლიკაციის ლოგიკა მოიცავს განთავსებულ მოდელს, რომელსაც შეუძლია მოთხოვნების დამუშავება და პროგნოზების დაბრუნება. კონტეინერიზაციისთვის Docker არის ინდუსტრიული სტანდარტი.
* Docker კონტეინერის განთავსება: აქ მრავალი ვარიანტი გაქვთ. ყველაზე ფართოდ გამოყენებული ვარიანტია Docker კონტეინერის განთავსება Kubernetes კლასტერზე. Kubernetes გთავაზობთ დეპლოიმენტისთვის მრავალ ხელსაყრელ ფუნქციას (მაგ., ავტომატური მასშტაბირება და უსაფრთხოება). შეგიძლიათ გამოიყენოთ Minikube-ის მსგავსი გადაწყვეტილება Kubernetes კლასტერების ლოკალურად სამართავად ან სერვერლესის (serverless) გადაწყვეტილება, როგორიცაა Elastic Kubernetes Service (EKS).
შესაძლოა გაინტერესებთ, რატომ უნდა გამოვიყენოთ ასეთი აშკარა დაყენება Sagemaker-ისა და Vertex AI-ის ეპოქაში, რომლებიც ML დეპლოიმენტისთვის სპეციფიკურ ფუნქციებს გვთავაზობენ. ეს სამართლიანი კითხვაა. ზემოთ აღწერილი სამუშაო პროცესი ფართოდ არის მიღებული ინდუსტრიაში და მრავალი ორგანიზაცია სარგებლობს მისით. ის მრავალი წლის განმავლობაში უკვე გამოცდილია. ის ასევე გაძლევთ საშუალებას გქონდეთ თქვენი დეპლოიმენტების უფრო დეტალური კონტროლი, არატრივიალური ნაწილების აბსტრაქციის პარალელურად. ეს პოსტი იყენებს Google Kubernetes Engine-ს (GKE) Kubernetes კლასტერის უზრუნველსაყოფად და სამართავად. ვივარაუდებთ, რომ თქვენ უკვე გაქვთ ბილინგით ჩართული GCP პროექტი, თუ იყენებთ GKE-ს. ასევე გაითვალისწინეთ, რომ დაგჭირდებათ `gcloud` უტილიტის კონფიგურაცია GKE-ზე დეპლოიმენტის შესრულებლად. მაგრამ ამ პოსტში განხილული კონცეფციები თანაბრად გამოიყენება, თუ Minikube-ის გამოყენებას გადაწყვეტთ.
შენიშვნა: ამ პოსტში ნაჩვენები კოდის ფრაგმენტების შესრულება შესაძლებელია Unix ტერმინალზე, იმ პირობით, რომ კონფიგურირებული გაქვთ `gcloud` უტილიტა Docker-თან და `kubectl`-თან ერთად. დამატებითი ინსტრუქციები ხელმისაწვდომია თანდართულ რეპოზიტორიუმში.
მომსახურე მოდელს შეუძლია დაამუშაოს ნედლი გამოსახულების შეყვანა ბაიტების სახით და აქვს წინასწარი და შემდგომი დამუშავების შესაძლებლობა. ამ სექციაში ნახავთ, თუ როგორ უნდა მოახდინოთ ამ მოდელის კონტეინერიზაცია საბაზისო TensorFlow Serving Image-ის გამოყენებით. TensorFlow Serving მოდელებს მოიხმარს SavedModel ფორმატში. გაიხსენეთ, როგორ მოიპოვეთ ასეთი SavedModel წინა პოსტში. ვივარაუდებთ, რომ თქვენ გაქვთ SavedModel შეკუმშული `tar.gz` ფორმატში. საჭიროების შემთხვევაში, შეგიძლიათ მისი გადმოწერა აქედან. შემდეგ SavedModel უნდა განთავსდეს სპეციალურ დირექტორიის სტრუქტურაში `//`. ასე მართავს TensorFlow Serving ერთდროულად სხვადასხვა ვერსიის მოდელების მრავალ დეპლოიმენტს. ქვემოთ მოცემული shell სკრიპტი განათავსებს SavedModel-ს `hf-vit/1` დირექტორიაში, მშობელ `models` დირექტორიის ქვეშ. თქვენ გადააკოპირებთ ყველაფერს მის შიგნით Docker გამოსახულების მომზადებისას. ამ მაგალითში მხოლოდ ერთი მოდელია, მაგრამ ეს უფრო ზოგადი მიდგომაა. ქვემოთ, ნაჩვენებია, თუ როგორ არის structured `models` დირექტორია ჩვენს შემთხვევაში.
მორგებული TensorFlow Serving-ის გამოსახულება უნდა აიგოს საბაზისო გამოსახულების თავზე. ამის სხვადასხვა მიდგომა არსებობს, მაგრამ თქვენ ამას გააკეთებთ Docker კონტეინერის გაშვებით, როგორც ეს ოფიციალურ დოკუმენტშია ნაჩვენები. ჩვენ დავიწყებთ `tensorflow/serving` გამოსახულების გაშვებით ფონურ რეჟიმში, შემდეგ კი მთელი `models` დირექტორია კოპირდება გაშვებულ კონტეინერში, როგორც ეს ქვემოთაა მოცემული. ჩვენ გამოვიყენეთ TensorFlow Serving-ის ოფიციალური Docker გამოსახულება, როგორც საბაზისო, მაგრამ ასევე შეგიძლიათ გამოიყენოთ ისეთი გამოსახულებები, რომლებიც საწყისი კოდიდან გაქვთ აგებული.
შენიშვნა: TensorFlow Serving სარგებლობს აპარატურული ოპტიმიზაციებით, რომლებიც იყენებენ ინსტრუქციების ნაკრებებს, როგორიცაა AVX512. ეს ინსტრუქციების ნაკრებები აჩქარებს ღრმა სწავლის მოდელის დასკვნის (inference) პროცესს. ამიტომ, თუ იცით აპარატურა, რომელზეც მოდელი განთავსდება, ხშირად სასარგებლოა TensorFlow Serving-ის გამოსახულების ოპტიმიზებული ბილდის მოპოვება და მისი გამოყენება.
ახლა, როდესაც გაშვებულ კონტეინერს აქვს ყველა საჭირო ფაილი შესაბამის დირექტორიის სტრუქტურაში, ჩვენ უნდა შევქმნათ ახალი Docker გამოსახულება, რომელიც მოიცავს ამ ცვლილებებს. ეს შეიძლება გაკეთდეს ქვემოთ მოცემული `docker commit` ბრძანებით, რის შედეგადაც გექნებათ ახალი Docker გამოსახულება სახელად `$NEW_IMAGE`. მნიშვნელოვანია აღინიშნოს, რომ თქვენ უნდა დააყენოთ `MODEL_NAME` გარემოს ცვლადი მოდელის სახელზე, რომელიც ამ შემთხვევაში არის `hf-vit`. ეს აცნობებს TensorFlow Serving-ს, თუ რომელი მოდელი უნდა განთავსდეს.
დაბოლოს, შეგიძლიათ გაუშვათ ახლად აგებული Docker გამოსახულება ლოკალურად, რათა დარწმუნდეთ, რომ ის გამართულად მუშაობს. ქვემოთ ხედავთ `docker run` ბრძანების გამომავალს. ვინაიდან გამომავალი დეტალურია, ჩვენ ის შევკვეცეთ, რათა ყურადღება მიგვექცია მნიშვნელოვან ნაწილებზე. ასევე აღსანიშნავია, რომ ის ხსნის 8500 და 8501 პორტებს, შესაბამისად, gRPC და HTTP/REST ენდპოინტებისთვის.
ბოლო ნაბიჯი არის Docker გამოსახულების ატვირთვა გამოსახულების რეპოზიტორიუმში. ამ მიზნით გამოიყენებთ Google Container Registry-ს (GCR). შემდეგი კოდის სტრიქონებს შეუძლიათ ამის გაკეთება თქვენთვის: ვინაიდან ჩვენ ვიყენებთ GCR-ს, თქვენ უნდა დაურთოთ პრეფიქსი Docker-ს.
თეგები:
#cloud computing
#ml deployment
#docker
#kubernetes
#tensorflow serving
#gke
#containerization
#მასშტაბირება
წყარო: huggingface.co
AI-ით გადამუშავებული


