
კონტენტ-კრეატორების ეკონომიკა: როგორ სცილდებიან შემქმნელები სარეკლამო შემოსავლებს?
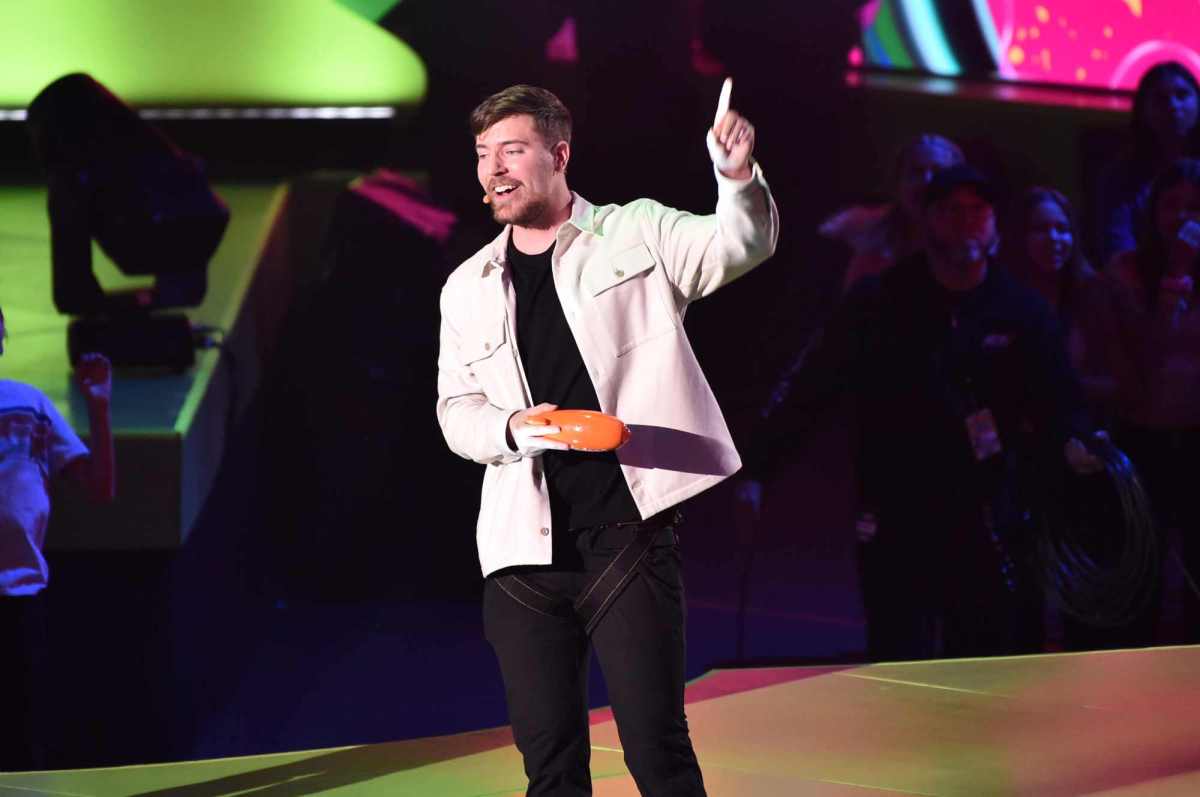
კონტენტ-კრეატორების ეკონომიკა სწრაფად ვითარდება, სადაც მხოლოდ სარეკლამო შემოსავალი აღარ არის საკმარისი. იუთუბერები პროდუქციის ხაზებს უშვებენ, სტარტაპებს ყიდულობენ და ბიზნეს იმპერიებს აშენებენ. TechCrunch-ის Equity პოდკასტის ამ ეპიზოდში, წამყვანები განიხილავენ, თუ როგორ ახდენენ შემქმნელები შემოსავლების დივერსიფიკაციას რეკლამის მიღმა, შეუძლია თუ არა ამ მოდელს ტოპ 1%-ის მიღმა მასშტაბირება, ინდოეთის AI Impact სამიტზე განვითარებულ მოვლენებს და კვირის სხვა მთავარ ამბებს.
შემოქმედთა ეკონომიკის ევოლუცია: რეკლამაზე მეტი შემოსავლის წყაროები და ბიზნეს იმპერიების მშენებლობა
შემოქმედთა ეკონომიკა სწრაფი ტემპით ვითარდება, რადგან მხოლოდ სარეკლამო შემოსავალი აღარ არის საკმარისი. იუთუბერები, როგორიცაა MrBeast, პროდუქციის ხაზებს უშვებენ, სტარტაპებს იძენენ და წარმატებულ ბიზნეს იმპერიებს აშენებენ. TechCrunch-ის პოდკასტ „Equity“-ის ახალი ეპიზოდი დეტალურად განიხილავს, თუ როგორ ახდენენ შემქმნელები შემოსავლების დივერსიფიკაციას სარეკლამო მოდელის მიღმა და რამდენად მასშტაბირებადია ეს მიდგომა ტოპ 1%-ის ფარგლებს გარეთ.

ილონ მასკი xAI-დან თანადამფუძნებლების მასობრივ წასვლას ეხმაურება
ილონ მასკი xAI-დან თანადამფუძნებლებისა და ინჟინრების მასობრივ წასვლას ეხმაურება, რის შედეგადაც კომპანია თავდაპირველი 12 თანადამფუძნებლიდან 6-მა დატოვა. მასკი მიანიშნებს, რომ მიზეზი კომპანიის მასშტაბირება და რეორგანიზაციაა, თუმცა წასვლები არანებაყოფლობითი იყო. ეს ხდება xAI-ის გარშემო არსებული არაერთი სკანდალის ფონზე, მათ შორის მარეგულირებელი შემოწმება deepfake-ების გამო, და მასკის პირადი დაპირისპირება ჯეფრი ეპშტეინთან. მიუხედავად იმისა, რომ კომპანია აგრესიულად ქირაობს ახალ კადრებს, თანადამფუძნებლ
fastText-ის მოდელები Hugging Face-ზე: 157 ენის ვექტორები და ენის იდენტიფიკაცია Meta AI-სთან თანამშრომლობით
Hugging Face-მა, Meta AI-სთან თანამშრომლობით, უზრუნველყო fastText-ის მოდელების, მათ შორის 157 ენის სიტყვის ვექტორებისა და ენის იდენტიფიკაციის უახლესი მოდელის, ხელმისაწვდომობა. ეს ინტეგრაცია მომხმარებლებს საშუალებას აძლევს, მარტივად ჩამოტვირთონ და გამოიყენონ ეს მასშტაბირებადი გადაწყვეტილებები ტექსტის წარმოდგენისა და კლასიფიკაციისთვის, ასევე გამოსცადონ სხვადასხვა ვიჯეტები.
100-ჯერ გაზრდილი წარმადობა: დიდი AI მოდელების ოპტიმიზაცია Hugging Face-ის ინფრასტრუქტურაზე
მიუხედავად იმისა, რომ დიდი ენობრივი მოდელების ექსპერიმენტირება მარტივია, მათი მაქსიმალური წარმადობით პროდუქციაში განთავსება რთული საინჟინრო გამოწვევაა. Hugging Face გთავაზობთ გადაწყვეტას თავისი Accelerated Inference API-ის მეშვეობით, რომელიც უზრუნველყოფს 100-ჯერ გაზრდილ სიჩქარეს და მასშტაბირებადობას. სტატია დეტალურად აღწერს ოპტიმიზაციის სხვადასხვა დონეს – ბიბლიოთეკების გამოყენებიდან აპარატურის სპეციფიკურ მოდიფიკაციამდე – და ხაზს უსვამს Hugging Face-ის ექსპერტიზასა და პარტნიორობებს ტექნიკის წამყვ
RAG მოდელების გაუმჯობესება: Ray-ის ინტეგრაცია სწრაფი განაწილებული დახვეწისთვის
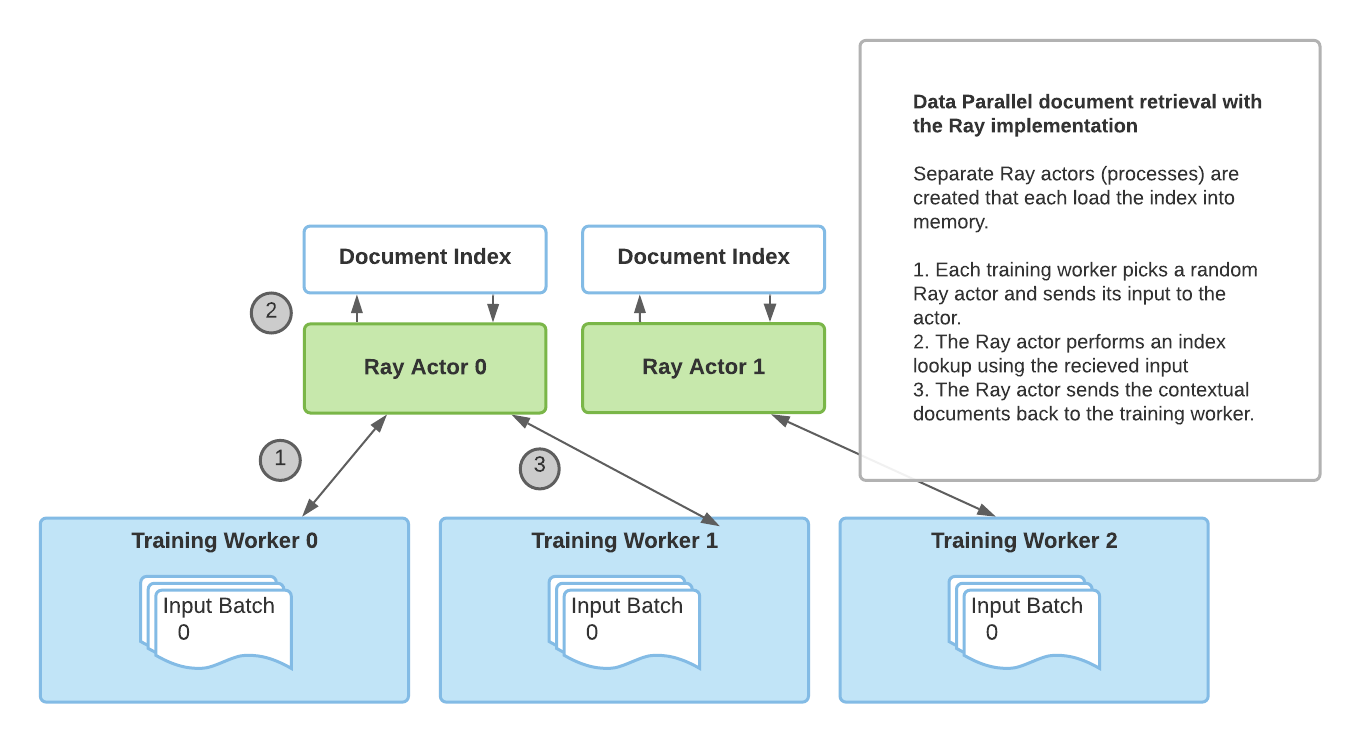
სტატია მიმოიხილავს RAG (Retrieval Augmented Generation) მოდელებს, რომლებიც კონტექსტურ დოკუმენტებს გარე წყაროებიდან იძიებენ შედეგების გენერაციისთვის. ის ხაზს უსვამს დოკუმენტების მოძიების პროცესის სირთულესა და მასშტაბირებადობის გამოწვევებს `torch.distributed` იმპლემენტაციის დროს. წარმოდგენილია Ray-ზე დაფუძნებული ახალი გადაწყვეტა, რომელიც მნიშვნელოვნად აუმჯობესებს მოძიების სიჩქარესა და RAG მოდელების დახვეწის მასშტაბირებადობას Huggingface Transformers ბიბლიოთეკაში. აღწერილია Ray-ის გამოყენების უპირა
RAG მოდელების გაძლიერება Ray-ის საშუალებით: განაწილებული ინფორმაციის მოძიების სიჩქარის გაორმაგება
სტატია განიხილავს RAG (Retrieval Augmented Generation) მოდელების მუშაობის პრინციპებს, რომლებიც კონტექსტური დოკუმენტების მოძიებით აუმჯობესებენ გენერაციის ხარისხს. წარმოდგენილია წინა იმპლემენტაციის (torch.distributed) შეზღუდვები და შემოთავაზებულია ახალი, გაუმჯობესებული მიდგომა Ray ბიბლიოთეკის გამოყენებით. Ray-ზე დაფუძნებული განაწილებული მოძიების იმპლემენტაცია არა მხოლოდ 2-ჯერ ზრდის მოძიების სიჩქარეს, არამედ აუმჯობესებს მოდელების დაზუსტებული კონფიგურაციის (fine-tuning) მასშტაბირებადობას და ხსნის Py
Hugging Face Hub: მონაცემთა გადაცემის და შენახვის ოპტიმიზაცია დედუპლიკაციის ახალი მიდგომებით
Hugging Face Hub-ზე ხელოვნური ინტელექტის მოდელებისა და მონაცემთა ნაკრებების სწრაფი ზრდა მოითხოვს ეფექტურ მონაცემთა მართვას. სტატია აღწერს, თუ როგორ უმკლავდება Xet გუნდი გამოწვევებს, რომლებიც დაკავშირებულია დედუპლიკაციასთან, ტრადიციული მიდგომების შეზღუდვებთან და მასშტაბირებადობასთან. ნაცვლად იმისა, რომ ფოკუსირება მხოლოდ მცირე ბლოკების დედუპლიკაციაზე მოხდეს, რაც ინფრასტრუქტურას გადატვირთავს, Xet გუნდმა შეიმუშავა ინოვაციური, ბლოკებზე დაფუძნებული მიდგომა Rust-ში დაწერილი xet-core და hf_xet ინტეგრაცი
Amazon SageMaker ამარტივებს Hugging Face Transformers-ის დეპლოირებას ახალი Inference DLC-ებითა და ხელსაწყოებით
Amazon SageMaker-მა გამოუშვა Hugging Face Inference DLC-ები და ახალი Inference Toolkit, რაც მნიშვნელოვნად ამარტივებს Hugging Face Transformers მოდელების დეპლოირებას. ეს სიახლე საშუალებას აძლევს მომხმარებლებს, მარტივად განათავსონ როგორც საკუთარი გაწვრთნილი მოდელები, ისე Hugging Face Model Hub-დან 10,000-ზე მეტი საჯაროდ ხელმისაწვდომი მოდელი, სულ ერთი დამატებითი კოდის ხაზით. SageMaker უზრუნველყოფს საპროდუქციო გარემოსთვის მზა ენდპოინტებს ჩაშენებული მონიტორინგითა და მასშტაბირებადი შესაძლებლობებით.

Embedding მოდელების ოპტიმალური განთავსება Hugging Face Inference Endpoints-ზე: მაღალი წარმადობა და ხარჯთეფექტურობა
ამ სტატიაში განხილულია, თუ როგორ განვათავსოთ ღია კოდის Embedding მოდელები Hugging Face Inference Endpoints-ზე Text Embedding Inference (TEI) გადაწყვეტის გამოყენებით. ხაზგასმულია Embedding მოდელების უპირატესობა დიდი ენობრივი მოდელების (LLM-ების) მიმართ ზომისა და ინფერენსის სიჩქარის კუთხით. სტატია დეტალურად აღწერს Inference Endpoints-ის მახასიათებლებს, როგორიცაა ავტომატური მასშტაბირება და ნულამდე მასშტაბირება, და წარმოადგენს TEI-ს, როგორც მაღალი წარმადობისა და ხარჯთეფექტურობის გარანტს. ნაჩვენებია,
Renumics Spotlight: ინტერაქტიული ვიზუალიზაცია და მონაცემთა ინსპექცია Hugging Face-ის მონაცემთა ნაკრებებისთვის
Renumics Spotlight გთავაზობთ ინტერაქტიულ ვიზუალიზაციებს Hugging Face-ის მონაცემთა ნაკრებებში კრიტიკული კლასტერების იდენტიფიცირებისთვის. ის იყენებს მოდელის შედეგებს (პროგნოზები, ემბედინგები) მონაცემთა სეგმენტებისა და მოდელის შეცდომების ღრმა გაგებისთვის, რაც აადვილებს მონაცემთა ინსპექციას და ხდის მას მასშტაბირებადს. ხელსაწყო პირდაპირ ინტეგრირდება `datasets` ბიბლიოთეკასთან და მხარს უჭერს სხვადასხვა ტიპის მონაცემებსა და ML ამოცანებს, მათ შორის NLP, აუდიო და კომპიუტერული ხედვა.

TRL და vLLM-ის კოლოკაცია: ხელოვნური ინტელექტის მოდელების წვრთნის რევოლუცია GPU-ების ოპტიმიზაციით
ტრადიციულად, დიდი ენობრივი მოდელების (LLM) GRPO ალგორითმით წვრთნა, vLLM-ის სერვერის რეჟიმში გამოყენებისას, გრაფიკული პროცესორების (GPU) არაეფექტურ გამოყენებას იწვევდა. TRL-ის v0.18.0 ვერსიიდან, vLLM-თან ერთობლივი მუშაობის (კოლოკაციის) მხარდაჭერა საშუალებას იძლევა, წვრთნა და ინფერენცია ერთსა და იმავე GPU-ებზე განხორციელდეს. ეს მიდგომა მნიშვნელოვნად ამცირებს უქმ დროს, აუმჯობესებს გამტარუნარიანობას და ამარტივებს განლაგებას, რაც LLM-ების წვრთნას უფრო სწრაფს, ეკონომიურს და მასშტაბირებადს ხდის.
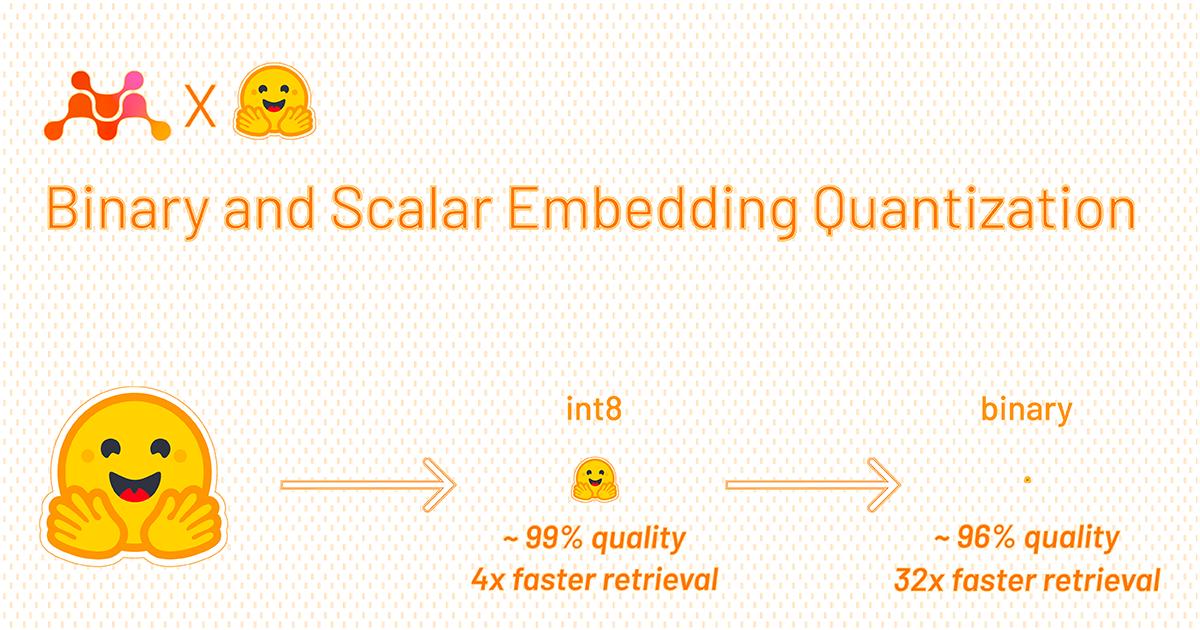
კვანტიზაცია: ეფექტური გადაწყვეტა ემბედინგების მასშტაბირების პრობლემისთვის
ემბედინგები ბუნებრივი ენის დამუშავების (NLP) გადამწყვეტი ინსტრუმენტია, თუმცა მათი მასშტაბირება წარმოების მიზნებისთვის ხშირად იწვევს მაღალ ხარჯებსა და ლატენტურობას. სტატია განიხილავს ამ გამოწვევებს, არსებულ მიდგომებს (როგორიცაა განზომილების შემცირება და Matryoshka Representation Learning) და წარმოგიდგენთ კვანტიზაციას, კერძოდ ბინარულ კვანტიზაციას, როგორც ინოვაციურ გადაწყვეტას. ბინარული კვანტიზაცია float32 მნიშვნელობებს 1-ბიტიან მნიშვნელობებად აქცევს, რაც მეხსიერებასა და შენახვის ადგილს 32-ჯერ ამცი
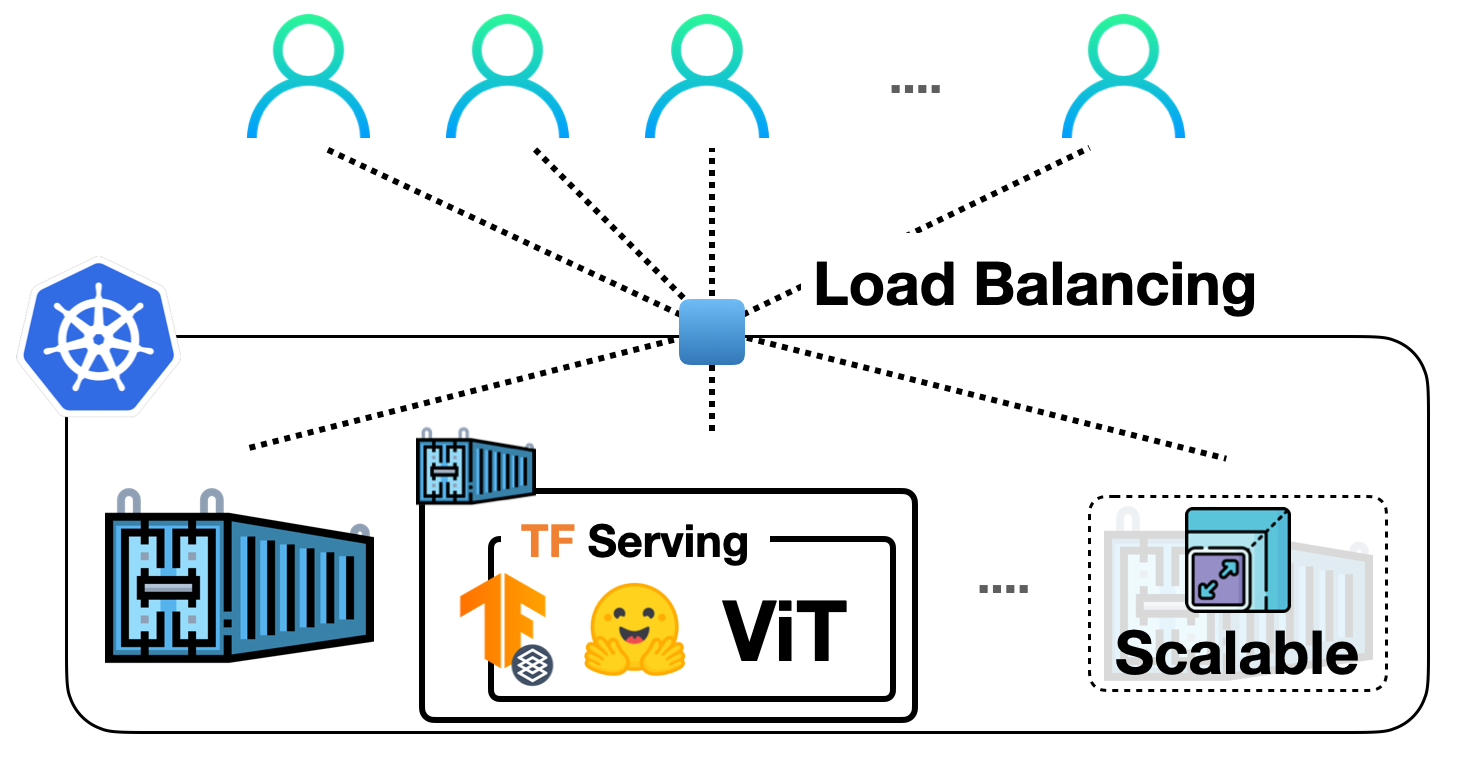
ML მოდელების მასშტაბირება Docker-ით და Kubernetes-ით: ლოკალურიდან სრულმასშტაბიან დეპლოიმენტამდე
ეს პოსტი გაწვდით დეტალურ სახელმძღვანელოს, თუ როგორ გადახვიდეთ მანქანური სწავლების მოდელების ლოკალური განთავსებიდან მასშტაბირებად, რეალურ პროექტებში გამოსაყენებელ სისტემებზე Docker-ისა და Kubernetes-ის გამოყენებით. სტატია აღწერს აპლიკაციის ლოგიკის კონტეინერიზაციას, Docker-ის კონტეინერების განთავსებას Kubernetes კლასტერზე (კერძოდ Google Kubernetes Engine-ზე - GKE), TensorFlow Serving-ის გამოყენებას მოდელების მომსახურებისთვის, მორგებული Docker გამოსახულებების შექმნას და მათ Google Container Registr

Meta-PyTorch და Hugging Face OpenEnv Hub-ს წარადგენენ: ახალი ერა აგენტურ AI-ში
Meta-PyTorch-ისა და Hugging Face-ის პარტნიორობით, დაიწყო OpenEnv Hub-ის პროექტი, რომელიც მიზნად ისახავს აგენტური ხელოვნური ინტელექტის (AI) განვითარების სტანდარტიზებასა და დაჩქარებას. OpenEnv Hub არის საერთო სივრცე დეველოპერებისთვის, სადაც მათ შეუძლიათ შექმნან, გააზიარონ და გამოიკვლიონ OpenEnv-თან თავსებადი გარემოები AI აგენტების წვრთნისა და განლაგებისთვის. ეს ინიციატივა მნიშვნელოვნად გაამარტივებს AI აგენტების უსაფრთხო, მკაფიო და მასშტაბირებად განვითარებას, აწვდის მათ საჭირო ხელსაწყოებსა და კონტე

ვაიბ-კოდინგი: სწრაფი ჰაკები თუ პროგრამირების მომავალი? რატომ რჩებიან ნამდვილი ინჟინრები შეუცვლელნი
ვაიბ-კოდინგი, ხელოვნური ინტელექტის მეშვეობით ბუნებრივი ენით კოდის გენერირების ტენდენცია, აღიარებულია სისწრაფისა და ხელმისაწვდომობის გამო, რაც არაპროგრამისტებსაც კი აძლევს აპლიკაციების შექმნის საშუალებას. თუმცა, კრიტიკოსები ამტკიცებენ, რომ ის ხშირად წარმოქმნის "გაისროლე და დაივიწყე" ტიპის კოდს, რომლის შენარჩუნებაც რთულია. სტატია ხაზს უსვამს ტრადიციული პროგრამული ინჟინერიის უნარების გადამწყვეტ მნიშვნელობას გამძლე და მასშტაბირებადი პროგრამული გადაწყვეტილებების შესაქმნელად.