RAG მოდელების გაუმჯობესება: Ray-ის ინტეგრაცია სწრაფი განაწილებული დახვეწისთვის
სტატია მიმოიხილავს RAG (Retrieval Augmented Generation) მოდელებს, რომლებიც კონტექსტურ დოკუმენტებს გარე წყაროებიდან იძიებენ შედეგების გენერაციისთვის. ის ხაზს უსვამს დოკუმენტების მოძიების პროცესის სირთულესა და მასშტაბირებადობის გამოწვევებს `torch.distributed` იმპლემენტაციის დროს. წარმოდგენილია Ray-ზე დაფუძნებული ახალი გადაწყვეტა, რომელიც მნიშვნელოვნად აუმჯობესებს მოძიების სიჩქარესა და RAG მოდელების დახვეწის მასშტაბირებადობას Huggingface Transformers ბიბლიოთეკაში. აღწერილია Ray-ის გამოყენების უპირა
RAG-ის მიმოხილვა. მოდელი თავისი მუშაობის პროცესში იღებს კონტექსტურ დოკუმენტებს გარე მონაცემთა ნაკრებიდან. ეს კონტექსტური დოკუმენტები გამოიყენება საწყის ინფორმაციასთან ერთად, რათა წარმოქმნას გამოსავალი. ცოტა ხნის წინ, Huggingface-მა Facebook AI-სთან თანამშრომლობით RAG მოდელი თავისი Transformers ბიბლიოთეკის ნაწილად წარადგინა. RAG მუშაობს ისევე, როგორც ნებისმიერი სხვა seq2seq მოდელი. თუმცა, RAG-ს აქვს შუალედური კომპონენტი, რომელიც იღებს კონტექსტურ დოკუმენტებს გარე ცოდნის ბაზიდან (მაგალითად, ვიკიპედიის ტექსტური კორპუსი). შემდეგ ეს დოკუმენტები გამოიყენება შეყვანის თანმიმდევრობასთან ერთად და გადაეცემა საბაზისო seq2seq გენერატორს. ინფორმაციის მოძიების ეს ნაბიჯი RAG-ს საშუალებას აძლევს გამოიყენოს ცოდნის მრავალი წყარო – როგორც მოდელის პარამეტრებში ჩაშენებული, ასევე კონტექსტურ პასაჟებში მოცემული ინფორმაცია, რაც მას საშუალებას აძლევს, აჯობოს სხვა უახლესი მოდელებს ისეთ ამოცანებში, როგორიცაა კითხვა-პასუხი. მისი გამოცდა თავად შეგიძლიათ Huggingface-ის მიერ მოწოდებული ამ დემო ვერსიის გამოყენებით!
კონტექსტური დოკუმენტების ეს მოძიება გადამწყვეტია RAG-ის უახლესი შედეგებისთვის, მაგრამ დამატებით სირთულეს ქმნის. ტრენინგის პროცესის მასშტაბირებისას მონაცემთა-პარალელური ტრენინგის რუტინის გამოყენებით, დოკუმენტების ძიების მარტივმა იმპლემენტაციამ შეიძლება გამოიწვიოს ტრენინგის შეფერხება (bottleneck). გარდა ამისა, მოძიების კომპონენტში გამოყენებული დოკუმენტების ინდექსი ხშირად საკმაოდ დიდია, რაც შეუძლებელს ხდის თითოეული ტრენინგის მუშაკისთვის (worker) ინდექსის საკუთარი რეპლიკაციური ასლის ჩატვირთვას. RAG-ის წინა დახვეწის (fine-tuning) იმპლემენტაცია იყენებდა `torch.distributed` საკომუნიკაციო პაკეტს დოკუმენტების მოძიების ნაწილისთვის. თუმცა, ეს იმპლემენტაცია ზოგჯერ მოუქნელი და მასშტაბირებადობის თვალსაზრისით შეზღუდული აღმოჩნდა. ამის ნაცვლად, საჭირო გახდა ფრეიმვორკისგან დამოუკიდებელი და უფრო მოქნილი იმპლემენტაცია ad-hoc კონკურენტული პროგრამირებისთვის. Ray ამ მოთხოვნებს იდეალურად აკმაყოფილებს. Ray არის მარტივი, მაგრამ მძლავრი Python ბიბლიოთეკა ზოგადი დანიშნულების განაწილებული და პარალელური პროგრამირებისთვის. Ray-ის გამოყენებით განაწილებული დოკუმენტების მოძიებისთვის, ჩვენ მივაღწიეთ 2-ჯერ სიჩქარის გაზრდას თითოეულ მოძიების გამოძახებაზე `torch.distributed`-თან შედარებით, და მთლიანობაში უკეთეს დახვეწის მასშტაბირებადობას.
დოკუმენტების მოძიება `torch.distributed` იმპლემენტაციით. `torch.distributed` იმპლემენტაციის მთავარი ნაკლი დოკუმენტების მოძიებისთვის ის იყო, რომ ის ეკვროდა ტრენინგისთვის გამოყენებულ იმავე პროცესთა ჯგუფს და მხოლოდ rank 0 ტრენინგის მუშაკი ტვირთავდა ინდექსს მეხსიერებაში. შედეგად, ამ იმპლემენტაციას ჰქონდა გარკვეული შეზღუდვები:
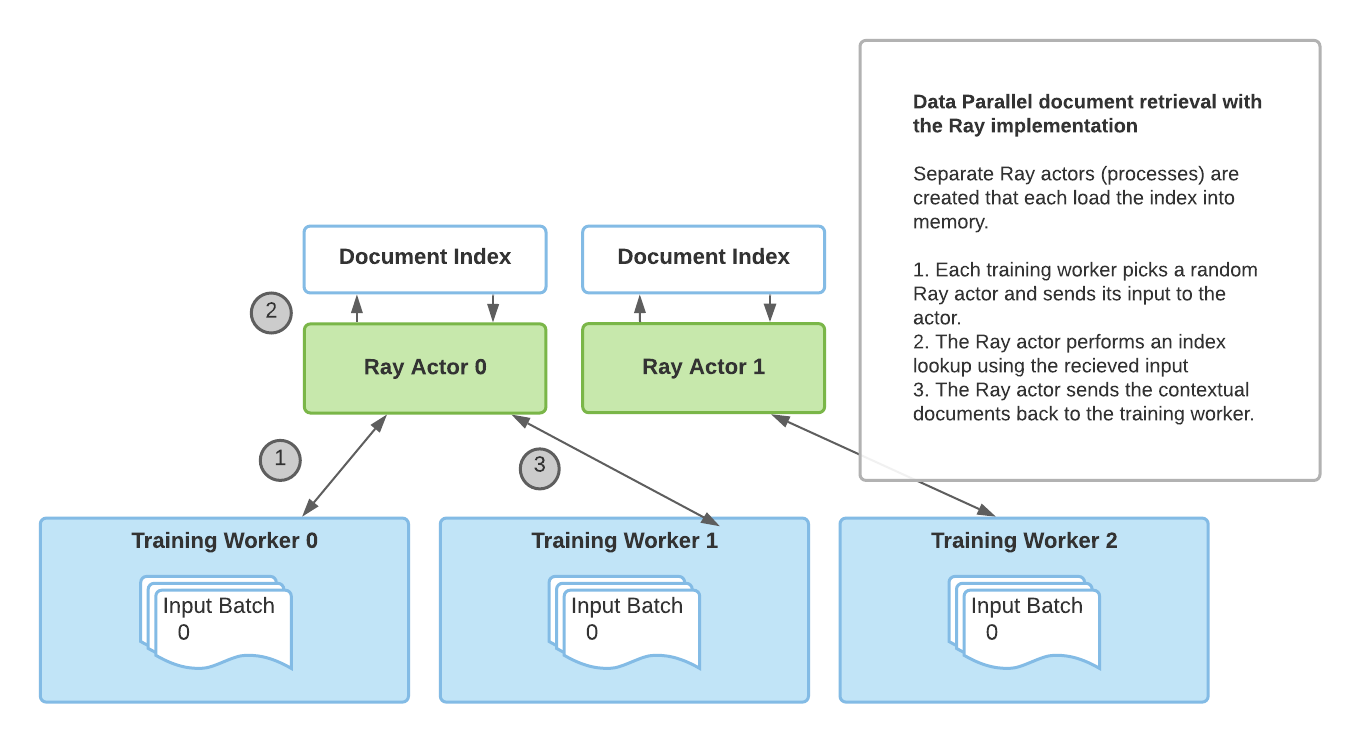
დოკუმენტების მოძიება Ray იმპლემენტაციით. ამ შეზღუდვების დასაძლევად, ჩვენ წარვადგინეთ განაწილებული მოძიების ახალი იმპლემენტაცია Ray-ზე დაყრდნობით. Ray-ის მდგომარეობრივი აქტორული აბსტრაქციების მეშვეობით, მრავალი პროცესი, რომლებიც გამოყოფილია ტრენინგის პროცესებისგან, გამოიყენება ინდექსის ჩასატვირთად და მოძიების მოთხოვნების დასამუშავებლად. მრავალი Ray აქტორის საშუალებით, მოძიება აღარ წარმოადგენს შეფერხებას (bottleneck) და PyTorch აღარ არის სავალდებულო RAG-ისთვის. და როგორც ქვემოთ ხედავთ, Ray-ზე დაფუძნებული იმპლემენტაციის გამოყენება იწვევს უკეთეს მოძიების შესრულებას მრავალ-GPU დახვეწისთვის. შემდეგი შედეგები აჩვენებს წამებს თითოეულ მოძიების გამოძახებაზე და ჩვენ ვხედავთ, რომ რაც უფრო მეტ GPU-ს ვიყენებთ ტრენინგისთვის, Ray-ის გამოყენებას შედარებით უკეთესი შესრულება აქვს `torch.distributed`-თან შედარებით. ასევე, თუ გავზრდით Ray პროცესების რაოდენობას, რომლებიც ასრულებენ მოძიებას, უკეთეს შესრულებას მივიღებთ მეტი ტრენინგის მუშაკის (worker) შემთხვევაშიც, რადგან ერთი მოძიების პროცესი აღარ არის შეფერხება. სხვადასხვა მოძიების იმპლემენტაციის შესრულების შედარება. თითოეული დოკუმენტის მოძიების იმპლემენტაციისთვის, ჩვენ ვასრულებთ 500 ტრენინგის ნაბიჯს, თითოეულ GPU-ზე 8 ზომის პაკეტით (batch size), და ვზომავთ დროს, რაც საჭიროა კონტექსტური დოკუმენტების მოსაძიებლად თითოეული პაკეტისთვის rank 0 ტრენინგის მუშაკზე. როგორც შედეგები აჩვენებს, მრავალი მოძიების პროცესის გამოყენება აუმჯობესებს შესრულებას, განსაკუთრებით მაშინ, როდესაც ტრენინგს ვასკალირებთ მრავალ GPU-ზე. Huggingface გთავაზობთ PyTorch Lightning-ზე დაფუძნებულ დახვეწის სკრიპტს, და ჩვენ გავაფართოვეთ ის, რომ დავამატეთ Ray მოძიების იმპლემენტაცია, როგორც ერთ-ერთი ვარიანტი. მის გამოსაცდელად, ჯერ დააინსტალირეთ საჭირო მოთხოვნები. შემდეგ შეგიძლიათ მიუთითოთ თქვენი მონაცემთა გზები და სხვა კონფიგურაციები და გაუშვათ `finetune-rag-ray.sh`! RAG-ის გამოყენებით Huggingface transformers-თან და Ray მოძიების იმპლემენტაციასთან ერთად, სწრაფი განაწილებული დახვეწისთვის, შეგიძლიათ RAG გამოიყენოთ მოძიებაზე დაფუძნებული გენერაციისთვის თქვენს ცოდნის ინტენსიურ ამოცანებში. ასევე, ჰიპერპარამეტრების დარეგულირება (tuning) ტრანსფორმატორის დახვეწის კიდევ ერთი ასპექტია და მას შეუძლია დიდი გავლენა მოახდინოს სიზუსტეზე. მასშტაბირებადი და მარტივი ჰიპერპარამეტრების დარეგულირებისთვის, გაეცანით Ray Tune ბიბლიოთეკას. Ray Tune-ის PyTorch Lightning-თან ინტეგრაციის ან Huggingface transformers-თან ჩაშენებული ინტეგრაციის გამოყენებით, შეგიძლიათ ჩაატაროთ ექსპერიმენტები თქვენი RAG მოდელისთვის იდეალური ჰიპერპარამეტრების მოსაძებნად. და ბოლოს, თვალყური ადევნეთ Huggingface-ზე RAG-ის პოტენციურ Tensorflow იმპლემენტაციას! თუ გეგმავთ RAG+Ray ინტეგრაციის გამოცდას, თავისუფლად გაგვიზიარეთ თქვენი გამოცდილება Ray Discourse-ზე ან შემოუერთდით Ray საზოგადოების Slack-ს შემდგომი განხილვისთვის – ჩვენ სიამოვნებით მოვისმენთ თქვენგან!
თეგები:
#ხელოვნური ინტელექტი
#მანქანური სწავლება
#pytorch
#nlp
#ტრანსფორმატორები
#rag
#huggingface
#fine-tuning
#ray
#განაწილებული გამოთვლა
#კითხვა-პასუხი
წყარო: huggingface.co
AI-ით გადამუშავებული
მსგავსი სტატიები

ხელოვნური ინტელექტი
Anthropic-ის Claude-ის აღზევება Apple App Store-ის რეიტინგებში პენტაგონთან მოლაპარაკებების ფონზე

ხელოვნური ინტელექტი
ტრამპის ადმინისტრაცია Anthropic-ს სანქციებს უწესებს ხელოვნური ინტელექტის გამოყენებაზე უარის გამო: ექსპერტი ინდუსტრიის უსაფრთხოების ხარვეზებზე საუბრობს
ხელოვნური ინტელექტი