Stable Diffusion-ის დახვეწა Intel Sapphire Rapids CPU-ებზე: ახალი შესაძლებლობები ღრმა სწავლისთვის
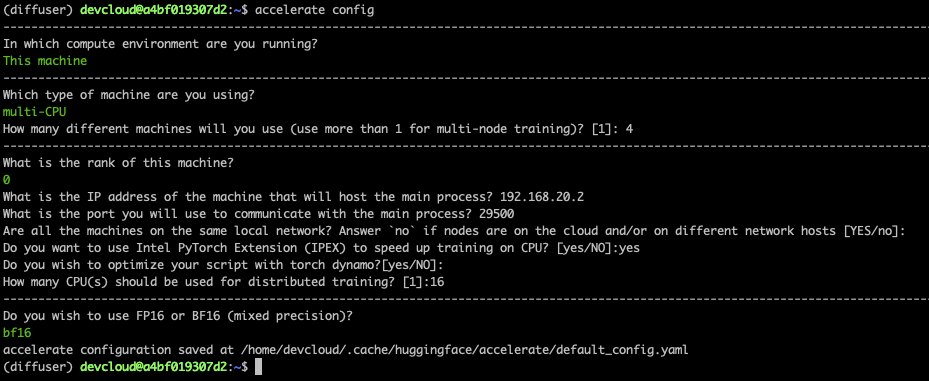
Intel-მა წარმოადგინა Xeon CPU-ების მეოთხე თაობა, Sapphire Rapids, რომელიც მოიცავს Intel Advanced Matrix Extensions (AMX) აჩქარებელს ღრმა სწავლისთვის. ეს სტატია დეტალურად აღწერს, თუ როგორ შეიძლება Stable Diffusion მოდელების დახვეწა (fine-tuning) Intel Sapphire Rapids CPU კლასტერზე, ტექსტური ინვერსიის გამოყენებით. პროცესი მოიცავს სისტემის დაყენებას Intel Developer Cloud-ზე, პროგრამული დამოკიდებულებების კონფიგურაციას (მათ შორის Intel-ის ბიბლიოთეკები oneCCL და IPEX) და განაწილებულ სწავლებას მინიმალუ
დიდი ენობრივი მოდელები: ღია წყაროების რევოლუცია ტექსტის გენერაციაში
სტატია მიმოიხილავს ტექსტის გენერაციისა და კონვერსაციული AI ტექნოლოგიების განვითარებას, ადრეული გამოწვევებიდან უახლეს მიღწევებამდე. ხაზგასმულია მომხმარებლისთვის მოსახერხებელი ინტერფეისების, GPT-4-ის მსგავსი მძლავრი მოდელების და Llama 2-ის მსგავსი ღია წყაროების ალტერნატივების მნიშვნელობა. განმარტებულია მიზეზობრივი ენობრივი მოდელები (Causal Language Models) და Text-to-Text მოდელები, ასევე Fine-tuning-ისა და RLHF-ის როლი მათ გაუმჯობესებაში. აღწერილია წამყვანი ღია წყაროების LLM-ები, მათი უპირატესობებ
RAG მოდელების გაძლიერება Ray-ის საშუალებით: განაწილებული ინფორმაციის მოძიების სიჩქარის გაორმაგება
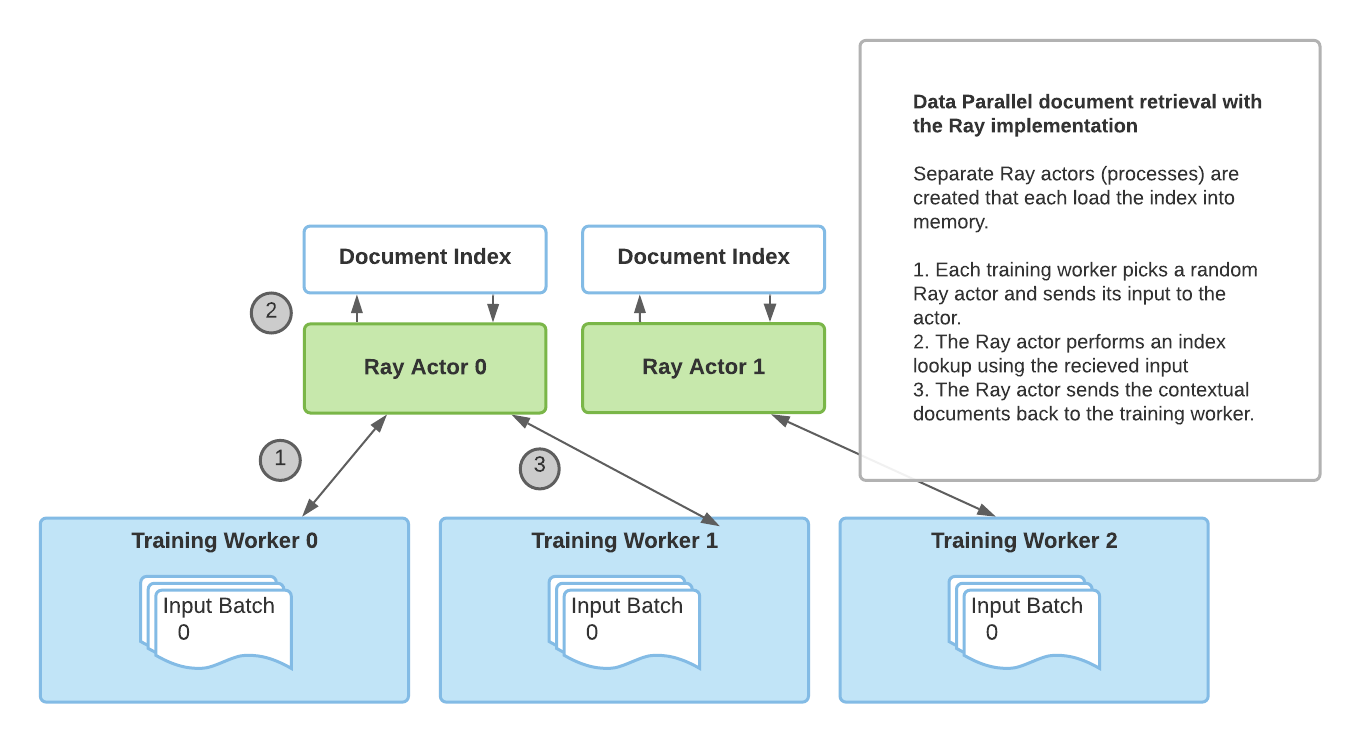
სტატია განიხილავს RAG (Retrieval Augmented Generation) მოდელების მუშაობის პრინციპებს, რომლებიც კონტექსტური დოკუმენტების მოძიებით აუმჯობესებენ გენერაციის ხარისხს. წარმოდგენილია წინა იმპლემენტაციის (torch.distributed) შეზღუდვები და შემოთავაზებულია ახალი, გაუმჯობესებული მიდგომა Ray ბიბლიოთეკის გამოყენებით. Ray-ზე დაფუძნებული განაწილებული მოძიების იმპლემენტაცია არა მხოლოდ 2-ჯერ ზრდის მოძიების სიჩქარეს, არამედ აუმჯობესებს მოდელების დაზუსტებული კონფიგურაციის (fine-tuning) მასშტაბირებადობას და ხსნის Py
Wav2Vec2: გარღვევა მეტყველების ამოცნობაში მინიმალური მარკირებული მონაცემებით
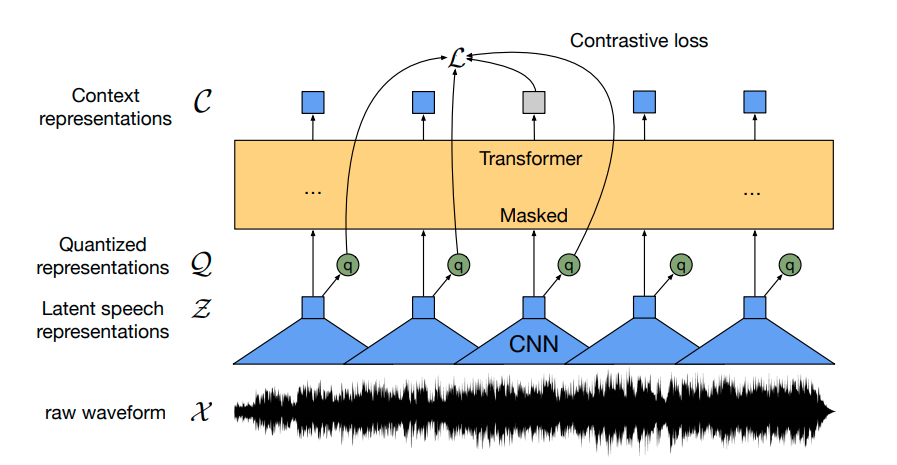
Wav2Vec2, რევოლუციური ხელოვნური ინტელექტის მოდელი, სწავლობს მეტყველების მძლავრ წარმოდგენებს დიდი მოცულობის არამარკირებული აუდიო მონაცემებიდან, კონტრასტული წინასწარი ვარჯიშის ინოვაციური მეთოდის გამოყენებით. მან აჩვენა უპრეცედენტო შედეგები ავტომატური მეტყველების ამოცნობის (ASR) სფეროში, მიაღწია უმაღლეს დონეს მაშინაც კი, როდესაც დამატებითი ვარჯიში (fine-tuning) ხდება სულ რაღაც 10 წუთის მარკირებულ მეტყველების მონაცემებზე. ეს მას ქმნის მაღალეფექტურ გადაწყვეტილებად ძლიერი ASR სისტემების შესაქმნელად, რ

„Few-Shot“ სწავლება: GPT-Neo, ბუნებრივი ენის დამუშავება და ეთიკური გამოწვევები
„Few-Shot“ სწავლება მანქანური სწავლების მოდელებს საშუალებას აძლევს, პროგნოზები გააკეთონ ძალიან მცირე რაოდენობის სავარჯიშო მონაცემების გამოყენებით, ტრადიციული „fine-tuning“ მეთოდებისგან განსხვავებით. ის, ძირითადად, კომპიუტერულ მხედველობაში გამოიყენებოდა, თუმცა ახლა უკვე ეფექტურია ბუნებრივი ენის დამუშავებაში (ბედ) დიდ ენობრივ მოდელებთან (მაგ. GPT-Neo), რაც მათ საშუალებას აძლევს, განაზოგადონ ახალი ამოცანები სულ რამდენიმე მაგალითით. თუმცა, ეფექტური „few-shot“ მაგალითების შექმნა და ჰიპერპარამეტრების
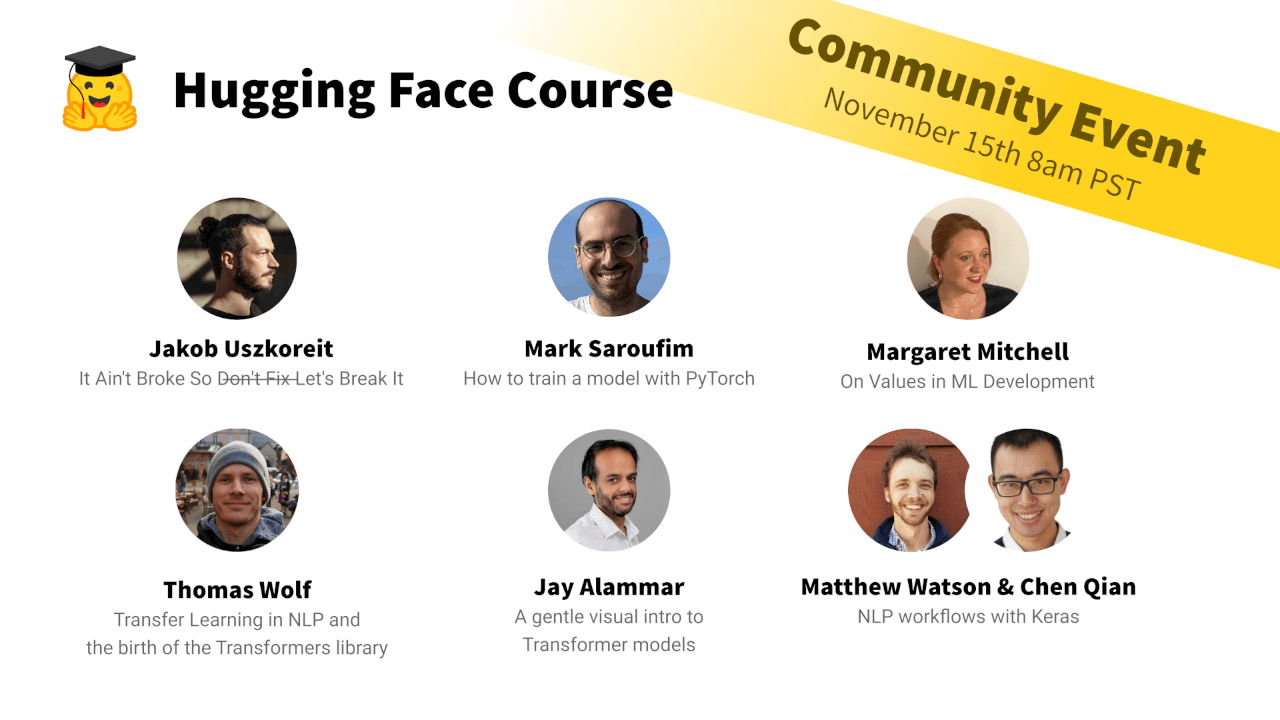
გეპატიჟებით ხელოვნური ინტელექტის საზოგადოებრივ ღონისძიებაზე: წამყვანი ექსპერტების მოხსენებები და პრაქტიკული პროექტები
ამ მასშტაბურ ღონისძიებაზე მონაწილეებს შესაძლებლობა ექნებათ მოუსმინონ ხელოვნური ინტელექტისა და ბუნებრივი ენის დამუშავების (NLP) სფეროს წამყვან ექსპერტებს, მათ შორის HuggingFace-ის თანადამფუძნებელ თომას ვოლფს და ეთიკური AI-ის მკვლევარ მარგარეტ მიტჩელს. ორდღიანი მოხსენებების შემდეგ გაიმართება გუნდური პროექტები მოდელების „დაფაინთუნებაზე“ (fine-tuning), რომელიც დასრულდება ცოცხალი დემონსტრაციებით. AWS აფინანსებს ღონისძიებას Amazon SageMaker-ის მეშვეობით უფასო გამოთვლითი რესურსებით, ხოლო წარმატებული მო
NLP მოდელების შედარებითი ანალიზი: RoBERTa, Mistral-7b და Llama-2-7b LoRA-ს გამოყენებით კატასტროფის ტვიტების კლასიფიკაციისთვის
ბუნებრივი ენის დამუშავების (NLP) სწრაფად განვითარებად სამყაროში, ენობრივი მოდელების შედარება გადამწყვეტია მათი ოპტიმალური გამოყენებისთვის კონკრეტულ ამოცანებში. ეს პოსტი ეძღვნება სამი მოდელის – RoBERTa, Mistral-7b და Llama-2-7b – შედარებას კატასტროფების შესახებ ტვიტების კლასიფიკაციის პრობლემაში. კვლევაში გამოყენებულია PEFT (Parameter-Efficient Fine-Tuning) ტექნიკის LoRA (Low-Rank Adaptation) მეთოდი, რომელიც მნიშვნელოვნად ამცირებს პარამეტრების რაოდენობას მოდელის წვრილად მორგებისას. განხილულია თითო

დიფუზიური მოდელების ეფექტური წვრილი დარეგულირება QLoRA-ით: 10 GB VRAM-ზე ნაკლები მოხმარება
წინა პოსტში კვანტიზაციის ტექნიკების განხილვის შემდეგ, ეს პოსტი ყურადღებას ამახვილებს დიფუზიური მოდელების, კერძოდ FLUX.1-dev-ის, ეფექტურ წვრილ დარეგულირებაზე (fine-tuning) QLoRA მეთოდის გამოყენებით. მიზანია, მივაღწიოთ 10 GB-ზე ნაკლებ VRAM მოხმარებას ერთ GPU-ზე, რაც ხელმისაწვდომს გახდის ამ პროცესს სამომხმარებლო აპარატურაზე. განიხილება ისეთი ტექნიკები, როგორიცაა 8-ბიტიანი AdamW ოპტიმიზატორი, გრადიენტის შემოწმება (gradient checkpointing) და ლატენტების ქეშირება (cache latents), რათა FLUX.1-dev-მა ალფ
იაპონური Stable Diffusion: კულტურულად მგრძნობიარე ტექსტიდან-გამოსახულების მოდელი
Stable Diffusion, მძლავრი ტექსტიდან-გამოსახულების გენერირების მოდელი, შესანიშნავად ქმნის სურათებს ინგლისური პრომპტების საფუძველზე, თუმცა ხშირად უჭირს არადასავლური კულტურული ნიუანსების გადმოცემა. ამ გამოწვევის საპასუხოდ, rinna Co., Ltd.-მ შექმნა „იაპონური Stable Diffusion“, ორიგინალური მოდელის დახვეწით (fine-tuning) იაპონურენოვანი წარწერების მქონე გამოსახულებებზე და იაპონურ სპეციფიკური ტექსტური ენკოდერის (text encoder) და ტოკენაიზერის (tokenizer) ინტეგრირებით. ეს ახალი მოდელი იგებს იაპონურ კულტურ