Wav2Vec2: გარღვევა მეტყველების ამოცნობაში მინიმალური მარკირებული მონაცემებით
Wav2Vec2, რევოლუციური ხელოვნური ინტელექტის მოდელი, სწავლობს მეტყველების მძლავრ წარმოდგენებს დიდი მოცულობის არამარკირებული აუდიო მონაცემებიდან, კონტრასტული წინასწარი ვარჯიშის ინოვაციური მეთოდის გამოყენებით. მან აჩვენა უპრეცედენტო შედეგები ავტომატური მეტყველების ამოცნობის (ASR) სფეროში, მიაღწია უმაღლეს დონეს მაშინაც კი, როდესაც დამატებითი ვარჯიში (fine-tuning) ხდება სულ რაღაც 10 წუთის მარკირებულ მეტყველების მონაცემებზე. ეს მას ქმნის მაღალეფექტურ გადაწყვეტილებად ძლიერი ASR სისტემების შესაქმნელად, რ
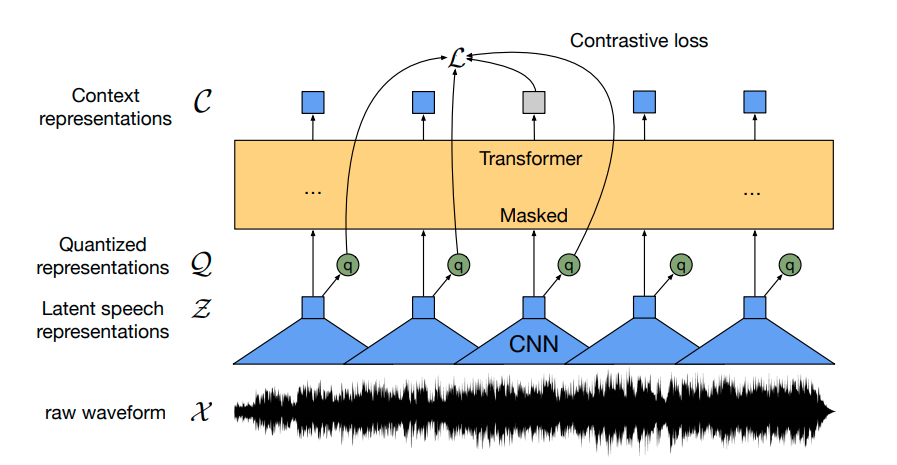
Wav2Vec2, კონტრასტული წინასწარი ვარჯიშის ინოვაციური მიზნის გამოყენებით, სწავლობს მეტყველების მძლავრ წარმოდგენებს 50 000 საათზე მეტი არამარკირებული მეტყველების მონაცემებიდან. BERT-ის ნიღბიანი ენის მოდელირების მსგავსად, მოდელი სწავლობს კონტექსტუალიზებულ მეტყველების წარმოდგენებს, შემთხვევით ნიღბავს მახასიათებელ ვექტორებს, სანამ მათ ტრანსფორმატორ ქსელს გადასცემს.
პირველად დადასტურდა, რომ წინასწარი ვარჯიში, რასაც მოჰყვება დამატებითი ვარჯიში (fine-tuning) ძალიან მცირე რაოდენობის მარკირებულ მეტყველების მონაცემებზე, კონკურენტუნარიან შედეგებს აღწევს უახლეს ASR სისტემებთან შედარებით. სულ რაღაც 10 წუთის მარკირებული მონაცემების გამოყენებით, Wav2Vec2-მა LibriSpeech-ის სუფთა სატესტო ნაკრებზე მიაღწია სიტყვების შეცდომის მაჩვენებელს (WER) 5%-ზე ნაკლებს.
ეს მიდგომა დეტალურად განმარტავს, თუ როგორ შეიძლება Wav2Vec2-ის წინასწარ ნავარჯიშები მოდელების ადაპტირება (fine-tuning) ნებისმიერ ინგლისურენოვან ASR მონაცემთა ნაკრებზე. აღსანიშნავია, რომ Wav2Vec2-ის დამატებითი ვარჯიში ხდება ენის მოდელის გარეშე. ენის მოდელის გარეშე Wav2Vec2-ის, როგორც ბოლომდე ინტეგრირებული ASR სისტემის გამოყენება გაცილებით მარტივია და დადასტურებულია, რომ Wav2Vec2-ის ავტონომიური აკუსტიკური მოდელი შთამბეჭდავ შედეგებს აჩვენებს. დემონსტრაციის მიზნით, "ბაზისური" ზომის წინასწარ ნავარჯიშები მოდელი დავამუშავეთ (fine-tuned) შედარებით მცირე Timit მონაცემთა ნაკრებზე, რომელიც მხოლოდ 5 საათიან სავარჯიშო მონაცემებს შეიცავს. Wav2Vec2-ის დამატებითი ვარჯიში ხდება Connectionist Temporal Classification (CTC) მეთოდის გამოყენებით, რომელიც არის ალგორითმი ნერვული ქსელების სავარჯიშოდ თანმიმდევრობა-თანმიმდევრობაზე დაფუძნებულ ამოცანებში, ძირითადად ავტომატურ მეტყველების ამოცნობასა და ხელწერის ამოცნობაში.
სისტემის გამართვისთვის საჭიროა შესაბამისი ბიბლიოთეკები აუდიო ფაილების ჩასატვირთად და მოდელის შეფასებისთვის სიტყვების შეცდომის მაჩვენებლის (WER) გამოყენებით. ასევე, რეკომენდებულია სავარჯიშო მოდელების (checkpoints) Hugging Face Hub-ზე ატვირთვა, რაც უზრუნველყოფს ვერსიების კონტროლს და ხელს უშლის მონაცემების დაკარგვას ვარჯიშის პროცესში.
აღსანიშნავია, რომ Timit მონაცემთა ნაკრები ჩვეულებრივ ფასდება ფონემების შეცდომის მაჩვენებლით (PER), თუმცა ASR-ში ყველაზე გავრცელებული მეტრიკა სიტყვების შეცდომის მაჩვენებელია (WER). ზოგადობის შესანარჩუნებლად, გადაწყდა მოდელის შეფასება WER-ის გამოყენებით.
ASR მოდელები მეტყველებას ტექსტად გარდაქმნიან, რაც ნიშნავს, რომ საჭიროა როგორც მახასიათებლების ექსტრაქტორი, რომელიც ამუშავებს მეტყველების სიგნალს მოდელის შეყვანის ფორმატში (მაგ., მახასიათებელ ვექტორად), ასევე ტოკენიზატორი, რომელიც მოდელის გამოსავალ ფორმატს ტექსტად გარდაქმნის. 🤗 Transformers-ში, Wav2Vec2 მოდელი წარმოდგენილია როგორც ტოკენიზატორით (Wav2Vec2CTCTokenizer), ასევე მახასიათებლების ექსტრაქტორით (Wav2Vec2FeatureExtractor).
წინასწარ ნავარჯიშები Wav2Vec2 მოდელი მეტყველების სიგნალს კონტექსტური წარმოდგენების თანმიმდევრობად აქცევს. დამატებით ნავარჯიშებ Wav2Vec2 მოდელს ეს თანმიმდევრობა შესაბამის ტრანსკრიფციად უნდა გადააქციოს, რისთვისაც ტრანსფორმატორ ბლოკს ემატება წრფივი შრე. ეს წრფივი შრე გამოიყენება თითოეული კონტექსტური წარმოდგენის ტოკენის კლასის განსასაზღვრად, ისევე როგორც, მაგალითად, BERT-ის ვარჯიშის შემდეგ ემატება წრფივი შრე შემდგომი კლასიფიკაციისთვის. ამ შრის გამოსავლის ზომა შეესაბამება ლექსიკონში არსებული ტოკენების რაოდენობას, რაც არ არის დამოკიდებული Wav2Vec2-ის წინასწარ სავარჯიშო ამოცანაზე, არამედ მხოლოდ მარკირებულ მონაცემთა ნაკრებზე, რომელიც გამოიყენება დამატებითი ვარჯიშისთვის (fine-tuning). პირველ რიგში, განვიხილავთ Timit-ის მონაცემებს და განვსაზღვრავთ ლექსიკონს ამ ნაკრების ტრანსკრიფციების საფუძველზე.
ASR მონაცემთა მრავალი ნაკრები მხოლოდ სამიზნე ტექსტს ('text') იძლევა თითოეული აუდიო ფაილისთვის ('file'). Timit-ი კი ბევრად მეტ ინფორმაციას გვთავაზობს, მაგალითად, 'ფონეტიკურ დეტალებს'. ამის გამო, ბევრი მკვლევარი Timit-ზე მუშაობისას, მოდელებს მეტყველების ამოცნობის ნაცვლად, ფონემების კლასიფიკაციაზე აფასებს. თუმცა, ზოგადი მიდგომის შესანარჩუნებლად, დამატებითი ვარჯიშისთვის მხოლოდ ტრანსკრიბირებულ ტექსტს განვიხილავთ.
ტრანსკრიფციები ძალიან სუფთად გამოიყურება და ენა უფრო წერილობით ტექსტს ჰგავს, ვიდრე დიალოგს. ეს ლოგიკურია, თუ გავითვალისწინებთ, რომ Timit არის წაკითხული მეტყველების კორპუსი. ვხედავთ, რომ ტრანსკრიფციები შეიცავს ზოგიერთ სპეციალურ სიმბოლოს, როგორიცაა ,.?!;:. ენის მოდელის გარეშე, ასეთი სპეციალური სიმბოლოების მქონე მეტყველების ნაწილების კლასიფიკაცია გაცილებით რთულია.
წყარო: huggingface.co
AI-ით გადამუშავებული
მსგავსი სტატიები

ხელოვნური ინტელექტი
Anthropic-ის Claude-ის აღზევება Apple App Store-ის რეიტინგებში პენტაგონთან მოლაპარაკებების ფონზე

ხელოვნური ინტელექტი
ტრამპის ადმინისტრაცია Anthropic-ს სანქციებს უწესებს ხელოვნური ინტელექტის გამოყენებაზე უარის გამო: ექსპერტი ინდუსტრიის უსაფრთხოების ხარვეზებზე საუბრობს
ხელოვნური ინტელექტი