MMS: ხელოვნური ინტელექტი მრავალენოვანი მეტყველების ამოცნობისა და გადაშენების პირას მყოფი ენების გადასარჩენად
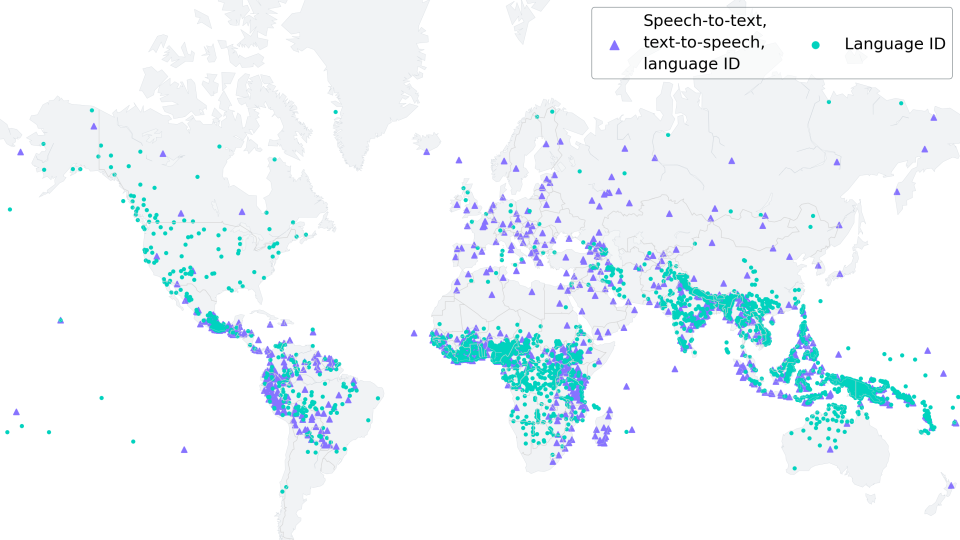
Meta AI-ის უახლესი მოდელი, Massive Multilingual Speech (MMS), რევოლუციას ახდენს მეტყველების ავტომატური ამოცნობის (ASR) სფეროში. მას შეუძლია 1,100-ზე მეტი ენის იდენტიფიცირება, ტრანსკრიფცია და გენერირება, მათ შორის გადაშენების პირას მყოფი ენებისაც. ადაპტერის გაწვრთნის ინოვაციური მეთოდის წყალობით, MMS აღწევს სიტყვების შეცდომის საოცრად დაბალ მაჩვენებლებს მინიმალური დამატებითი გაწვრთნით, რაც განსაკუთრებით ეფექტურია დაბალი რესურსების მქონე ენებისთვის. ეს ტექნოლოგია პოტენციურად გადამწყვეტ როლს ითამაშებ
Wav2Vec2: ახალი ეპოქა მეტყველების ავტომატურ ამოცნობაში
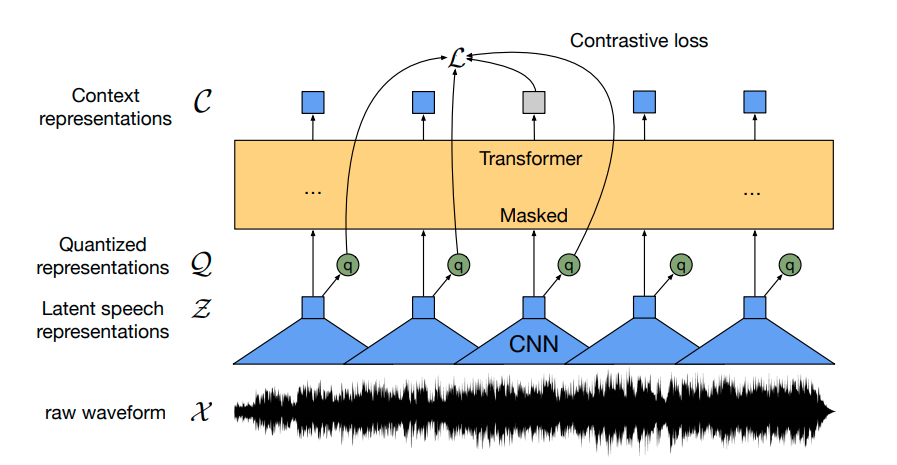
Wav2Vec2 წარმოადგენს ინოვაციურ მოდელს, რომელიც იყენებს კონტრასტულ წინასწარ წვრთნას 50 000 საათზე მეტი არადანიშნული მეტყველების მონაცემებიდან მძლავრი წარმოდგენების შესასწავლად. BERT-ის მსგავსად, ის ნიღბავს ფუნქციის ვექტორებს კონტექსტუალიზებული წარმოდგენების მისაღებად. მოდელმა აჩვენა კონკურენტული შედეგები თანამედროვე ავტომატური მეტყველების ამოცნობის (ASR) სისტემებთან, მინიმალური, სულ რაღაც 10 წუთის, დანიშნულ მონაცემებზე დამატებითი წვრთნის შემდეგ. ეს სტატია დეტალურად განმარტავს Wav2Vec2-ის წინასწარ
Wav2Vec2: გარღვევა მეტყველების ამოცნობაში მინიმალური მარკირებული მონაცემებით
Wav2Vec2, რევოლუციური ხელოვნური ინტელექტის მოდელი, სწავლობს მეტყველების მძლავრ წარმოდგენებს დიდი მოცულობის არამარკირებული აუდიო მონაცემებიდან, კონტრასტული წინასწარი ვარჯიშის ინოვაციური მეთოდის გამოყენებით. მან აჩვენა უპრეცედენტო შედეგები ავტომატური მეტყველების ამოცნობის (ASR) სფეროში, მიაღწია უმაღლეს დონეს მაშინაც კი, როდესაც დამატებითი ვარჯიში (fine-tuning) ხდება სულ რაღაც 10 წუთის მარკირებულ მეტყველების მონაცემებზე. ეს მას ქმნის მაღალეფექტურ გადაწყვეტილებად ძლიერი ASR სისტემების შესაქმნელად, რ
Wav2Vec2 და XLS-R: გარღვევა მეტყველების ავტომატური ამოცნობის ტექნოლოგიაში
2020 წელს გამოშვებული Wav2Vec2 მოდელიდან დაწყებული, Facebook AI-ის მრავალენოვანი XLSR ვერსიის გავლით, 2021 წლის ნოემბერში წარმოდგენილი XLS-R წარმოადგენს მნიშვნელოვან მიღწევას მეტყველების ავტომატური ამოცნობის (ASR) სფეროში. XLS-R, რომელიც გაწვრთნილია 128 ენაზე ნახევარ მილიონ საათამდე აუდიო მონაცემზე, უზრუნველყოფს კონტექსტუალიზებულ მეტყველების წარმოდგენებს და აჩვენებს შთამბეჭდავ გაუმჯობესებას მეტყველების ამოცნობის, თარგმანისა და ენის იდენტიფიკაციის ამოცანებში. სტატია დეტალურად განმარტავს ამ მოდელე

Hugging Face-ის ინფერენსის საბოლოო წერტილები: Whisper მოდელების საოცარი ოპტიმიზაცია საზოგადოებისთვის
Hugging Face ხსნის თავის ინფერენსის საბოლოო წერტილებს (Inference Endpoints) საზოგადოებისთვის, რაც ხელს უწყობს ღია კოდის წვლილს და AI მოდელების ოპტიმიზებულ განთავსებას. ახალი Whisper-ის საბოლოო წერტილი, vLLM პროექტის გამოყენებით, აჩვენებს თითქმის 8-ჯერ გაუმჯობესებას RTFx-ში, ტრანსკრიფციის ხარისხის დაკარგვის გარეშე. პლატფორმა ასევე გთავაზობთ მოწინავე ოპტიმიზაციებს NVIDIA GPU-ებზე და საშუალებას აძლევს მომხმარებლებს, მარტივად განათავსონ საკუთარი ASR კონვეიერები.
MetaAI-ის Wav2Vec2-BERT: გაუმჯობესებული მეტყველების ამოცნობა დაბალრესურსიან ენებზე
MetaAI-მ გამოუშვა Wav2Vec2-BERT, ხელოვნური ინტელექტის მოდელი მეტყველების ავტომატური ამოცნობისთვის (ASR), რომელიც Seamless Communication-ის ნაწილია. ორიგინალური Wav2Vec2-ის გაუმჯობესებული ვერსია, Wav2Vec2-BERT, გაწვრთნილია 4.5 მილიონ საათზე მეტ აუდიო მონაცემზე 143-ზე მეტ ენაზე. ის მნიშვნელოვნად აღემატება Whisper-ის მოდელს სიჩქარითა და რესურსების ეფექტურობით, განსაკუთრებით დაბალრესურსიან ენებზე, როგორიცაა მონღოლური, სადაც Whisper-ი დაბალ შედეგებს აჩვენებს. Wav2Vec2-BERT-ს შეუძლია მიაღწიოს კონკურენ

მეტყველების ამოცნობის (ASR) და დიარიზაციის პაიპლაინების დაყენება Hugging Face Inference Endpoints-ზე სპეკულაციური დეკოდირებით
ეს სტატია განმარტავს, თუ როგორ ხდება მეტყველების ავტომატური ამოცნობის (ASR), დიარიზაციისა და სპეკულაციური დეკოდირების მოდულარული პაიპლაინების კონფიგურაცია Hugging Face Inference Endpoints-ის გამოყენებით. ის დეტალურად აღწერს Pyannote მოდელის ინტეგრაციას დიარიზაციისთვის, Flash Attention 2-ის გამოყენებას და ინფერენსის დაჩქარების ტექნიკებს, ასევე კონფიგურაციის მოქნილობას და წარმადობის გაუმჯობესებას სხვადასხვა აუდიო სიგრძისთვის.