MMS: ხელოვნური ინტელექტი მრავალენოვანი მეტყველების ამოცნობისა და გადაშენების პირას მყოფი ენების გადასარჩენად
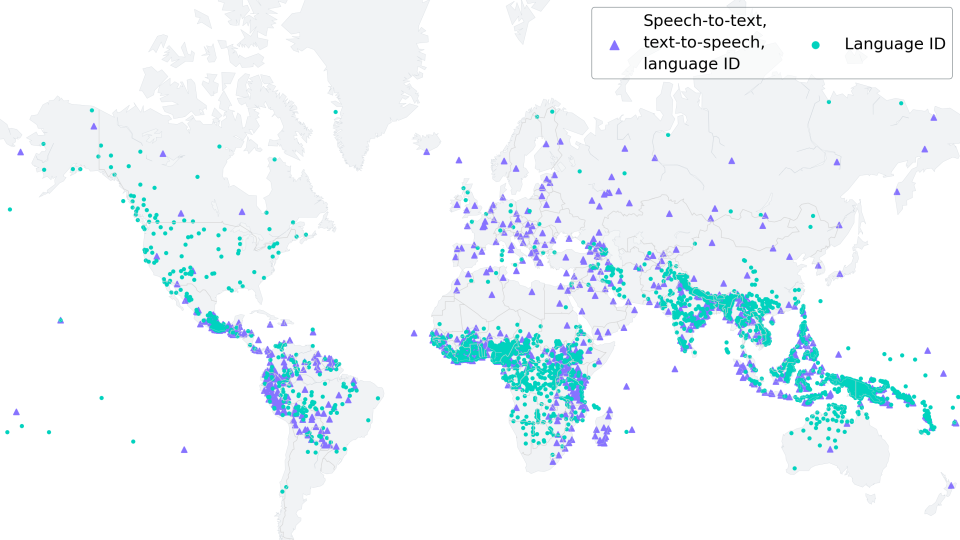
Meta AI-ის უახლესი მოდელი, Massive Multilingual Speech (MMS), რევოლუციას ახდენს მეტყველების ავტომატური ამოცნობის (ASR) სფეროში. მას შეუძლია 1,100-ზე მეტი ენის იდენტიფიცირება, ტრანსკრიფცია და გენერირება, მათ შორის გადაშენების პირას მყოფი ენებისაც. ადაპტერის გაწვრთნის ინოვაციური მეთოდის წყალობით, MMS აღწევს სიტყვების შეცდომის საოცრად დაბალ მაჩვენებლებს მინიმალური დამატებითი გაწვრთნით, რაც განსაკუთრებით ეფექტურია დაბალი რესურსების მქონე ენებისთვის. ეს ტექნოლოგია პოტენციურად გადამწყვეტ როლს ითამაშებ
Wav2Vec2 არის წინასწარ გაწვრთნილი მოდელი მეტყველების ავტომატური ამოცნობისთვის (ASR), რომელიც 2020 წლის სექტემბერში ალექსეი ბაევსკიმ, მაიკლ აულიმ და ალექს კონომ გამოუშვეს. მას შემდეგ, რაც Wav2Vec2-ის შთამბეჭდავი შესაძლებლობები გამოვლინდა ASR-ისთვის ერთ-ერთ ყველაზე პოპულარულ ინგლისურ მონაცემთა ნაკრებზე, LibriSpeech-ზე, Facebook AI-მ წარმოადგინა Wav2Vec2-ის ორი მრავალენოვანი ვერსია, სახელწოდებით XLSR და XLM-R, რომლებსაც 128-მდე ენაზე მეტყველების ამოცნობა შეეძლოთ. XLSR ნიშნავს ჯვარედინი-ენობრივ მეტყველების წარმოდგენებს და მიუთითებს მოდელის უნარზე, ისწავლოს მეტყველების ისეთი წარმოდგენები, რომლებიც გამოსადეგია მრავალ ენაზე.
Meta AI-ის უახლესი გამოცემა, მასიური მრავალენოვანი მეტყველება (MMS), შექმნილია ვინელ პრატაპის, ანდროს ტჯანდრას, ბოუენ შის და სხვათა მიერ, მრავალენოვანი მეტყველების წარმოდგენებს ახალ დონეზე აჰყავს. 1,100-ზე მეტი სალაპარაკო ენის იდენტიფიცირება, ტრანსკრიფცია და გენერირება შესაძლებელია გამოშვებული ენის იდენტიფიკაციის, მეტყველების ამოცნობისა და ტექსტი-მეტყველების სხვადასხვა მოდელების გამოყენებით. ამ სტატიაში ჩვენ ვაჩვენებთ, თუ როგორ აღწევს MMS-ის ადაპტერის გაწვრთნა საოცრად დაბალ სიტყვების შეცდომის მაჩვენებლებს სულ რაღაც 10-20 წუთიანი დამატებითი გაწვრთნის შემდეგ. დაბალი რესურსების მქონე ენებისთვის, ჩვენ მკაცრად გირჩევთ MMS-ის ადაპტერის გაწვრთნის გამოყენებას, მთლიანი მოდელის დამატებითი გაწვრთნის ნაცვლად, როგორც ეს ხდება "Fine-tuning XLS-R on Multi-Lingual ASR"-ში. ჩვენს ექსპერიმენტებში, MMS-ის ადაპტერის გაწვრთნა არის როგორც მეტად მეხსიერების ეფექტური, ასევე უფრო მყარი და უკეთეს შედეგებს იძლევა დაბალი რესურსების მქონე ენებისთვის. თუმცა, საშუალო და მაღალი რესურსების მქონე ენებისთვის შეიძლება მაინც სასარგებლო იყოს მთლიანი მოდელის დამატებითი გაწვრთნა ადაპტერის ფენების გამოყენების ნაცვლად.
Ethnologue.com-ის თანახმად, დაახლოებით 3000, ანუ ყველა "ცოცხალი" ენის 40%, გადაშენების პირას იმყოფება მშობლიურ ენაზე მოლაპარაკეთა რაოდენობის შემცირების გამო. ეს ტენდენცია მხოლოდ გაგრძელდება მზარდ გლობალიზებულ სამყაროში. MMS-ს შეუძლია მრავალი გადაშენების პირას მყოფი ენის ტრანსკრიფცია, როგორიცაა არი ან კაივი. მომავალში, MMS-მა შეიძლება სასიცოცხლო როლი ითამაშოს ენების გადარჩენაში, დარჩენილ მოსაუბრეებს დაეხმაროს წერილობითი ჩანაწერების შექმნასა და მშობლიურ ენაზე კომუნიკაციაში.
1000-ზე მეტ სხვადასხვა ლექსიკონთან ადაპტირებისთვის, MMS იყენებს ადაპტერებს - გაწვრთნის მეთოდს, რომლის დროსაც მოდელის წონების მხოლოდ მცირე ნაწილი განიცდის გაწვრთნას. ადაპტერის ფენები ენობრივი ხიდების როლს ასრულებენ, რაც მოდელს საშუალებას აძლევს, გამოიყენოს ერთი ენიდან მიღებული ცოდნა მეორის გაშიფვრისას. MMS-ის ზედამხედველობის გარეშე გაწვრთნილი მოდელები (checkpoints) წინასწარ იყო გაწვრთნილი ნახევარ მილიონ საათზე მეტ აუდიო მასალაზე 1,400-ზე მეტ ენაზე, 300 მილიონიდან ერთ მილიარდ პარამეტრამდე დიაპაზონში. წინასწარ გაწვრთნილი მოდელები შეგიძლიათ იპოვოთ 🤗 Hub-ზე 300 მილიონი (300M) და ერთი მილიარდი (1B) პარამეტრის ზომის მოდელებისთვის. შენიშვნა: თუ გსურთ ძირითადი მოდელების დამატებითი გაწვრთნა, ამის გაკეთება შეგიძლიათ ზუსტად ისევე, როგორც ნაჩვენებია "Fine-tuning XLS-R on Multi-Lingual ASR"-ში.
BERT-ის ნიღბიანი ენის მოდელირების ამოცანის მსგავსად, MMS სწავლობს კონტექსტუალიზებულ მეტყველების წარმოდგენებს შემთხვევითი შერჩევითი ვექტორების დაფარვით, სანამ მათ თვით-ზედამხედველობითი წინასწარი გაწვრთნის დროს ტრანსფორმერ ქსელში გაატარებს. ASR-ისთვის, წინასწარ გაწვრთნილი MMS-1B მოდელი შემდგომში ზედამხედველობითი წესით დამატებით გაიწვრთნა 1000-ზე მეტ ენაზე საერთო ლექსიკონის გამომავალი ფენით. საბოლოო ნაბიჯად, საერთო ლექსიკონის გამომავალი ფენა მოცილებული იქნა და მის ნაცვლად ენის სპეციფიკური ადაპტერის ფენები იქნა გამოყენებული. თითოეული ადაპტერის ფენა შეიცავს მხოლოდ დაახლოებით 2.5 მილიონ წონას, რომელიც შედგება მცირე წრფივი პროექციის ფენებისგან თითოეული ყურადღების ბლოკისთვის, ასევე ენის სპეციფიკური ლექსიკონის გამომავალი ფენისგან. მეტყველების ამოცნობისთვის (ASR) დამატებით გაწვრთნილი სამი MMS მოდელი (checkpoints) გამოვიდა. ისინი მოიცავს შესაბამისად 102, 1107 და 1162 ადაპტერის წონას (თითოეული ენისთვის): ხედავთ, რომ ძირითადი მოდელები ინახება (ჩვეულებისამებრ) როგორც model.safetensors ფაილი, მაგრამ გარდა ამისა, ეს რეპოზიტორიები შეიცავს უამრავ ადაპტერის წონას, მაგალითად, adapter.fra.safetensors სახელწოდებით ფრანგული ენისთვის. Hugging Face-ის დოკუმენტაცია ძალიან კარგად ხსნის, თუ როგორ შეიძლება ასეთი მოდელების (checkpoints) გამოყენება ინფერენციისთვის, ამიტომ ამ სტატიაში ჩვენ ყურადღებას გავამახვილებთ იმაზე, თუ როგორ შეგვიძლია ეფექტურად გავწვრთნათ მაღალეფექტური ადაპტერის მოდელები ნებისმიერი გამოშვებული ASR მოდელის საფუძველზე.
მანქანურ სწავლებაში, ადაპტერები არის მეთოდი, რომელიც გამოიყენება წინასწარ გაწვრთნილი მოდელების დასაზუსტებლად, ორიგინალური მოდელის პარამეტრების შეუცვლელად. ისინი ამას აკეთებენ მოდელის არსებულ ფენებს შორის მცირე, გაწვრთნადი მოდულების, ე.წ. ადაპტერის ფენების ჩასმით, რომლებიც შემდეგ მოდელს კონკრეტულ ამოცანაზე აწყობენ ფართო გადაწვრთნის საჭიროების გარეშე. ადაპტერებს დიდი ისტორია აქვთ მეტყველების ამოცნობაში და განსაკუთრებით მოსაუბრის ამოცნობაში. მოსაუბრის ამოცნობაში, ადაპტერები ეფექტურად გამოიყენებოდა არსებული მოდელების დასაზუსტებლად ინდივიდუალური მოსაუბრის თავისებურებების ამოსაცნობად, როგორც ეს ხაზგასმულია გეილსისა და ვუდლენდის (1996) და მიაოს და სხვების (2014) ნაშრომებში. ეს მიდგომა არა მხოლოდ მნიშვნელოვნად ამცირებს გამოთვლით მოთხოვნებს მთლიანი მოდელის გაწვრთნასთან შედარებით, არამედ იძლევა უკეთეს და მოქნილ, მოსაუბრეზე ორიენტირებულ კორექტირებებს. MMS-ში შესრულებული სამუშაო იყენებს ადაპტერების ამ იდეას სხვადასხვა ენაზე მეტყველების ამოცნობისთვის. ადაპტერის წონების მცირე რაოდენობა...
თეგები:
#მრავალენოვანი
#მეტყველების ამოცნობა
#asr
#meta ai
#ადაპტერები
#wav2vec2
#mms
#გადაშენების პირას მყოფი ენები
#ენები
#xlsr
წყარო: huggingface.co
AI-ით გადამუშავებული
მსგავსი სტატიები

ხელოვნური ინტელექტი
Anthropic-ის Claude-ის აღზევება Apple App Store-ის რეიტინგებში პენტაგონთან მოლაპარაკებების ფონზე

ხელოვნური ინტელექტი
ტრამპის ადმინისტრაცია Anthropic-ს სანქციებს უწესებს ხელოვნური ინტელექტის გამოყენებაზე უარის გამო: ექსპერტი ინდუსტრიის უსაფრთხოების ხარვეზებზე საუბრობს
ხელოვნური ინტელექტი