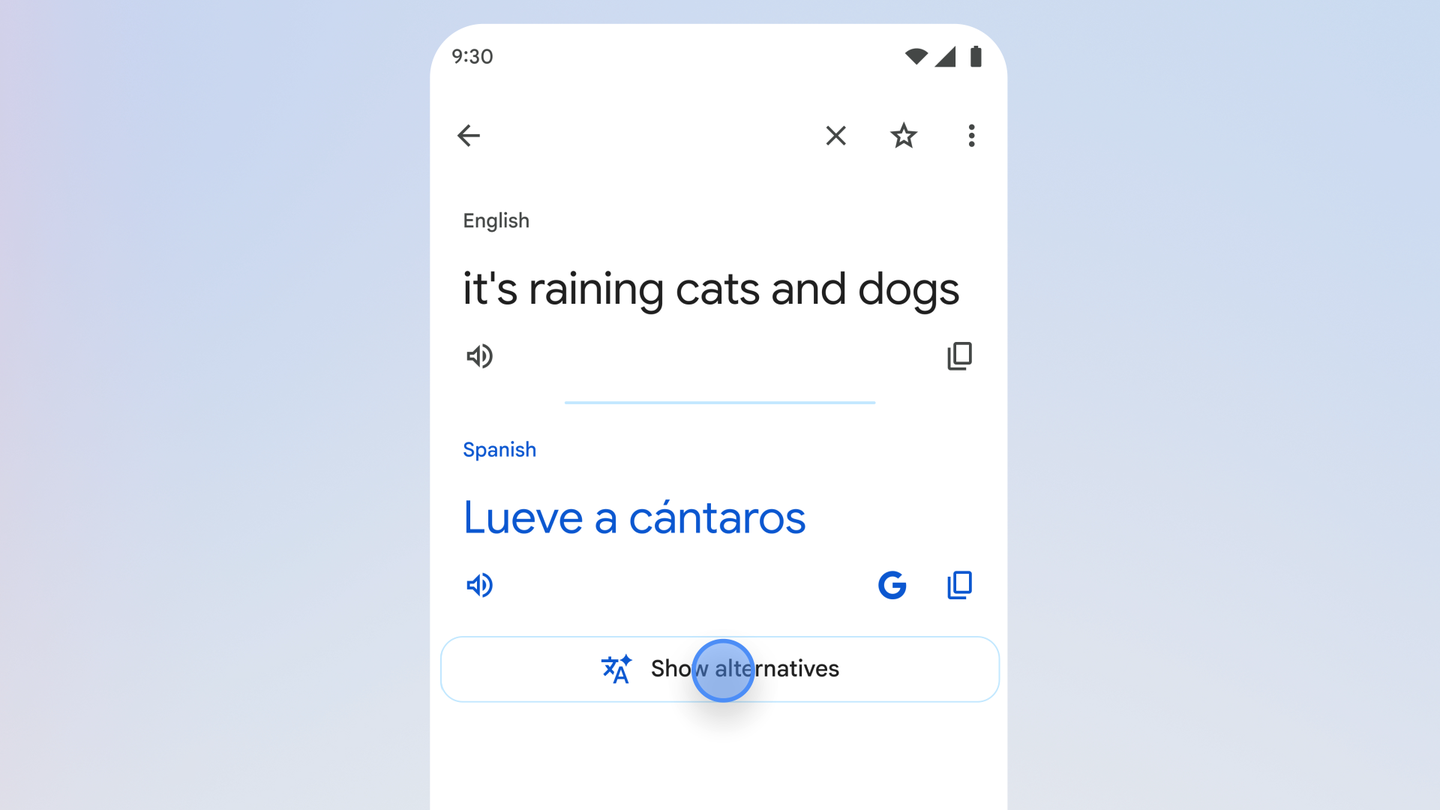
Google Translate-ში ხელოვნური ინტელექტის ახალი ფუნქციები: სწორი ტონისა და ფრაზების შერჩევა გამარტივდა
Google Translate-მა წარმოადგინა ახალი, AI-ზე დაფუძნებული ფუნქციები, რომლებიც Gemini-ის მრავალენოვანი შესაძლებლობებით სარგებლობს. ეს სიახლეები მომხმარებლებს საშუალებას აძლევს, ნებისმიერ საუბარში – არაფორმალური შეხვედრებიდან პროფესიულ შეხვედრებამდე – სწორი ტონი შეარჩიონ. ინსტრუმენტი გთავაზობთ ალტერნატიულ ფრაზებს, რაც განსაკუთრებით სასარგებლოა იდიომებისა და კოლოქვიალური გამოთქმების თარგმნისას, და მოიცავს განმარტებებს თითოეული ვარიანტის ნიუანსების შესახებ. ფუნქციები უკვე ხელმისაწვდომია აშშ-სა და ინდ

Cohere-მ მრავალენოვანი ხელოვნური ინტელექტის მოდელები „Tiny Aya“ გამოუშვა, რომლებიც ოფლაინ რეჟიმში იმუშავებს
საწარმოო ხელოვნური ინტელექტის კომპანია Cohere-მ, ინდოეთის ხელოვნური ინტელექტის სამიტის ფარგლებში, მრავალენოვანი მოდელების ახალი ოჯახი, სახელწოდებით „Tiny Aya“ წარადგინა. ეს ღია წონის მოდელები 70-ზე მეტ ენას უჭერს მხარს, შეუძლიათ ყოველდღიურ მოწყობილობებზე ინტერნეტის გარეშე მუშაობა და განკუთვნილია მკვლევრებისა და დეველოპერებისთვის, რათა შექმნან აპლიკაციები მშობლიურ ენაზე მოსაუბრე აუდიტორიისთვის, განსაკუთრებით ინდოეთის მსგავს მრავალენოვან რეგიონებში.
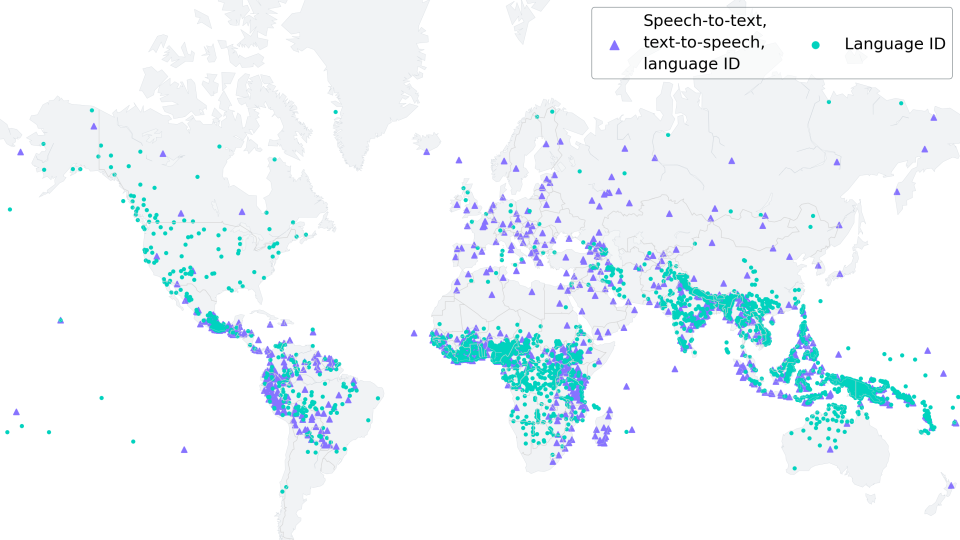
MMS: ხელოვნური ინტელექტი მრავალენოვანი მეტყველების ამოცნობისა და გადაშენების პირას მყოფი ენების გადასარჩენად
Meta AI-ის უახლესი მოდელი, Massive Multilingual Speech (MMS), რევოლუციას ახდენს მეტყველების ავტომატური ამოცნობის (ASR) სფეროში. მას შეუძლია 1,100-ზე მეტი ენის იდენტიფიცირება, ტრანსკრიფცია და გენერირება, მათ შორის გადაშენების პირას მყოფი ენებისაც. ადაპტერის გაწვრთნის ინოვაციური მეთოდის წყალობით, MMS აღწევს სიტყვების შეცდომის საოცრად დაბალ მაჩვენებლებს მინიმალური დამატებითი გაწვრთნით, რაც განსაკუთრებით ეფექტურია დაბალი რესურსების მქონე ენებისთვის. ეს ტექნოლოგია პოტენციურად გადამწყვეტ როლს ითამაშებ
vdr-2b-multi-v1: მრავალენოვანი ჩაშენების მოდელი ვიზუალური დოკუმენტების ეფექტური მოძიებისთვის
Hugging Face-ის მიერ წარდგენილია vdr-2b-multi-v1, მრავალენოვანი ჩაშენების მოდელი, რომელიც განკუთვნილია ვიზუალური დოკუმენტების მოძიებისთვის სხვადასხვა ენასა და დომენში. ეს მოდელი აკოდირებს დოკუმენტის გვერდის სქრინშოტებს მკვრივ ერთვექტორულ წარმოდგენებად, რაც შესაძლებელს ხდის ვიზუალურად მდიდარი მრავალენოვანი დოკუმენტების ძიებას და მოთხოვნას OCR-ის, მონაცემთა ამოღების კონვეიერების ან დანაწილების გარეშე. იგი აგებულია MrLight/dse-qwen2-2b-mrl-v1-ზე და გაწვრთნილია ვრცელ, თვითშექმნილ მონაცემთა ბაზაზე. L

Google-მა SigLIP 2 გამოუშვა: მრავალენოვანი ვიზუალურ-ლინგვისტური ენკოდერების ახალი, გაუმჯობესებული თაობა
Google-მა წარმოადგინა SigLIP 2, მრავალენოვანი ვიზუალურ-ლინგვისტური ენკოდერების ოჯახის ახალი თაობა. გაფართოებული სწავლების მიზნების წყალობით, რომელიც აუმჯობესებს სემანტიკურ გაგებას, ლოკალიზაციასა და მკვრივ მახასიათებლებს, SigLIP 2 მოდელები მნიშვნელოვნად აღემატება წინამორბედ SigLIP-ს ისეთ ძირითად შესაძლებლობებში, როგორიცაა ნულოვანი კადრის კლასიფიკაცია და გამოსახულება-ტექსტის მოძიება. სიახლეს წარმოადგენს დინამიური რეზოლუციის (naflex) ვარიანტი, რაც მას უფრო მრავალმხრივს ხდის.
Wav2Vec2 და XLS-R: გარღვევა მეტყველების ავტომატური ამოცნობის ტექნოლოგიაში
2020 წელს გამოშვებული Wav2Vec2 მოდელიდან დაწყებული, Facebook AI-ის მრავალენოვანი XLSR ვერსიის გავლით, 2021 წლის ნოემბერში წარმოდგენილი XLS-R წარმოადგენს მნიშვნელოვან მიღწევას მეტყველების ავტომატური ამოცნობის (ASR) სფეროში. XLS-R, რომელიც გაწვრთნილია 128 ენაზე ნახევარ მილიონ საათამდე აუდიო მონაცემზე, უზრუნველყოფს კონტექსტუალიზებულ მეტყველების წარმოდგენებს და აჩვენებს შთამბეჭდავ გაუმჯობესებას მეტყველების ამოცნობის, თარგმანისა და ენის იდენტიფიკაციის ამოცანებში. სტატია დეტალურად განმარტავს ამ მოდელე

Visual Salamandra: ახალი თაობის მულტიმოდალური AI ევროპული ენების აქცენტით
ენის ტექნოლოგიების ლაბორატორიამ წარმოადგინა Visual Salamandra, ინოვაციური მულტიმოდალური AI მოდელი, რომელიც აერთიანებს Google-ის SigLIP ენკოდერს Salamandra Instructed 7B მოდელთან. ეს სისტემა შექმნილია ვიზუალურ და ტექსტურ მონაცემებს შორის ხარვეზის შესავსებად, რის შედეგადაც მას შეუძლია გაიგოს და შექმნას კონტექსტურად ზუსტი პასუხები მრავალფეროვანი შეყვანის საფუძველზე, მათ შორის სურათებიდან, ვიდეოებიდან და ტექსტური ინსტრუქციებიდან. Visual Salamandra გამოირჩევა მრავალენოვანი ინკლუზიურობით, განსაკუთრები

Falcon-Arabic: ტექნოლოგიური ინსტიტუტის ახალი ენის მოდელი არაბული ხელოვნური ინტელექტის საზღვრებს ცვლის
არაბთა გაერთიანებული საამიროების ტექნოლოგიური ინოვაციების ინსტიტუტმა (TII) წარმოადგინა Falcon-Arabic, 7 მილიარდი პარამეტრის მრავალენოვანი ენის მოდელი, რომელიც ახალ სტანდარტებს ადგენს არაბული ბუნებრივი ენის დამუშავებისთვის (NLP). Falcon 3 არქიტექტურაზე აგებული, Falcon-Arabic მნიშვნელოვნად აღემატება არსებულ არაბულ LLM-ებს ეფექტურობითა და შესაძლებლობებით, რაც ხელს უწყობს არაბულენოვანი საზოგადოებების სრულ ინტეგრაციას ხელოვნური ინტელექტის რევოლუციაში და უზრუნველყოფს უფრო ბუნებრივ, ინტელექტუალურ და ინ
BLOOM: წარდგენილია მსოფლიოში პირველი გამჭვირვალე, მრავალენოვანი დიდი ენობრივი მოდელი (LLM)
დიდი ენობრივი მოდელები (LLM) რევოლუციას ახდენენ ხელოვნური ინტელექტის კვლევებში, თუმცა მათზე სრული წვდომა მხოლოდ შეზღუდულ ინდუსტრიულ ლაბორატორიებს აქვთ. ამ სტატუს კვოს შესაცვლელად წარმოდგენილია BLOOM – პირველი მრავალენოვანი LLM, რომელიც სრული გამჭვირვალობით გაიარა ტრენინგი. 176 მილიარდი პარამეტრით, BLOOM-ს შეუძლია ტექსტის გენერირება 46 ბუნებრივ და 13 პროგრამირების ენაზე. ეს არის AI მკვლევართა ყველაზე მასშტაბური თანამშრომლობის შედეგი, რაც მოდელს ხელმისაწვდომს ხდის ფართო სამეცნიერო საზოგადოებისთვის
BLOOM: 176 მილიარდი პარამეტრის მოდელის შექმნის საინჟინრო მიღწევები და ტექნოლოგიები
პროექტი, რომელიც Hugging Face-ის თანადამფუძნებელმა თომას ვოლფმა წამოიწყო, მიზნად ისახავდა ერთ-ერთი უდიდესი მრავალენოვანი მოდელის შექმნას და მის ხელმისაწვდომობას ყველასთვის. ეს სტატია ფოკუსირებულია 176 მილიარდი პარამეტრის BLOOM მოდელის წვრთნის საინჟინრო ასპექტებზე, ხაზს უსვამს ექსპერტებისა და კომპანიების ერთობლივ ძალისხმევას. განხილულია ფრანგული სუპერკომპიუტერის Jean Zay გამოყენება და მოწინავე Megatron-DeepSpeed ფრეიმვორკი, რომელიც 3D პარალელიზმს იყენებს ეფექტური წვრთნისთვის.
SetFit: ეფექტური ჩარჩო Sentence Transformers-ის მცირემონაცემიან პირობებში დაზუსტებისთვის
Hugging Face, Intel Labs-თან და UKP Lab-თან პარტნიორობით, წარმოგიდგენთ SetFit-ს – ინოვაციურ ჩარჩოს Sentence Transformers-ის მცირემონაცემიან პირობებში ეფექტური დაზუსტებისთვის. SetFit აღწევს მაღალ სიზუსტეს მინიმალური მარკირებული მონაცემებით, არის სწრაფი საწვრთნელად, მრავალენოვანი და არ საჭიროებს პრომპტებს, რაც მას კონკურენტუნარიანს ხდის გაცილებით დიდ მოდელებთან შედარებით და მნიშვნელოვნად ამცირებს ღირებულებას. ის მდგრადია ხმაურის მიმართ და მნიშვნელოვნად უფრო ეფექტურად იყენებს მონაცემებს, ვიდრე სტან

mmBERT: ახალი მასობრივად მრავალენოვანი AI მოდელი რეკორდული წარმადობით
mmBERT არის უახლესი მასობრივად მრავალენოვანი ენკოდერი მოდელი, რომელიც გაწვრთნილია 1800-ზე მეტ ენაზე 3 ტრილიონზე მეტი ტოკენის გამოყენებით. ის წინა მრავალენოვან მოდელებთან შედარებით აჩვენებს მნიშვნელოვან წარმადობისა და სიჩქარის გაუმჯობესებას, პირველია, ვინც XLM-R-ს გადააჭარბა და ამავდროულად შეიმუშავა ეფექტური სტრატეგიები ნაკლებად რესურსული ენების შესასწავლად. მოდელი აგებულია ModernBERT-ის არქიტექტურაზე და მოიცავს ინოვაციურ კომპონენტებს ეფექტური მრავალენოვანი სწავლისთვის.

მონაცემთა ნაკრებების შექმნა: საზოგადოების ძალისხმევა და მრავალენოვანი ინიციატივები Hugging Face-ისგან
სტატია აღწერს Hugging Face-ის საზოგადოების მიერ მონაცემთა ნაკრებების შექმნის მიზნით გაწეულ ძალისხმევას. ინიციატივა მოიცავს მოთხოვნების (prompts) რანჟირების პროექტსა და მრავალენოვანი მოთხოვნების შეფასების პროექტს (MPEP), რომელიც მიზნად ისახავს ღია LLM-ებისთვის ენობრივი ბენჩმარკების გაუმჯობესებას. ხაზგასმულია საზოგადოების წვლილის მნიშვნელობა მყარი და ყოვლისმომცველი რესურსების შესაქმნელად.

NVIDIA-ს Nemotron-Personas-India: მონაცემთა უნიკალური ბაზა ინდოეთის მრავალენოვანი AI სისტემებისთვის
ინდოეთი, 700 მილიონზე მეტი ინტერნეტ მომხმარებლით და მრავალი ენით, ხელოვნური ინტელექტის (AI) უზარმაზარ შესაძლებლობებს გვთავაზობს. თუმცა, არსებული მონაცემთა ბაზები ხშირად დასავლურ ნორმებსა და ინგლისურენოვან კონტექსტს ასახავს, რაც ზღუდავს AI-ის ადაპტაციას ინდოეთის მრავალენოვან და მრავალ-წერილობით გარემოში. ამ პრობლემის გადასაჭრელად, NVIDIA-მ გამოუშვა Nemotron-Personas-India — პირველი ღია სინთეზური მონაცემთა ბაზა, რომელიც ინდური პერსონების დემოგრაფიულ, გეოგრაფიულ და კულტურულ მახასიათებლებს ასახავს.